Argon 是什么来头:从 3.5 Pro 取消到 4 Argon
Google 这回给模型改了命名法,直接跳过一堆中间版本,端出 Gemini 4 Argon,定位是「前沿智能的新纪元」,专门为了「在复杂、长周期的工作流里做深度推理」而生。背景是之前 Gemini 3.5 Pro 被取消、重心转到 3.8 Flash 之后的一次重新集结。Google 想用 Argon 在编程、知识工作、网络安全防御和创意写作这几个方向上,把「前沿级能力」一次性给齐。
对普通用户来说,名字怎么变不重要,重要的是它到底能干什么、比上一代强在哪。一句话先说结论:这次重点不是「更会聊天」,而是「能想得更久、干得更长」。
最硬的参数:100 万 token 的输出上限
Argon 把单次输出的 token 上限从 6.4 万直接拉到 100 万。这是什么概念?意味着它可以一口气生成几十万 token 的内容,跑很长的推理轨迹,去啃那种「一步想不透、得连推好几步」的硬骨头问题。配合扩展后的编程、推理和多模态能力,Google 的说法是:当模型有头空间深度思考、一次生成几十万 token,解决复杂问题的深度就上了一个台阶。
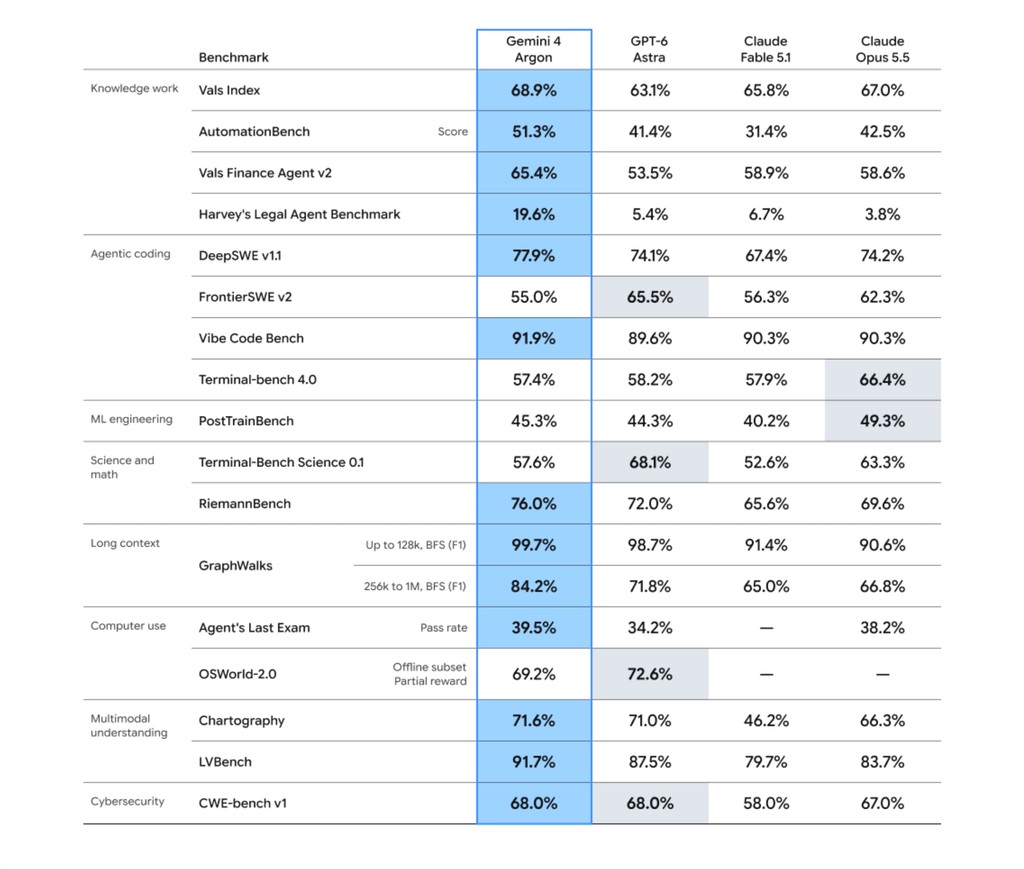
在跑分上,Google 拿出的数字挺能打:DeepSWE v1.1 上 Argon 拿到 77.9%,而 Claude Opus 5.5 是 74.2%、GPT-6 Astra 是 74.1%;网络安全修复的 CWE-bench v1 上它和榜首并列第一(68%);Zapier 的 AutomationBench 端到端执行它排第一(51.3%);长视频理解 LVBench 上 91.7% 是 state of the art。金融和法律这类垂直基准也都有领先表现。
一个争议点:无护栏开放给「防守方」
Argon 有个挺出格的设计:Google 把它「不带网络护栏」地开放给受信任的防守方和内部团队,让他们能用满这套前沿级的网络安全防御能力。这背后的逻辑是——防守方越强,越能挡住坏人。但风险也明摆着:能力一旦外溢,被滥用的代价很高。
所以 Google 同时堆了几道防线:监控模型内部激活来发现滥用、把间接提示注入(prompt injection)抗性做到目前最 resilient、把高风险训练/评估环境提前隔离封死、并部署对齐监控在必要时叫停执行。说白了,能力放开一步,护栏就得跟上一步,这中间的平衡会是这类前沿模型长期的主题。
价格和怎么用上:Ultra 用户和付费 API 先吃
Argon 先从 Google AI Ultra 订阅用户和付费 API 客户开始推送。价格上,介绍期输入每百万 token 2 美元、输出 10 美元,缓存输入再打 95 折;介绍期过了之后,涨到输入 4 美元、输出 20 美元每百万 token。对开发者来说,介绍期窗口值得抓住,毕竟一倍的差价不算小。
在 Google 内部,Argon 已经在上千名员工的真实工作流里跑起来了:有团队用它分析全机群的性能遥测、自动找出并落地内存优化,腾出 300 TiB 以上的内存;还有团队拿它把 C/C++ 代码库往 Rust 迁,从 re2、libgav1 这种核心库,一路干到 Fuchsia 的 Zircon 内核、规模冲到 80 万行以上。这些例子说明,前沿模型已经不只是「写写文案」,而是真在啃基础设施级的硬活。
放在大模型竞赛里看,Argon 意味着什么
把视野拉到整个赛道:Anthropic、OpenAI、Google 三家现在是你追我赶,每一代都在「更长上下文 + 更深推理 + 更专基准」上加码。Argon 这代最鲜明的标签是「为长链路任务而生」——它不跟你比谁回得快,而是比谁能把一件复杂的事从头到尾想透做完。对依赖 AI 写代码、做研究、跑自动化的团队来说,这种能力是真金白银的生产力。
当然,跑分归跑分,真实世界用起来「会不会翻车」是另一回事,Google 自己也在应对「实测表现不如分数漂亮」的质疑。所以我的建议是:如果你是开发者或重度生产力用户,趁着介绍期价去实测一把,比看宣传稿更有意义;普通用户则可以等它铺到 Gemini App 里,再决定要不要为 Ultra 买单。
