小米在 9 月 22 日正式发布并开源了 MiMo-V2.6 系列。这一代包括 Pro 和 Flash 两个原生全模态模型,同时放出了蒸馏版本、7000 多个强化学习任务环境、端到端 RL 训练框架和完整技术报告。对开源社区来说,这次的重点不只是模型权重,而是把训练方法和环境一起交了出来。
官方给出的定位很直接:这是小米在递归自我改进(RSI)路径上的一次规模化尝试。六天的在线强化学习直播,背后是半年左右的基础研究和工程试错。
这次到底放了什么出来
开源清单包含四块内容。第一是 MiMo-V2.6-Pro 和 Flash 的模型权重与技术报告。第二是 MiMo-V2.6-Distill-Qwen-9B,用来给社区做 RL 研究的起点。第三是 7000 多个高质量 RL 任务环境,覆盖软件工程、漏洞复现、知识密集型工作和 Web 设计开发四类智能体任务。第四是基于 verl、uni-agent 和 mini-swe-agent 搭建的端到端 RL 训练框架。
这个组合的含义是:过去开源模型只给你一个训练好的结果,现在给的是可以复现训练过程的全套工具链。对做智能体方向的研究者来说,环境这一块的价值往往比权重更高,因为构造可验证的复杂任务环境本身就是最费力气的部分。
六天在线强化学习练了什么
这次训练最受关注的是公开的在线过程。在不到六天的时间里,Flash 和 Pro 各自完成 30 步训练,累计约 75 万条轨迹。官方披露的训练成本分别约为 85 万美元和 262 万美元。
训练规模体现在三个维度上。批次方面,每次更新使用 1568 个样本,支持 100 万上下文长度训练,每个训练步的 token 量达到 35 亿到 37 亿。任务方面,构建了覆盖代码、通用、视觉和网络安全的多任务训练体系,并接入多种 Harness 让不同能力维度协同提升。评分器方面,通过组内相对比较为长周期任务提供更准确的奖励信号,引导模型用更短的路径和更少的 token 完成任务。
规模化训练带来的稳定性问题也有对应处理:冻结 MoE 路由以抑制专家负载漂移,同时在奖励设计、对抗评测、异常检测和验证器交叉校验四个层面建立针对奖励作弊的防线。
基准成绩:DeepSWE 涨了 17 分
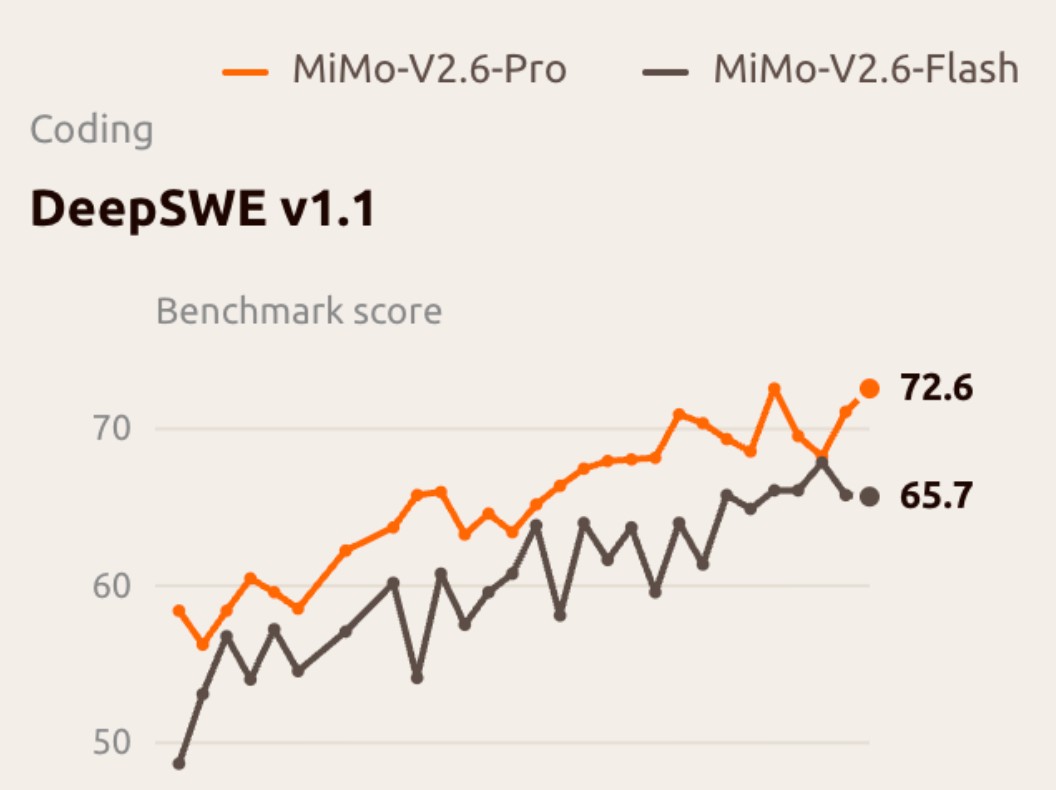
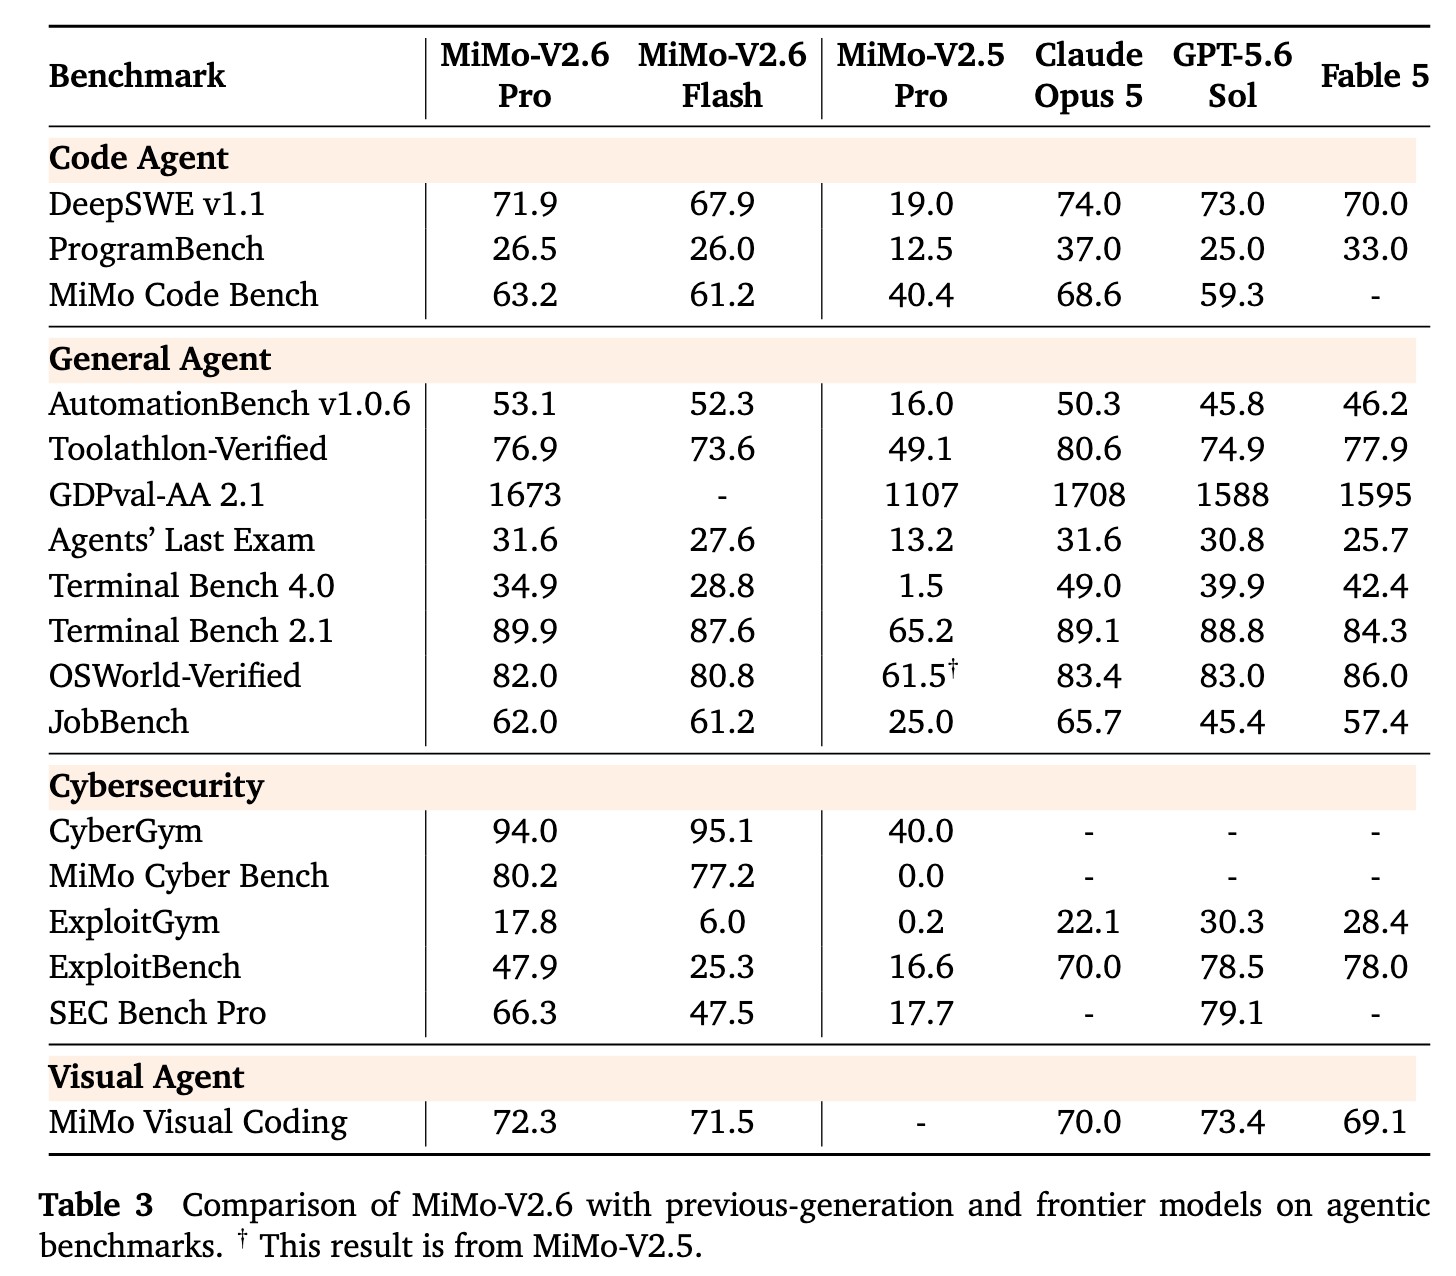
效果数据方面,训练任务的平均通过率分别相对提升约 25% 和 12%。更关键的是分布外泛化:长周期软件工程测试集 DeepSWE v1.1 上,Flash 从 48.8 提升到 65.7,涨了约 17 分;Pro 从 58.4 提升到 72.6,涨了约 14 分。
从蒸馏版本起步的验证也很直观。以 MiMo-V2.6-Distill-Qwen-9B 为起点做 RL 训练,11 个基准全部相对监督微调基线取得提升:SWE-bench Verified 从 61.1 升到 66.2,网络安全测试从 31.3 升到 47.0,Terminal Bench 2.1 从 37.1 升到 52.8,视觉编码从 64.0 升到 72.4。
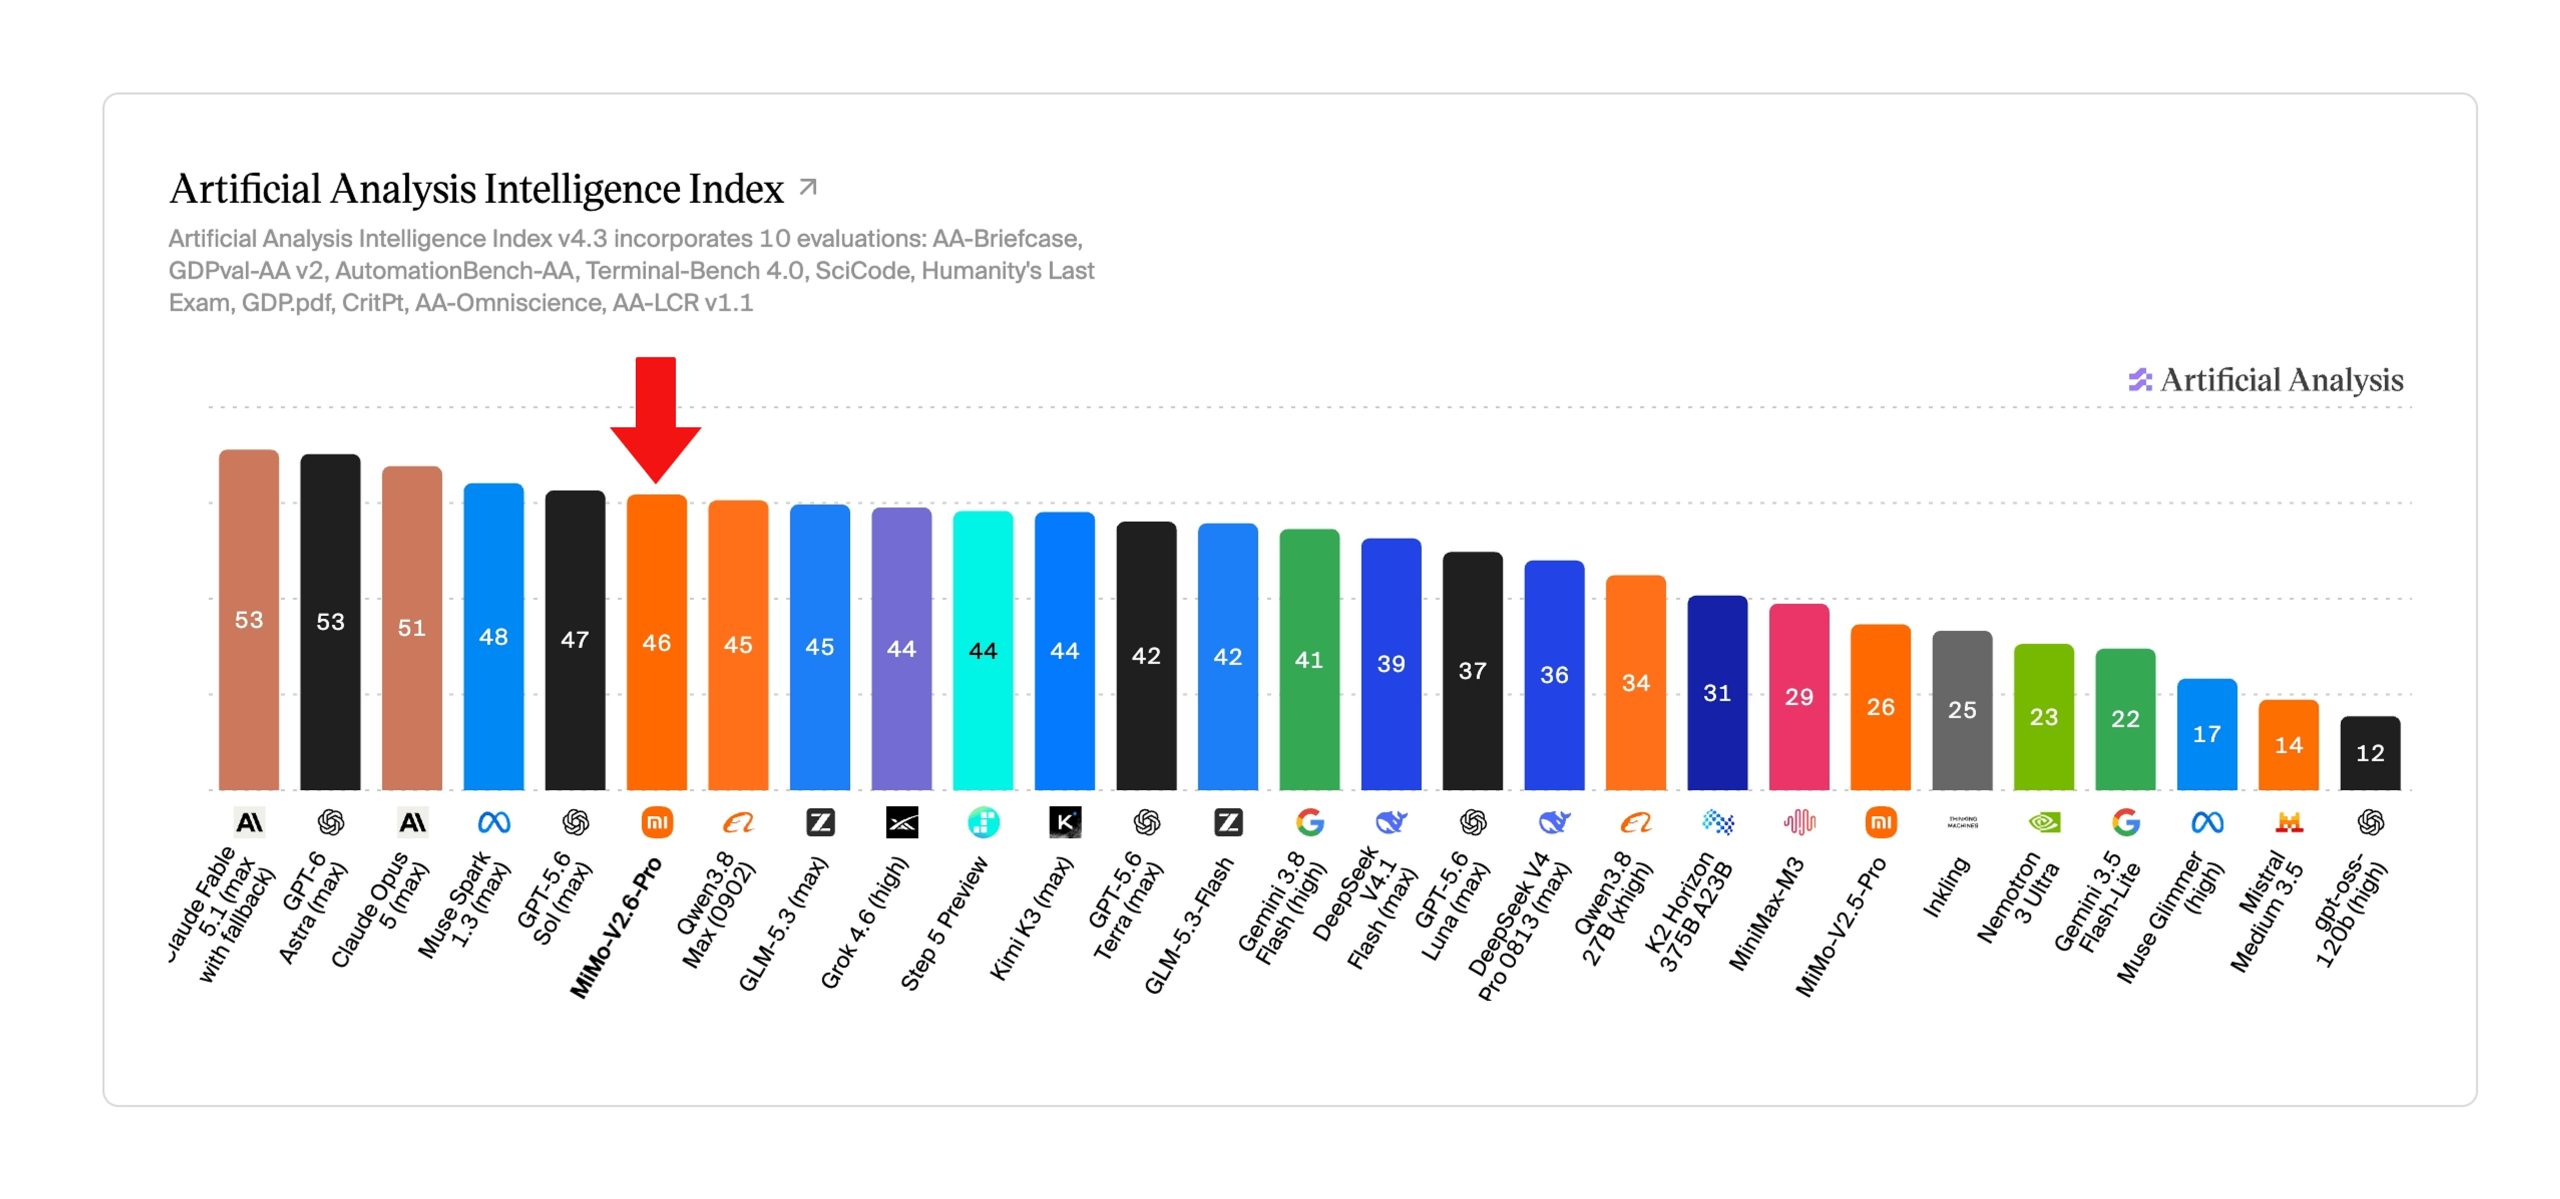
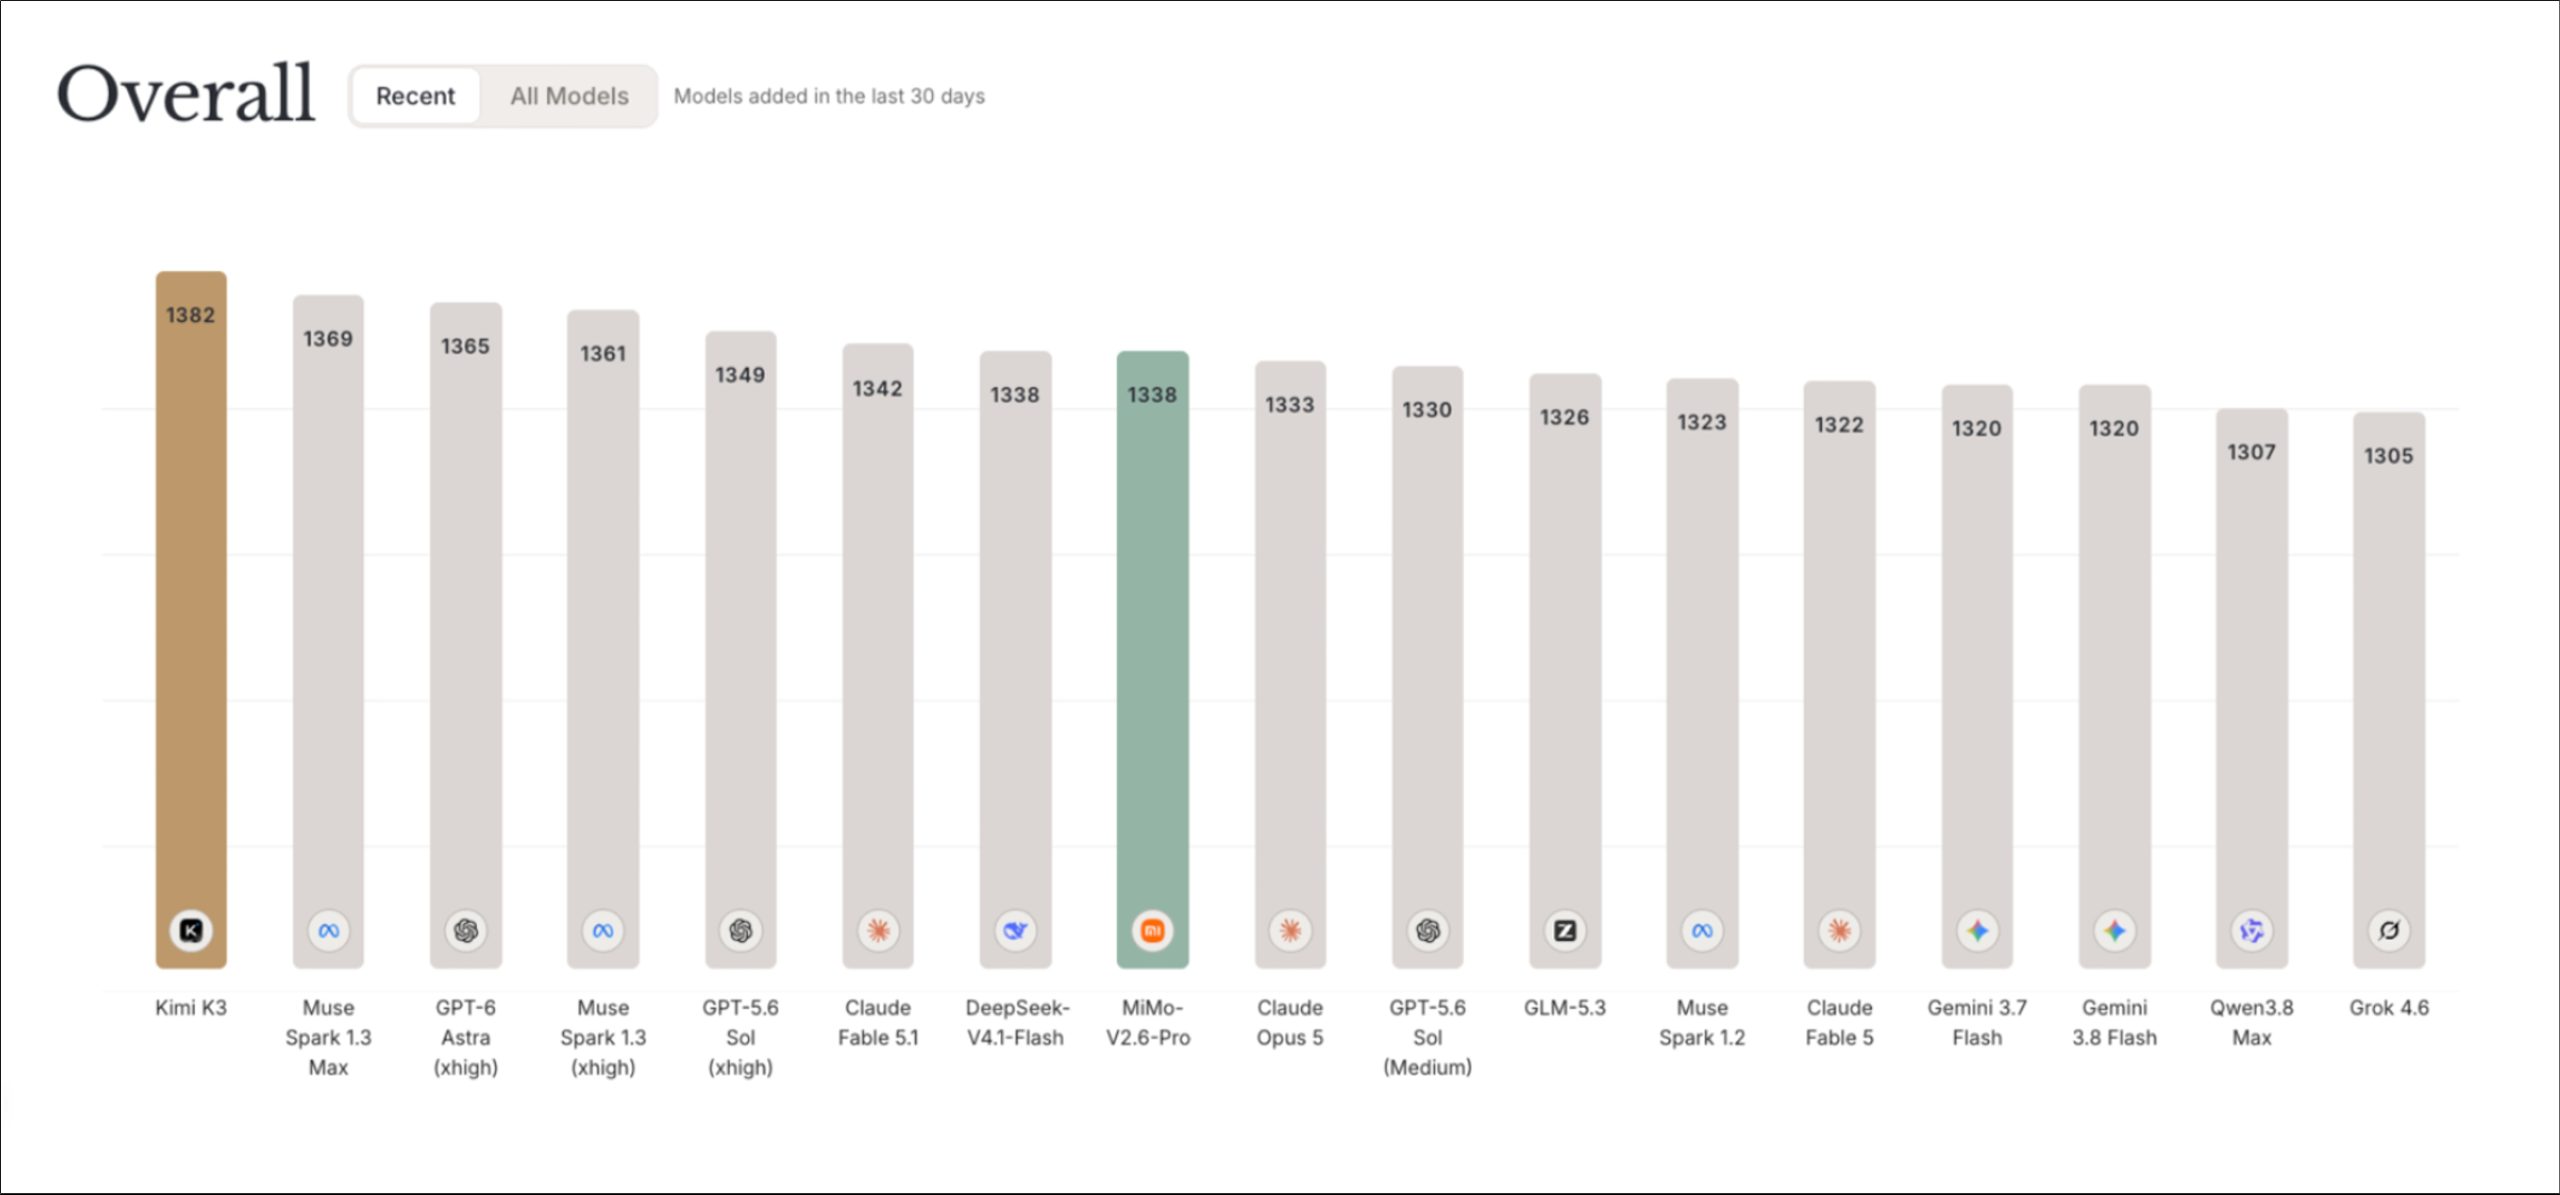
在综合榜上,MiMo-V2.6-Pro 在人工分析智能指数上拿到 46 分,官方称这一成绩超过了 Kimi K3 和 Qwen3.8 Max,成为当前最强的开源模型。同时官方也承认,与最顶级的闭源模型相比仍有差距。
价格没动,性价比拉到海外的二十分之一
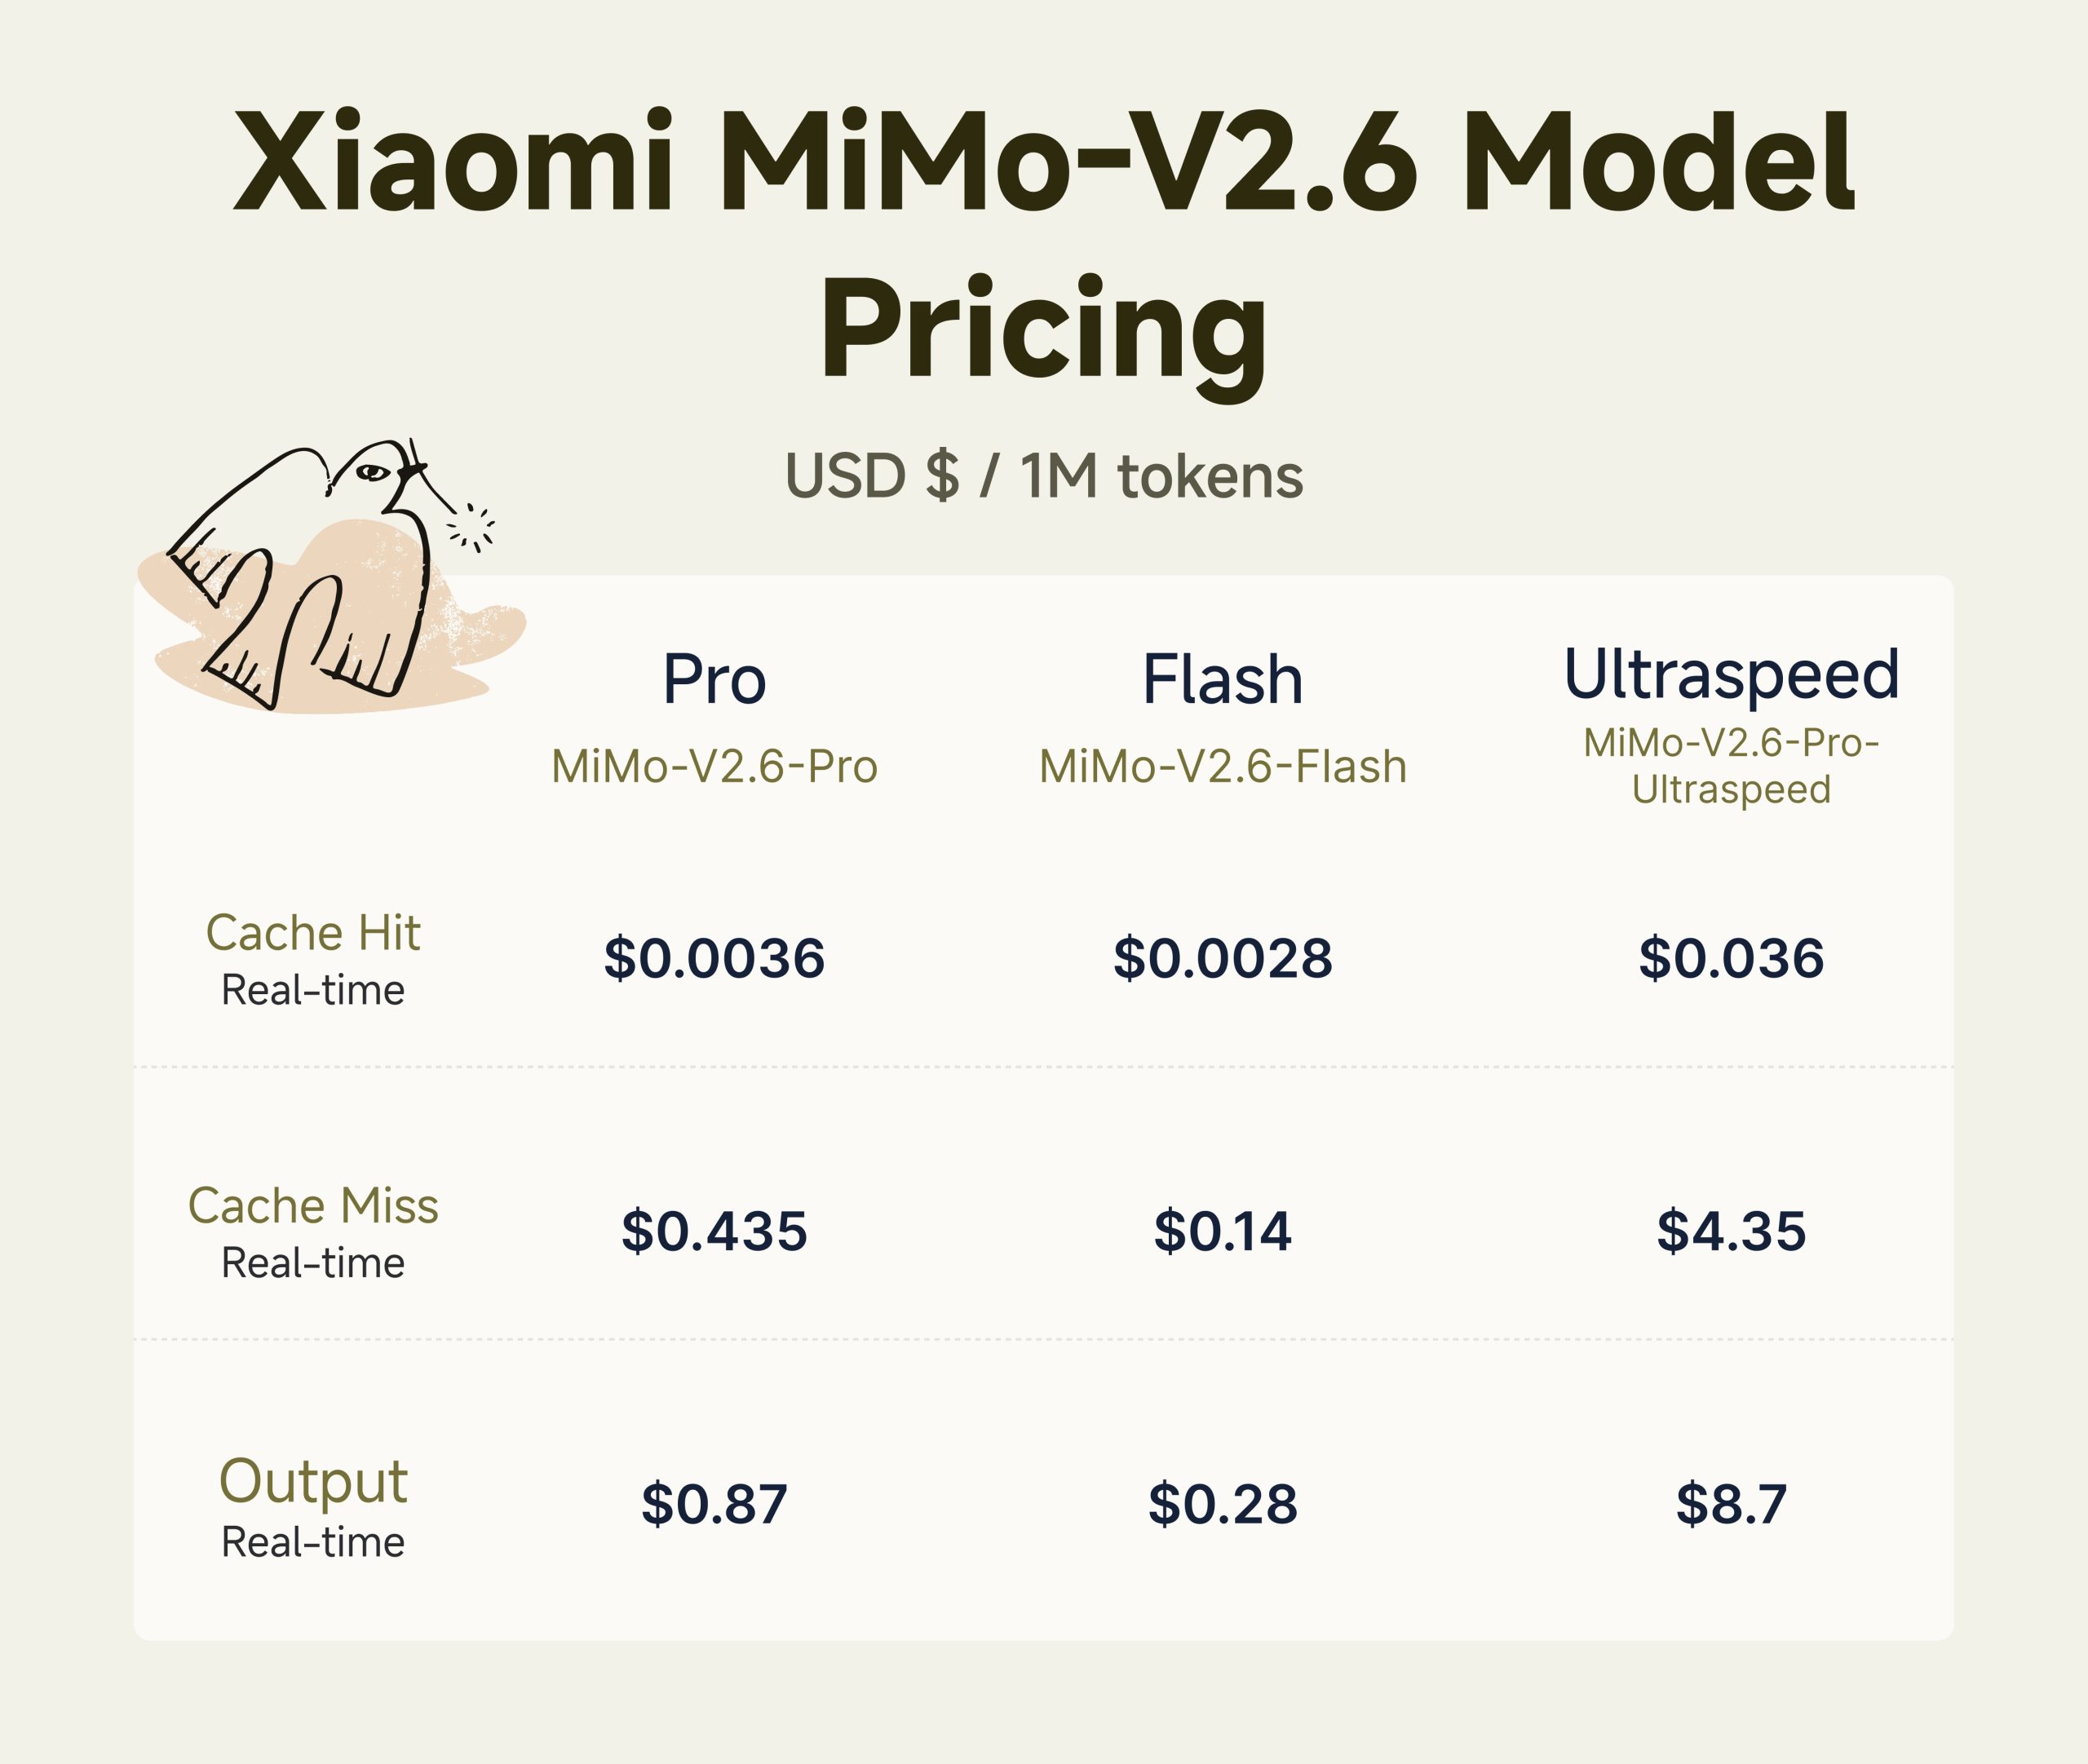
API 定价这一代与上一代保持一致。在智能水平上升而价格不变的情况下,官方称 MiMo-V2.6-Pro 在国内大模型中刷新了性价比纪录:同等智能水平下,价格只有海外模型的二十分之一到六十分之一。
对开发者来说,这直接影响的是能不能把智能体跑起来。强模型配合高价格,通常只适合做少量高质量调用;价格压下来之后,多轮工具调用、长链路任务、批量评测这些吃 token 的用法才有可行性。
7k+ 任务环境与端到端 RL 框架
任务环境这一块值得单独说。官方放出的 7000 多个环境按四类划分,都是可验证的复杂任务,也就是说任务的成败可以被程序自动判定,这样才能提供稳定的奖励信号。这也是当前做智能体强化学习最卡脖子的资源。
训练框架基于 verl、uni-agent 和 mini-swe-agent 搭建,覆盖环境交互、轨迹收集、奖励评估和策略优化全流程。同时开源了一套轻量可组合的 Harness,把系统提示、工具和上下文管理解耦,方便社区自由组合训练配置,探索不同的智能体设计。
官方还提到一个细节:MiMo-V2.6-Pro 通过子智能体协作参与了形式化定理的陈述与证明,最终产出超过 6000 行 Lean 源码,完整证明通过 Lean 内核校验,没有留未证明的占位。由于这一代并没有针对 Lean 做专门的后训练,这个案例说明的是通用能力向形式化任务迁移的上限。
对开发者意味着什么
如果你在做智能体方向的开发或者研究,这一轮开源的实际价值可以拆成三层来看。第一层是直接调用:模型已经在小米开放平台上线,接口价格不变,Pro 版还提供最高 20 倍推理速度的极速模式,适合对延迟敏感的场景。
第二层是本地部署与微调:权重已经放出,蒸馏版本提供了更低的硬件门槛,可以在自己的任务数据上继续做 RL 训练。第三层是方法复用:训练框架和任务环境可以直接拿去做算法、奖励机制和 Harness 的对比实验,不必从零搭基础设施。
需要保持清醒的地方也有两点。一是榜单成绩和真实业务任务之间始终存在落差,DeepSWE 这类测试集衡量的仍然是特定类型的软件工程能力,换到你的实际场景需要自己验证。二是官方强调的最强开源定位带有时间属性,同类模型的迭代节奏很快,这个位置随时可能被刷新。