先说这张图到底在讲什么。苹果在 Jamf 用户大会(JNUC)的「IT 行业最新动态」环节,展示了一页端侧 AI 推理能力的对比图表,把「本地设备到底能跑多大的模型」画成了一条阶梯——从 iPhone 的 140 亿参数,一路排到 Mac Studio 集群的 1.6 万亿。会后有与会者把内容整理流出,才在开发者圈子里传开。它并不是一场面向普通消费者的发布会,更像是一次专门讲给企业 IT 听的答疑。
之所以值得单独拎出来说,是因为在此之前,苹果对「本地能跑多大的 AI」这件事一直含糊其辞,只讲 Apple 智能能做什么,不讲背后的算力边界。这次把每一档设备的上限都标了刻度,等于第一次给出了一份可以对照的参考线。
六档设备,从 16 GB 到 2 TB 排成一条线
图表列得很直白,从上到下是六档设备,每档对应一个「可承载的最大激活参数」。这里要特别注意措辞——激活参数不是模型的总参数量,而是单次推理时真正被调用到的那一部分,两者差得很远。
- iPhone / iPad:最大统一内存 16 GB,带宽 76 GB/s,最高可承载 140 亿激活参数,对应 Siri、文字润色、图片处理这类日常轻量任务
- MacBook Air:32 GB 统一内存,153 GB/s 带宽,最高 350 亿激活参数,覆盖移动办公里的中等 AI 负载
- Mac mini:64 GB 统一内存,307 GB/s 带宽,最高 700 亿激活参数,适合桌面入门和隐私敏感的本地模型
- MacBook Pro:128 GB 统一内存,614 GB/s 带宽,最高 1,200 亿激活参数,面向大型模型、重度创作与开发
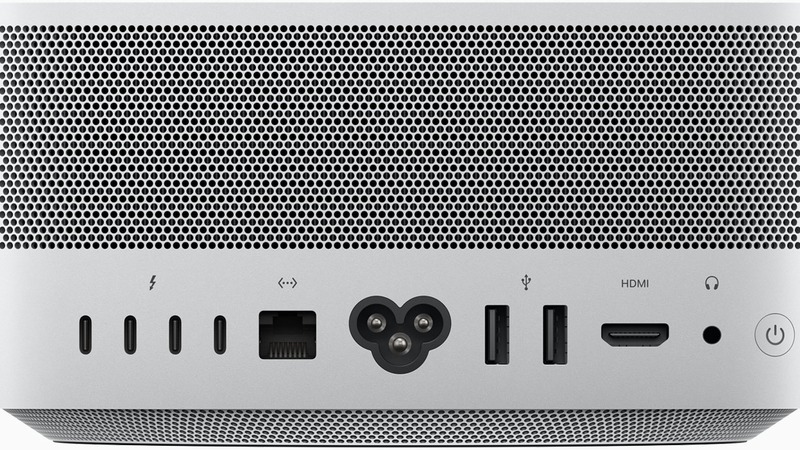
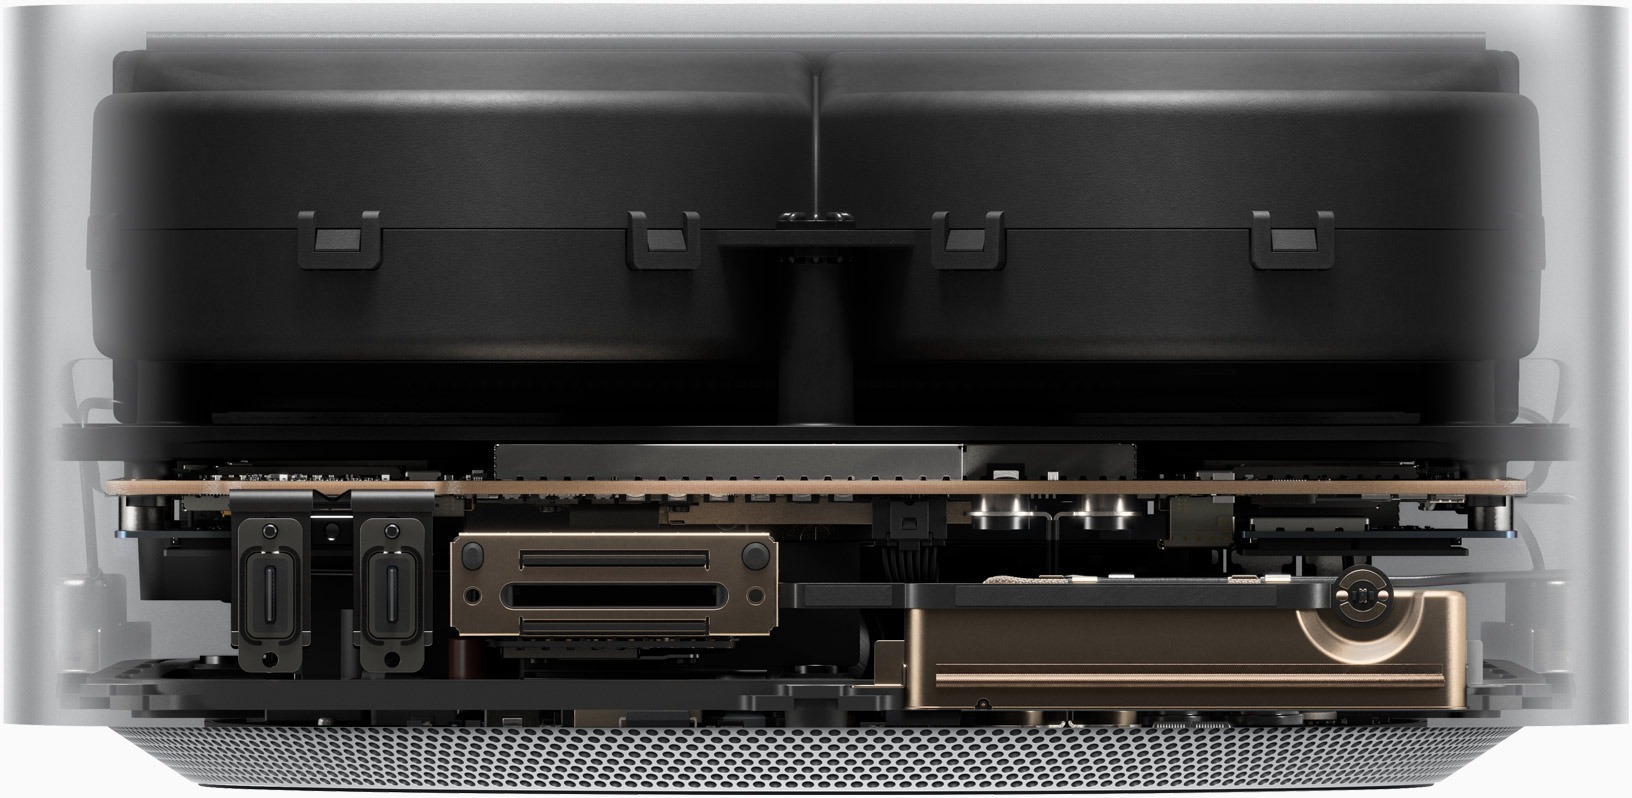
- Mac Studio:512 GB 统一内存,1.2 TB/s 带宽,最高 4,800 亿激活参数,承担高强度推理和影视、科研算力
- Mac Studio 集群:2 TB 统一内存,1.2 TB/s 带宽,最高 1.6 万亿激活参数,用于超大模型的本地训练与推理
把这六行并排看,跨度相当惊人:带宽从 76 GB/s 到 1.2 TB/s,超过 15 倍;内存容量从 16 GB 到 2 TB,整整 128 倍。这也顺带解释了为什么同一款模型在手机上「卡到不能用」、在 Mac Studio 上却能流畅对话——差的不只是芯片,是整个内存盘子的大小。
容量与带宽,是两道绕不开的闸门
很多人以为跑大模型卡的是芯片算力,实际用下来,先卡住你的是内存。模型权重必须整体装进内存才能稳定推理,装不下就得反复从存储里搬运,速度是断崖式下跌。
内存容量决定「装得下什么」,内存带宽决定「跑得多快」。带宽这条线在长上下文场景里尤其明显:上下文越长,每生成一个词要重新读取的数据越多,带宽不够就会一眼看出卡顿。76 GB/s 和 1.2 TB/s 之间的差距,落到体验上就是「等三秒」和「字跟着冒出来」的区别。
所以这张图真正想传递的信息其实很朴素:想在本机跑多大的模型,先看你的统一内存有多少、带宽有多宽,再谈其他指标。芯片型号排第一位是习惯,内存规格排在第一位才是现实。
这套分级的地基,是统一内存架构
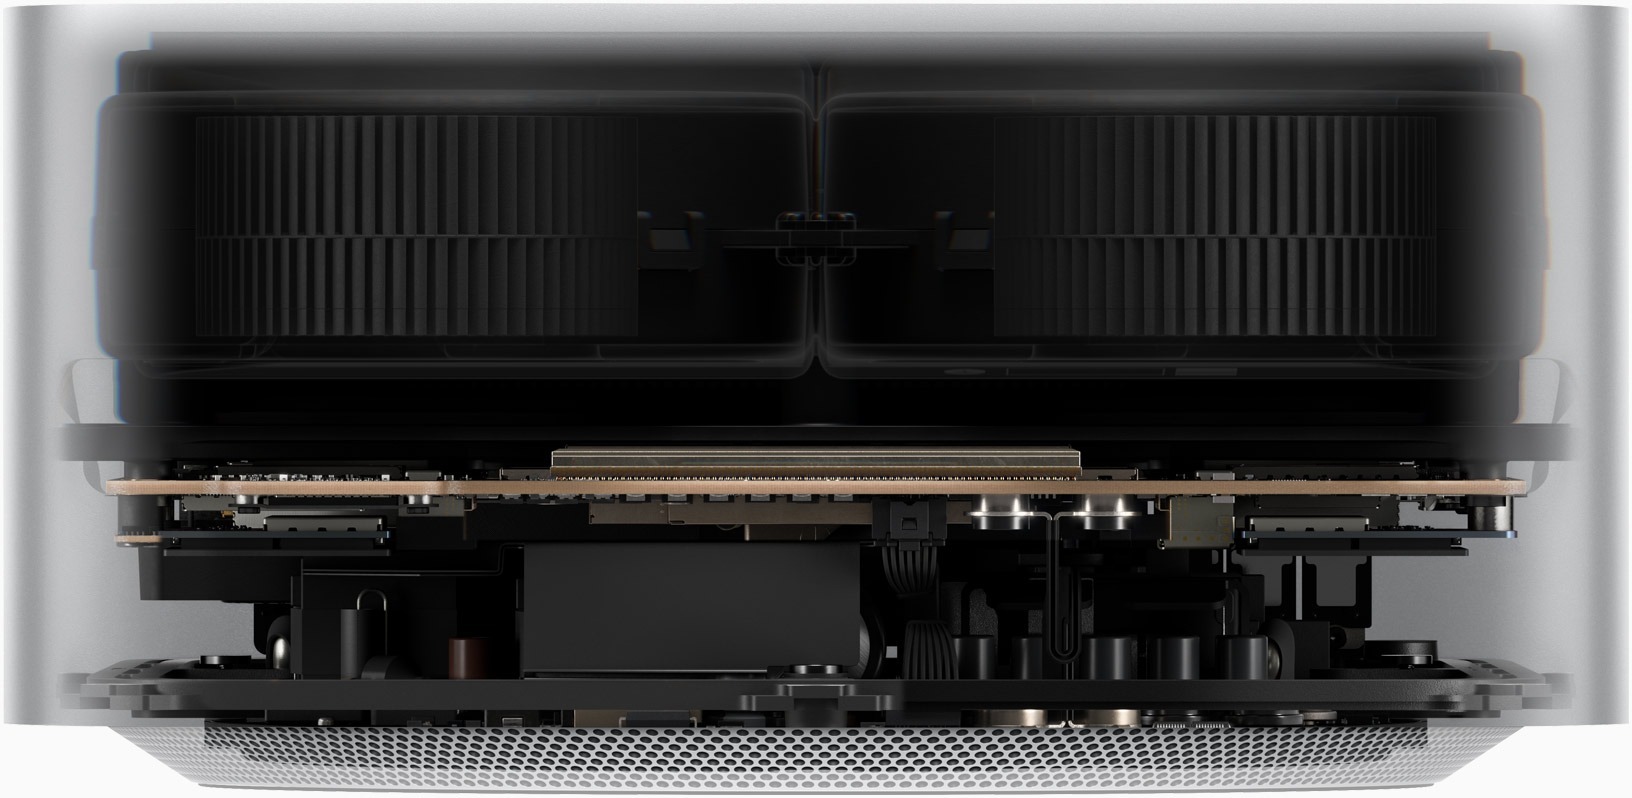
苹果能把设备按内存规格排出这么整齐的一条线,前提是它的统一内存架构——CPU、GPU 和 NPU 共享同一块内存池,模型权重只需要加载一次,不需要在不同单元之间来回拷贝。少了拷贝这一环,大模型在本地跑起来的门槛就低了很多。
传统 PC 的显存和系统内存是两套账本,想跑大模型就得看显卡有多少显存,而显卡显存通常远小于可扩展的系统内存。苹果这套做法的好处是内存可以做得很大,代价是带宽和 GPU 的专用高速显存仍有差距。这也是为什么苹果的路线更偏向「装得下更大的模型」,而不是「单次推理最快」。
两边的取舍不一样,没有绝对的好坏,只看你更在意能跑多大的模型,还是更在意跑得有多快。
iPhone 上跑 270 亿参数的那次实测
图表出来之前,已经有人做过极限试探。此前有实测在 iPhone 18 Pro 上运行 270 亿参数的模型,结果是能跑起来,但没有达到稳定可用的激活状态——也就是说,参数确实装进去了,可用性没跟上。
这个结果和图表上的 140 亿上限并不矛盾。上限指的是「能稳定承载并可用」的那条线,270 亿属于越线尝试:能启动、能出字,但速度和稳定性都撑不起日常使用。把它当成一次压力测试来看,数据本身是有价值的。
对普通用户来说,这反倒是个好消息。你现在手上的 iPhone,跑 Siri、系统级文字润色和图片处理,其实还留着不小余量,没必要为了参数表焦虑。
把「集群」划进端侧,这个划法值得琢磨
图上最后一行是「Mac Studio 集群」:2 TB 内存、1.6 万亿参数。它被放进「端侧」而不是云端,是个刻意的安排。
按这个口径,几台 Mac Studio 通过高速互联串起来,仍然跑在用户自己的机房里,数据不出本地网络。对企业来说,这个区别很关键——模型再大,只要不出内网,数据流向就能说清楚,内部审核也好过。对开发者来说,这也意味着「本地训练」这件事在大内存机器上有了一条现实路径。
当然,集群不是拼积木。互联带宽、任务切分、故障恢复都得自己处理,调度做不好,多台机器的效果可能还不如一台。想过这一关,团队里得有懂分布式的人。
开发者和 IT 管理员,可以直接当对照表用
这份图表对企业采购其实很有参考价值,它在回答一个非常具体的问题:我们想在本地跑某个规模的模型,得给员工配什么机器。
- 只做日常办公、AI 辅助写作和图像处理:现有 iPhone、iPad 和入门 Mac 基本够用
- 要跑中大型本地模型做内容生产:MacBook Pro 这一档是明显的分水岭
- 需要本地跑 4,800 亿参数级别的推理:得直接上 Mac Studio
- 涉及超大模型训练,或要求数据完全不出内网:才需要考虑集群方案
值得注意的是,这条线是按统一内存容量排的,也就是说,配置内存的预算基本决定了你能跑什么。选购时先把模型规模定下来,再反推内存,比先看价格再挑型号省事得多。不少负责采购的用户反馈,以前最难的就是没法向上面解释「为什么这台机器要配这么大内存」,现在直接把这张表甩过去就行。
普通用户该盯住哪一档
对绝大多数人来说,最上面那一行才是和你有关的。140 亿激活参数覆盖的是 Siri 的本地理解、输入法的智能润色、相册里的图片处理、语音转文字这些每天都在用的功能,它们不需要联网,响应也更快。
真正会让人纠结的是下一档。如果你打算在本地跑开源模型做点自己的事,16 GB 的 iPhone 并不是现实选择,起步得看 MacBook Air 那一档;如果你只是想让手机上那些 AI 功能跑得顺一点,说实话,现在这台设备已经够用,没必要为了参数表去换机。
讲真,这张图最大的价值不是让你数参数,而是把「本地 AI」从一句口号变成了一条可以对照的尺子。至于要不要为更高的那一档买单,还是得看你的实际用法。