9 月 8 日,OpenAI 在社交媒体上发了一条不算长的声明:一个比 GPT-6 Astra 更强、目前尚未公开的内部模型,组织约一万个 AI 智能体,用 88 小时给出了纳维-斯托克斯方程存在性与光滑性问题的证明,同时公开了一份 166 页的论文和对应的 Lean 验证代码。
这道题是克雷数学研究所七大千禧年难题之一,悬赏 100 万美元。OpenAI 明确表示不会去申领奖金。声明发出后不到一天,数学界的质疑声就跟上来了——争议不在结果,而在方法。
88 小时解一道 90 年的题,先把数字摆出来
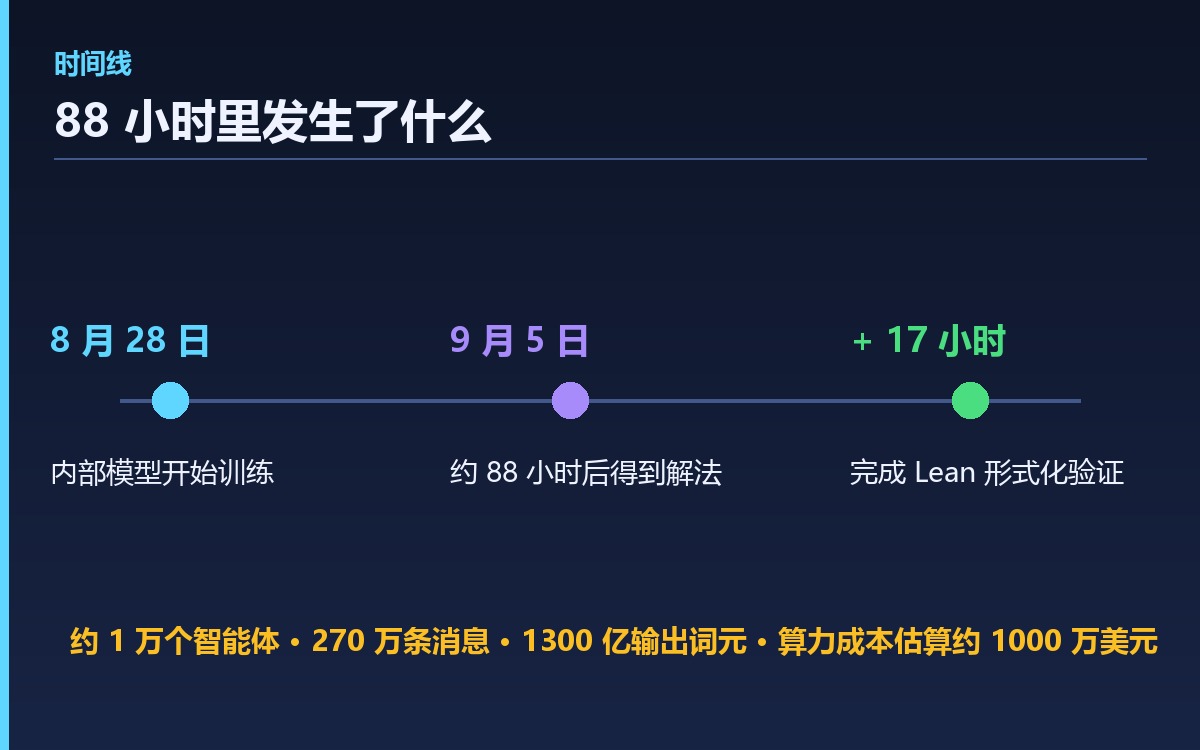
按 OpenAI 披露的时间线:内部模型从 8 月 28 日开始训练;9 月 5 日得到解法,距首批智能体启动约 88 小时;随后模型又花 17 小时把证明转写成 Lean 形式化代码。
过程中的资源消耗同样值得记录:约一万个智能体围绕这道题互相发送了大约 270 万条消息,产生约 1300 亿个输出词元。有媒体按 OpenAI 自家最先进模型的对外定价估算,这部分算力成本大约在 1000 万美元上下。
所以「88 小时」不等于一台电脑想了 88 小时。它更像是一万张研究桌同时开工,在三天多的时间里把一片很大的搜索空间筛了一遍。这个数字听起来惊人,但它衡量的是并行规模,而不是单点推理速度。
「流体爆炸」到底在问什么
纳维-斯托克斯方程描述的是流体运动——自来水从龙头流出来、烟雾在空气里散开、空气流过机翼表面,都是它管的范围。工程上人们早就能用它做模拟:给好初始条件和边界条件,把空间划分成网格,计算机一步步算出流体接下来怎么动。
问题是,能算出某一次流动,不等于在数学上理解了这个方程。
具体的问题是这样:假设一团三维流体一开始非常平稳,速度、压力这些量处处连续、没有任何跳变。随着时间推移,它会一直保持这种平滑状态吗?还是可能在某个有限的时刻,突然出现一个变化无限剧烈的点?
这个点在数学上叫「奇点」。如果奇点出现,某处的速度在数学上会趋向无穷大,原本光滑的解发生「有限时间爆破」(finite-time blowup)。真实的水当然不会变成无限速度——分子尺度上连续介质假设本身就失效了。所以奇点更像方程亮起的一盏故障灯:它说明在某种极端情况下,这套模型可能没法继续描述流体。
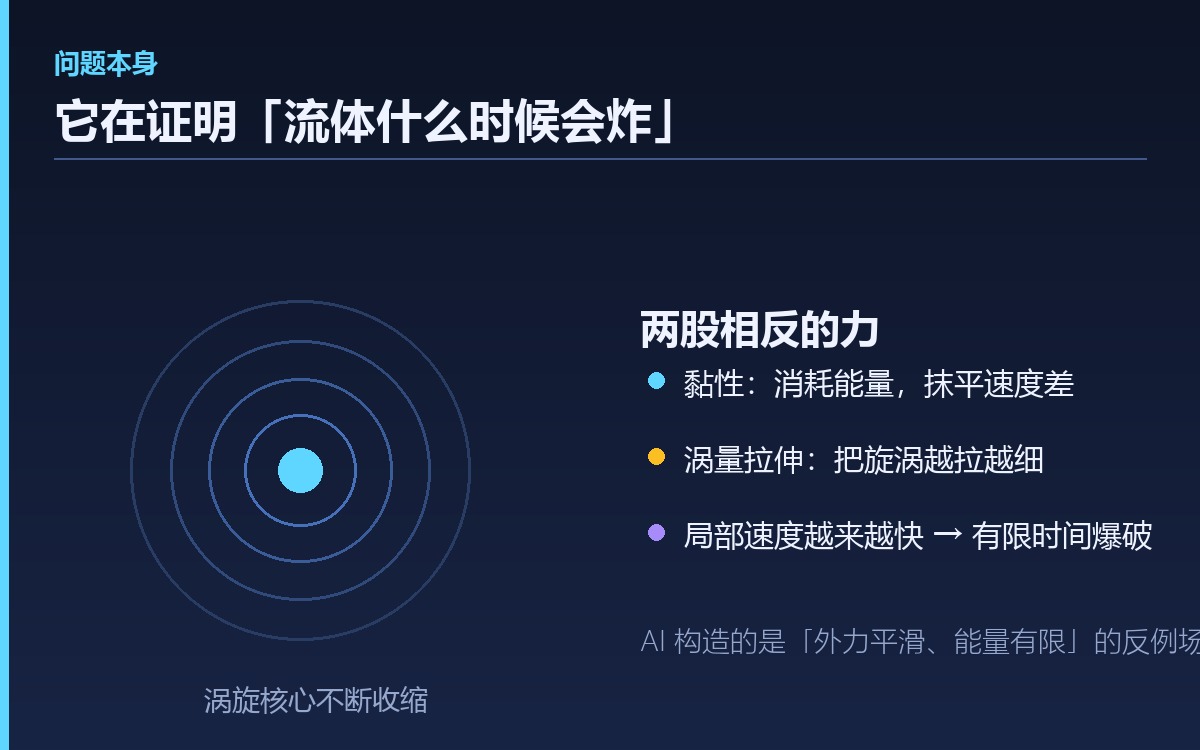
三维流动里始终有两股相反的力在较劲。黏性会消耗能量、抹平速度差,像蜂蜜里的旋涡很快就安静下来;涡量拉伸这类非线性作用却可能把旋涡越拉越长、越压越细,让局部变化越来越强。黏性到底能不能永远压住它?数学家找了九十多年,还没给出适用所有情况的答案。
OpenAI 选的是「构造反例」这条路
这里有个容易被忽略的关键点:克雷数学研究所设的这道题,并没有规定必须证明「解永远平滑」。它给了两条相反的路线——要么证明在规定条件下解始终存在且保持平滑,要么构造一个符合要求的反例,证明奇点确实能在有限时间里形成。
OpenAI 走的是第二条。按官方说法,AI 构造出的场景是:流体最初处于静止状态,受到一个平滑外力后逐渐开始旋转,涡旋不断向中心收缩,同时沿轴向被拉长——像一团旋转的面条被越拉越细。中心区域越来越小,局部速度越来越快,最终在有限时间内形成奇点,而整个流场的能量仍然保持有限。
为什么强调「外力平滑、能量有限」?因为如果一开始就施加一个无限大的力,或者给一个不光滑的初始状态,制造奇点并不难,那等于把异常结果提前塞进前提里。真正的难点是让初始状态、外力和总能量都满足题目要求,让奇点由流体自身演化产生。
对应到官方命题,这份结果覆盖了其中的 C、D 两种情况。需要说清楚的是,它研究的是施加特定平滑外力的情况,并不是说水杯里的旋涡、河流或者机翼尾流会突然出现无限大的速度。
一万个智能体是怎么分工的
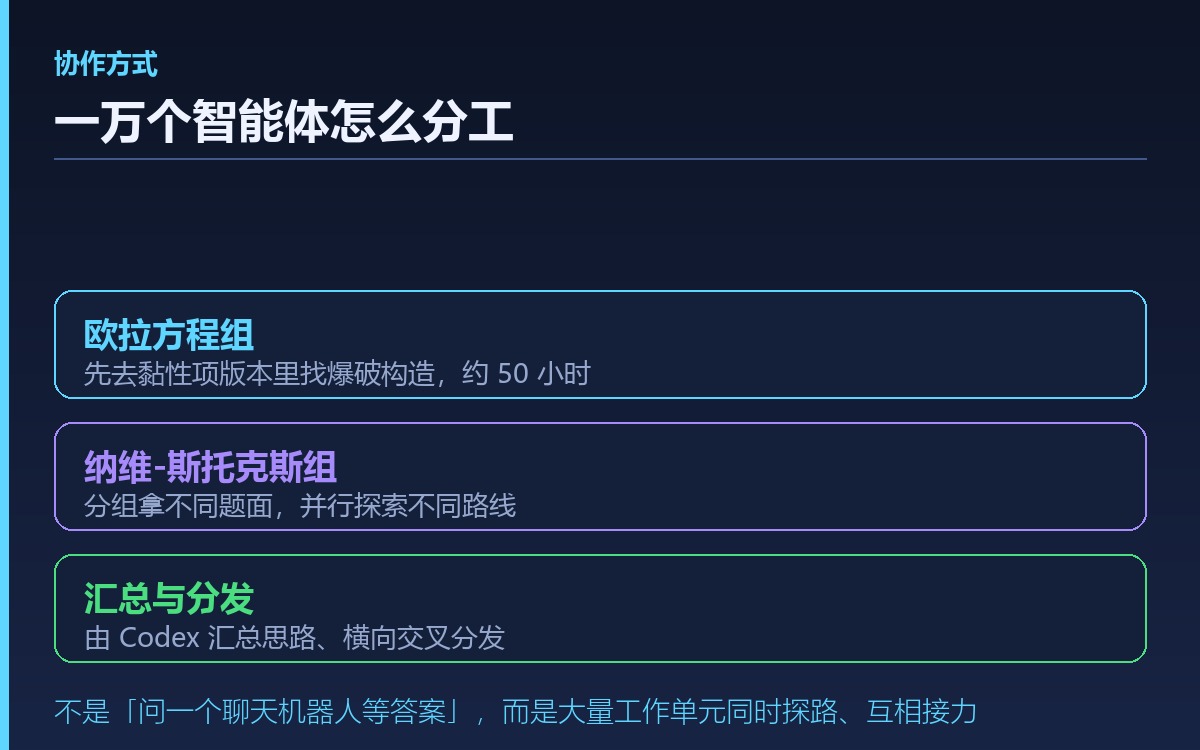
OpenAI 用的不是「向一个聊天机器人提问然后等答案」的模式,而是一套多智能体系统。所谓智能体,可以理解成一个有具体任务、能保存进度、会使用工具的 AI 工作单元——能读资料、能跑代码、能推公式,也能把中间结果交给别的智能体。
具体分工大致是这样的:AI 智能体分组拿到不同题面,可以读缓存的互联网内容、运行代码、在组内交流。在正式挑战纳维-斯托克斯之前,近 100 个智能体先用大约 50 小时做出了无外力欧拉方程的有限时间奇点——欧拉方程相当于去掉黏性项的流体方程,结构相近但更容易出奇点,适合当热身。之后资源才转向纳维-斯托克斯,由 Codex 负责汇总思路并交叉分发。
不同小组找到的线索会被定期汇总重组。一条路线可能自己走不通,但其中关于涡旋形状的想法,正好补上另一条路线缺的一环。这种「局部结果互相拼装」的机制,是这次能在几十小时内推进的关键。
Lean 验证过了,为什么还不算「解决」
很多人看到「Lean 验证通过」就以为尘埃落定了,其实还差得远。
Lean 是一个交互式定理证明器,作用是把数学证明拆成计算机能逐步核对的细碎步骤。普通论文里常见的「显然可得」「由类似计算可知」这类省略,Lean 一律不接受——每一步用了什么前提、调用了哪条定理、能推出什么结论,都必须写清楚。前一步只证明了某个量「大于等于零」,下一步当成「大于零」用,人类读的时候可能一眼带过,Lean 会直接停下。
但 Lean 通过,只能保证「按照输入的定义和前提,后面的结论确实能推出来」。从现实中的数学问题到 Lean 能识别的形式化命题,中间还需要一次翻译。如果翻译时漏了条件,或者对官方题目的理解有偏差,计算机可能验证了一份逻辑正确、却没真正回答原题的证明。
所以数学家要额外做两件事:确认 Lean 文件能否运行,以及确认它验证的命题和克雷研究所提出的问题完全一致。截至 9 月 9 日,克雷数学研究所仍把这道题列在未解决问题清单里。按规定,一份候选证明需要先在符合要求的学术刊物上发表,发表后至少经过两年,还要获得国际数学界普遍认可,研究所才会考虑是否授奖。此前七大难题中唯一被公认解决的是庞加莱猜想。
争议:另一组人也在做同一件事
消息公布当天,纽约大学数学教授特里斯坦·布克马斯特公开表示,他与在 Anthropic 任职的研究员莱文特·阿尔珀格此前已在相近方向得到过带光滑外力的欧拉方程有限时间奇点,并完成了 Lean 验证。由于他们曾使用 OpenAI 的 Codex 处理工作,他质疑 OpenAI 的模型是否接触过相关会话内容,并称对方曾提议由他单独发表成果。
OpenAI 的回应是:研究人员和 AI 智能体没有看到对方的成果,也没有为解题访问特定用户数据;但「虽然不太可能,我们不能完全排除」去标识化后的产品使用数据以某种方式参与了训练。公司同时强调,双方的欧拉问题外力设定不同,证明本身差异显著。
这场争论目前没有结论,也不影响我们对「技术进展」这件事的判断:一份带形式化验证的候选证明已经交到桌面上,接下来要看偏微分方程、流体力学和形式化数学领域专家的独立审查。无论最终结论如何,这次的真正新意不在某个模型多聪明,而在于一种新的协作形态——大量智能体并行探路,形式化工具逐级校验,人类负责提问、判断方向并审查最终答案是否真的回答了原题。