一周之内第二发:Claude 5.5 家族再落一子
9 月 28 日,Anthropic 把 Claude 5.5 家族的第二颗棋子落了下来:Claude Sonnet 5.5。9 月 22 日他们刚发了旗舰 Opus 5.5,这回的 Sonnet 5.5 定位很明确——不是来替换 Opus 的,而是它的「更快、更便宜的补充」。官方给的卖点就两条:输出速度比上代 Sonnet 5 快 30% 以上,单任务成本降约 30%。价格牌没变,还是 2 美元输入、10 美元输出每百万 token,正好是 Opus 5.5(4 美元 / 20 美元)的一半。它现在全平台都能用,包括 Claude.ai 的免费档,模型 ID 是 claude-sonnet-5-5,1M token 上下文、128K 最大输出。Haiku 5.5 会在几周内补齐,5.5 家族就齐了。说白了,Anthropic 想用一款「便宜、快、还挺聪明」的中端模型,去接住这波 agent 跑量的需求。
速度 +30%、每任务 -30%:账是怎么算出来的
先说那个「每任务成本降 30%」。这里有个容易误会的地方:Anthropic 不是降价了,标价一分没动,2 美元 / 10 美元跟 Sonnet 5 一样。省下来的成本是「用更少的 token、更少的工具调用、更少的步骤,把同样的活干完」。所以同样的任务,5.5 吐的字更少、调工具更准,账就摊薄了。再叠加缓存读(0.20 美元 / M)和 Batch API(输入输出再砍半到 1 美元 / 5 美元),长上下文也不加价——1M token 按标准价计费,没有长文本附加费。还有个背景值得提:Sonnet 5 今年六月是以 2 美元 / 10 美元的「介绍价」发布的,原计划八月涨到 3 美元 / 15 美元,后来放弃了。所以 5.5 沿用同价,等于在这档位上来了一次「软降价」。对天天跑 agent 的团队来说,单价不变、但每次跑完总账单更小,这才是实打实的省钱。
Terminal-Bench 70.6%:中端反超旗舰的含金量与争议
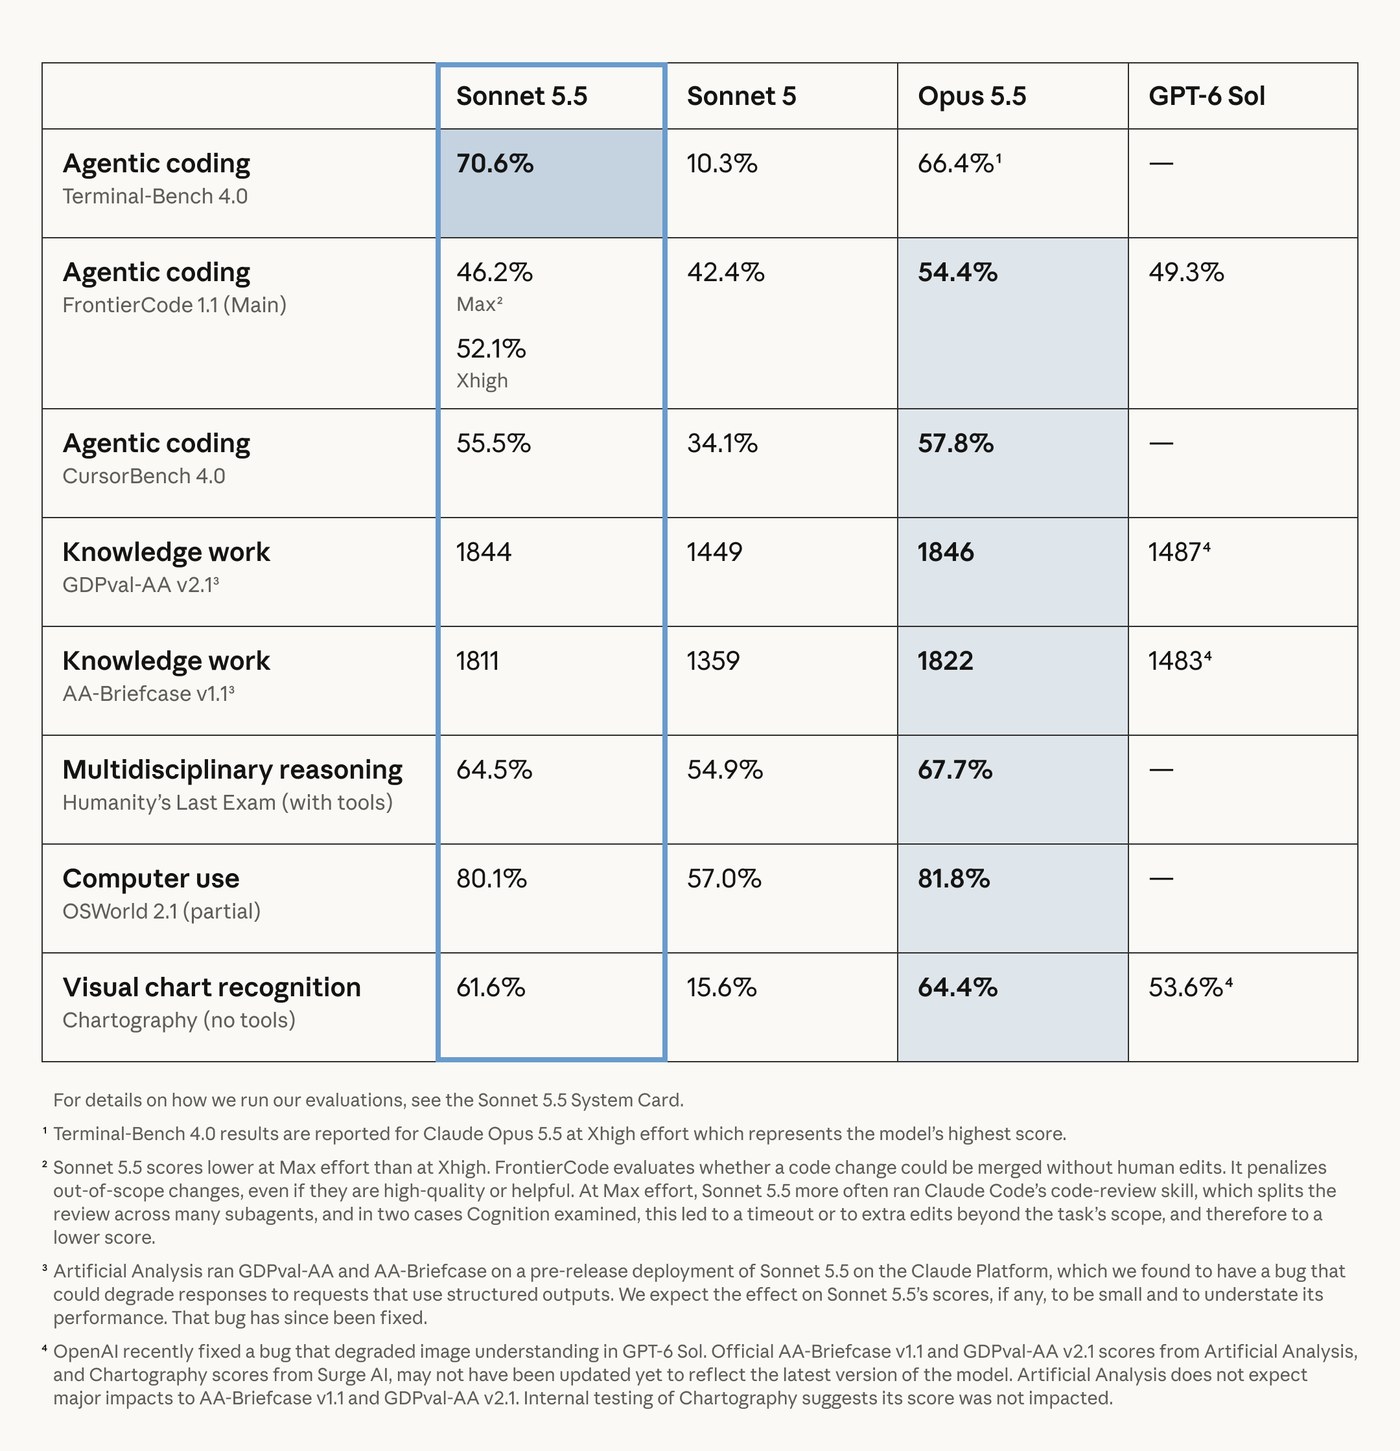
性能到底涨没涨,看官方基准最直观的一张表:Terminal-Bench 4.0(命令行 agentic 编码)上,Sonnet 5.5 拿到 70.6%,而上代 Sonnet 5 只有 10.3%,同场的 Opus 5.5 是 66.4%(脚注里 Opus 用的是它最高的 xhigh 档)。一个中端模型反超旗舰,看着很炸,但得泼点冷水:Sonnet 5 那 10.3% 低得离谱,Anthropic 没解释,所以代际增幅里有多少是「上代在这测试上摆烂」很难说。独立机构 Artificial Analysis 复测的结果是 Sonnet 5.5 63.6% 对 Opus 5.5 的 59.6%,排序一致、数值更保守。另一处要提醒的是,把 effort 拉到 max 档时,5.5 单次任务平均能吐出 19.3 万 token,是迄今测评模型里最高的,每 Index 任务成本飙到 7.60 美元——便宜的是单价,不一定是每任务总价。还有退步项:AA-Omniscience 幻觉率从 39% 涨到了 47%(max 档)。把这些负面数据摆上桌,比只报 70.6% 要诚实。
同价不同效:对 Sonnet 5、Opus 5.5 与 GPT-6.1 Sol
横向比一圈。对 Sonnet 5,5.5 基本是全面换代,速度、成本、编码全面占优,迁移代价是五处破坏性变更(后面会说)。对 Opus 5.5,5.5 用一半的价格拿到只差 2 分的 GDPval Elo(1844 对 1846),Anthropic 也老实承认,Opus 在开放式判断、复杂推理上仍然明显更强——日常活交给 5.5,硬仗还是 Opus。对 OpenAI 的 GPT-6.1 Sol(9 月 29 日发布),两者同价 2 美元 / 10 美元,但 Sol 的缓存读只要 0.10 美元 / M(5.5 的一半),超过 272K 输入才加价(5.5 不加),所以重缓存的 agent 场景 Sol 每任务能便宜数倍;反过来 5.5 的上限更高、长任务更稳。结论不复杂:日常修复和文档流走 5.5,烧脑的开放式任务上 Opus,如果你的 agent 账单大头是缓存读、又想压成本,Sol 值得算一笔账再选。没有谁吊打谁,只有按工作负载路由。
落地:agentic 编码与办公的真实反馈
光看跑分不够,得看真实工作流接不接得住。编码侧,Lovable 的 CTO 说工具调用大约少了三分之一、shell 执行少了约一半;Base44 用 118 个真实应用测,平均 3.6 次迭代就能构建完成,而上代 Opus 5 要 7.7 次。办公侧,Slack 的首席工程师说不改任何 prompt,离线评测几乎全面优于 Sonnet 5,步数更少、输出 token 约减 14%;Box 在金融和医疗场景说更快 2.4 倍、总 token 减 12%,还能回查源文档抓出上代漏的错误;Zendesk 工单快 20%、Atlassian 的 Rovo Agents 最多快 30%。不过迁移不是无痛的:从 Sonnet 5 升上来有五处破坏性变更,包括 thinking: disabled 不可用、强制 tool choice 返回 400、thinking 块绑定账号、旧的 computer 工具在 API 和 Google Cloud 被拒、旧模型不能再当 advisor。另外 Sonnet 4.5 已经在 9 月 30 日被标弃用、11 月 30 日退役,官方指定的接替者就是 5.5——还在用 4.5 的团队,排期该提上来了。
agents 主流化这一周:模型层的卡位战
把镜头拉远,Sonnet 5.5 踩中的是「agent 主流化」这波节奏。2026 年九月,常驻智能体集中爆发:9 月 8 日 Meta 的 Muse(免费加订阅,接 WhatsApp),9 月 25 日微软 Copilot Autopilot(M365 私测),9 月 29 日 OpenAI 的 Dots(DevDay 上那个常驻云端的同事),更早还有 Google 的 Gemini Spark(5 月)、xAI 的 Grok Bot(8 月)、Manus 的 Cue(9 月 28 日)。当「把日常任务交给一个常驻 agent」从概念变成产品,背后缺的不是噱头,而是便宜、快、省 token 的中端模型——它才是 agent 跑得起量的燃料。Sonnet 5.5 就是供给端给出的那一档。至于媒体解读里「Anthropic 赶在 IPO 前拓宽产品线」的说法(据路透社),听听就好,别当成产品力本身。最后一句实在话:真要切流量,先在自家那几个真实任务上跑一遍分,再决定把 5.5 还是 Opus 还是 Sol 顶上去。
网友评论
- 「昨天把公司项目扔给 Claude Code 换 5.5 跑重构,肉眼可见地快了,等结果的时间少了一大截,这波是能真真切切感觉到的升级。」
- 「别光看标价没涨,我开 max effort 跑一个任务吐了将近 19 万 token,账单直接起飞……这模型正确打开方式是中档位,无脑拉满就是给 Anthropic 捐钱。」
- 「Terminal-Bench 从 10.3% 涨到 70.6%?上代这个数怎么看都不正常,与其说是新款太强,不如说上代在这测试上摆烂,理性看待吧,独立测的 63.6% 才更像真实水平。」
- 「同样 2 美元 / 10 美元,GPT-6.1 Sol 缓存读取还便宜一半,算下来跑 agent 好像更省钱;但 Claude 上限又更高。有没有两个都上过生产的兄弟说说体感,到底怎么选?」
- 「老实说我更关心做 PPT 和表格那部分,5.5 出的稿子确实比之前整洁,套完模板基本不用改,对打工人是真的友好。」
- 「又要迁移了……thinking 设置变了、旧的 computer 工具不能用了,CI 里还挂着 Sonnet 4.5 一看 11 月底就退役,排期吧,头大。」
总结:它是对准「铺量」的那一档
总结:Sonnet 5.5 不是来炸场的,是来铺量的。它把「快 30%、每任务省 30%、价格不变、上限还高」这几件事捏在一起,对准的就是 agentic 编码和办公这种高频、可重复、吃 token 的场景。客观说,它比上代是实打实的换代,和同价位的 GPT-6.1 Sol 各有胜负,半价的 Opus 也还在上面压着。但别被「每任务 -30%」冲昏头——那是省 token 省出来的,不是降价,max 档 token 暴增那坑该绕就绕。给你的建议很具体:日常修复、文档、工单这类标准化活,5.5 闭眼上;烧脑的开放式判断留给 Opus;如果你的 agent 账单主要是缓存读,先拿 Sol 算笔账。迁移那五处破坏性变更和 Sonnet 4.5 的退役时间表,也趁早排进排期。
