站内之前已经写过几篇 Breeze TTS 2 的模型解析和实时语音深读,后台问得最多的却是一个更朴素的问题:这模型到底怎么下、怎么在自己机器上跑出第一段声音。这篇不聊架构不聊榜单,只做一件事——把从下载到本地推理的完整路径走一遍。文中所有数字都来自官方仓库与 HuggingFace 模型页的原文,找不到出处的会明确标注以官方说明为准。
模型去哪下:官方渠道盘点
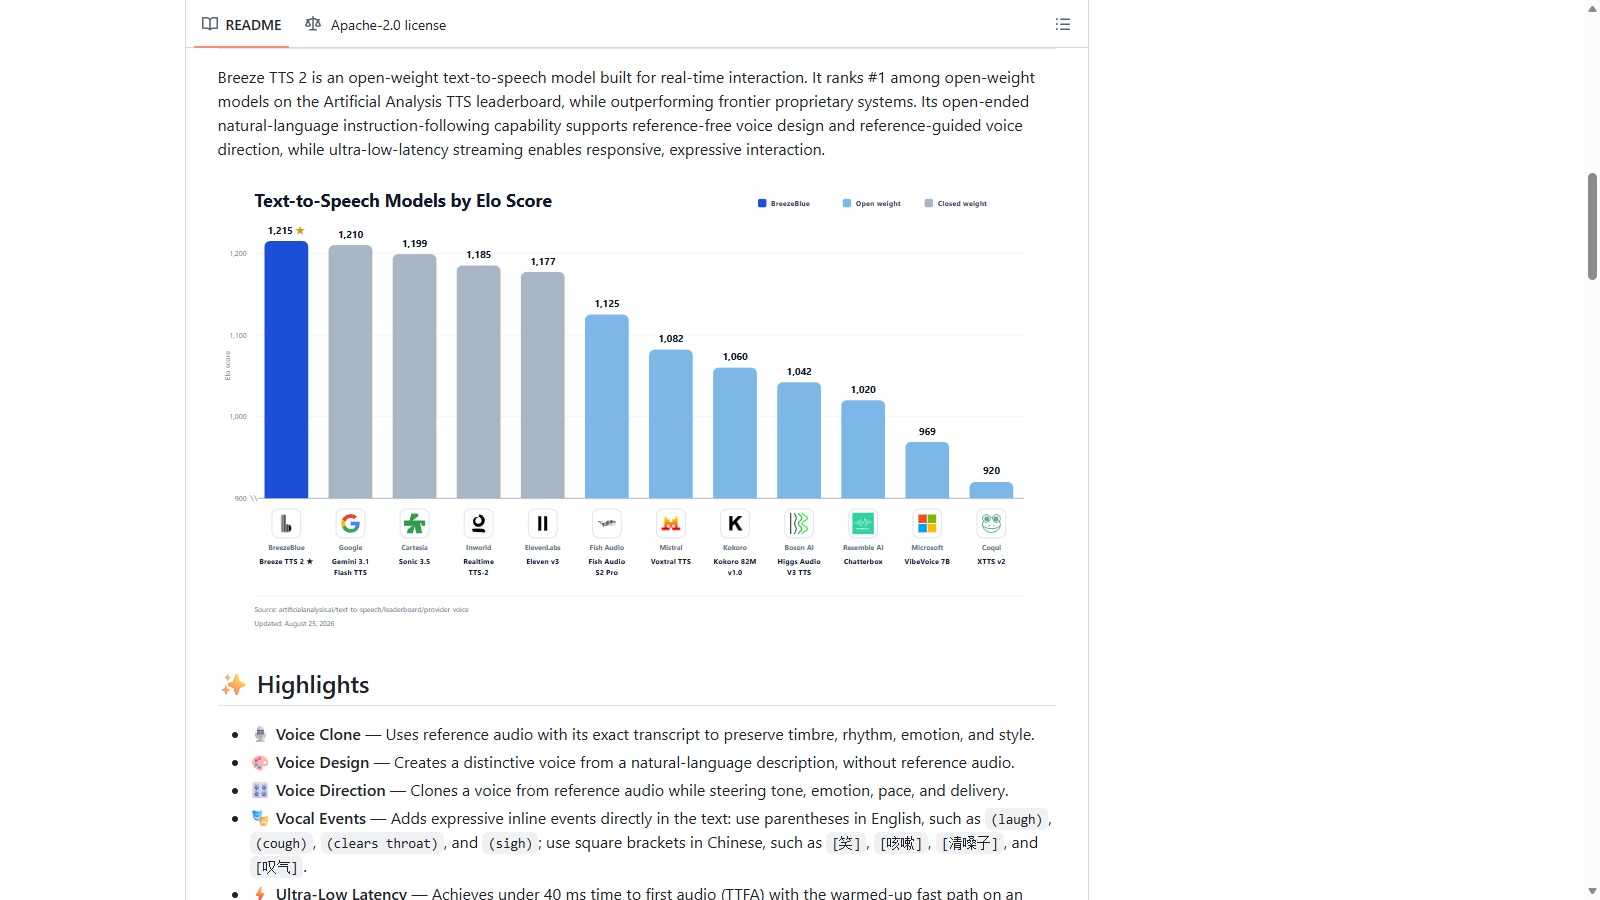
先说结论,Breeze TTS 2 的正规下载入口只有两个,认准就不会下到山寨货。第一个是官方 GitHub 仓库 github.com/breezeblue-ai/breeze-tts,这里放的是 PyTorch 推理代码和安装文档,README 就是第一手教程,克隆代码也从这里走。第二个是 HuggingFace 模型页 huggingface.co/BreezeBlue/Breeze-TTS-2,模型权重以 Safetensors 格式发布,页面标注参数量为 3B,张量类型为 F32 与 BF16,下载量和文件列表都在这一页查。
实际操作时两个都要用:代码从 GitHub 拉取,权重既可以手动从 HuggingFace 下载,也可以直接在命令里填仓库 ID 让程序自动拉取。国内网络直连 HuggingFace 经常超时,社区常用的 hf-mirror 镜像站可以按同样的仓库路径访问,实测能打开模型页,但它属于第三方镜像,页面内容以官方站为准。另外提醒一句,官方在 HuggingFace 页面明确写了权重的授权方式:源代码按 Apache 2.0 开放,权重本身只限研究和非商业用途,商业使用需要另行获得授权。
环境要求:动手前先对表
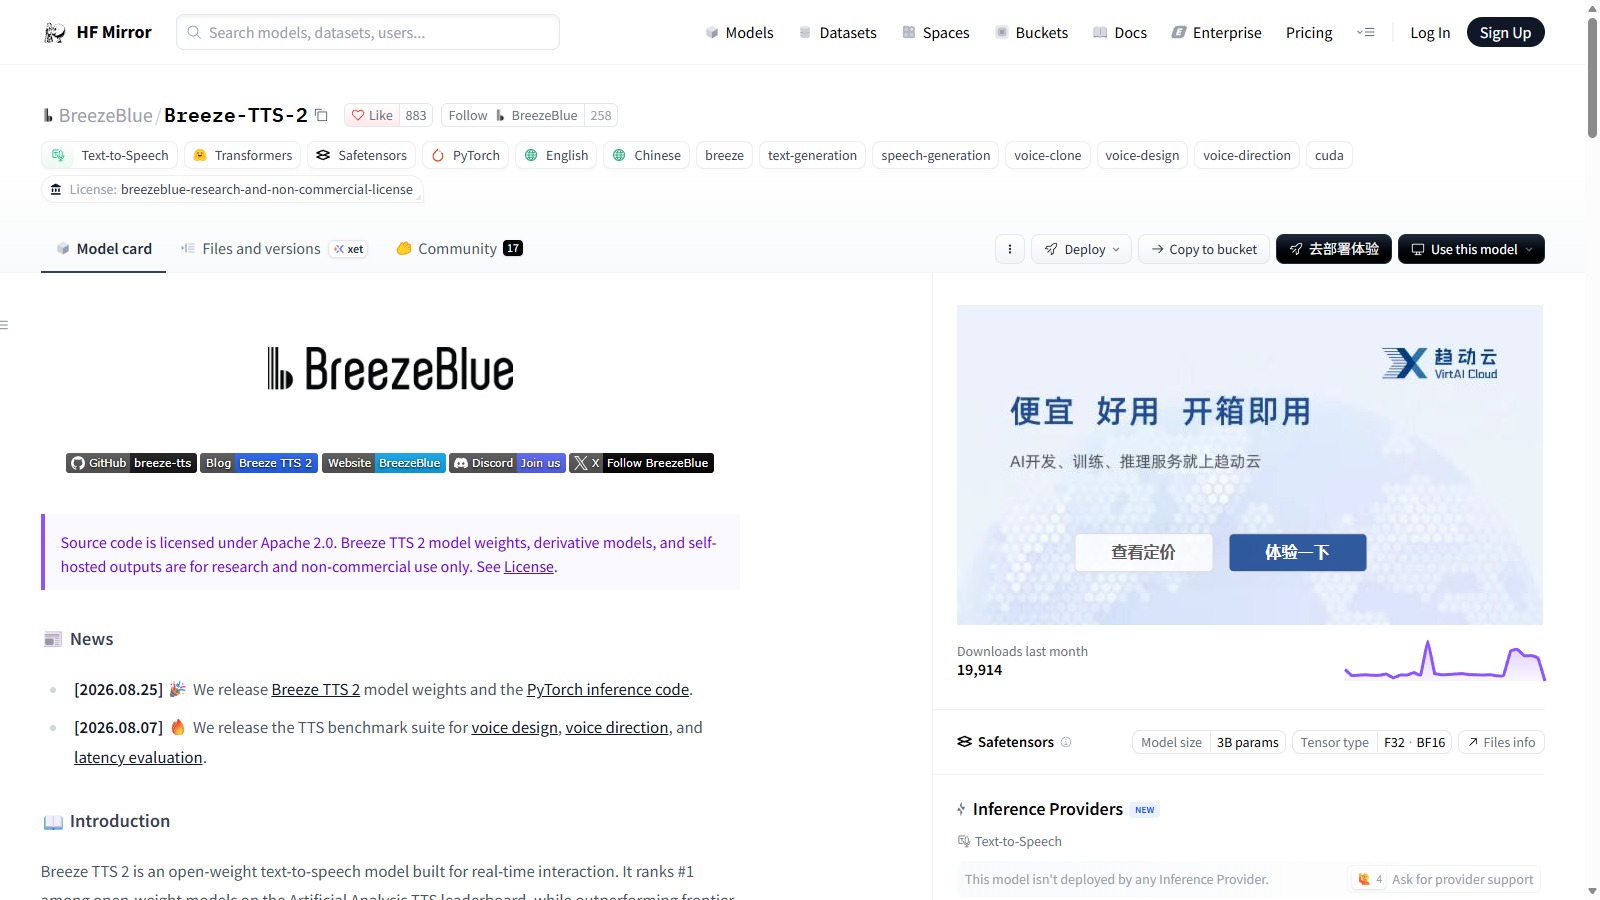
这一步劝退了不少人,与其装到一半报错,不如先逐项核对。按官方 README 的原文要求:操作系统是 Linux,Python 需要 3.10 或更新版本,GPU 必须是支持 CUDA 的 NVIDIA 显卡。显存方面写得很具体——普通 eager 推理大约占用 7.7 GiB,官方建议至少配一张 12 GB 显存的卡;启用 --fast-all 快速路径后显存占用升到约 14.4 GiB,对应建议 24 GB 的 GPU。
对普通用户来说,手里是 12 GB 级别的消费卡(比如 3060 12G、4070 这一档),走默认 eager 模式是够的;显存 24 GB 的 4090 用户才能舒服地开快速路径。显存低于 12 GB 的设备官方没有给出可用方案,不建议硬试。Mac 用户注意,官方仓库面向 Linux 与 NVIDIA GPU,苹果芯片上跑的是社区移植版本,安装方式以对应移植仓库的说明为准,本文只覆盖官方路线。
安装步骤:从拉代码到装依赖
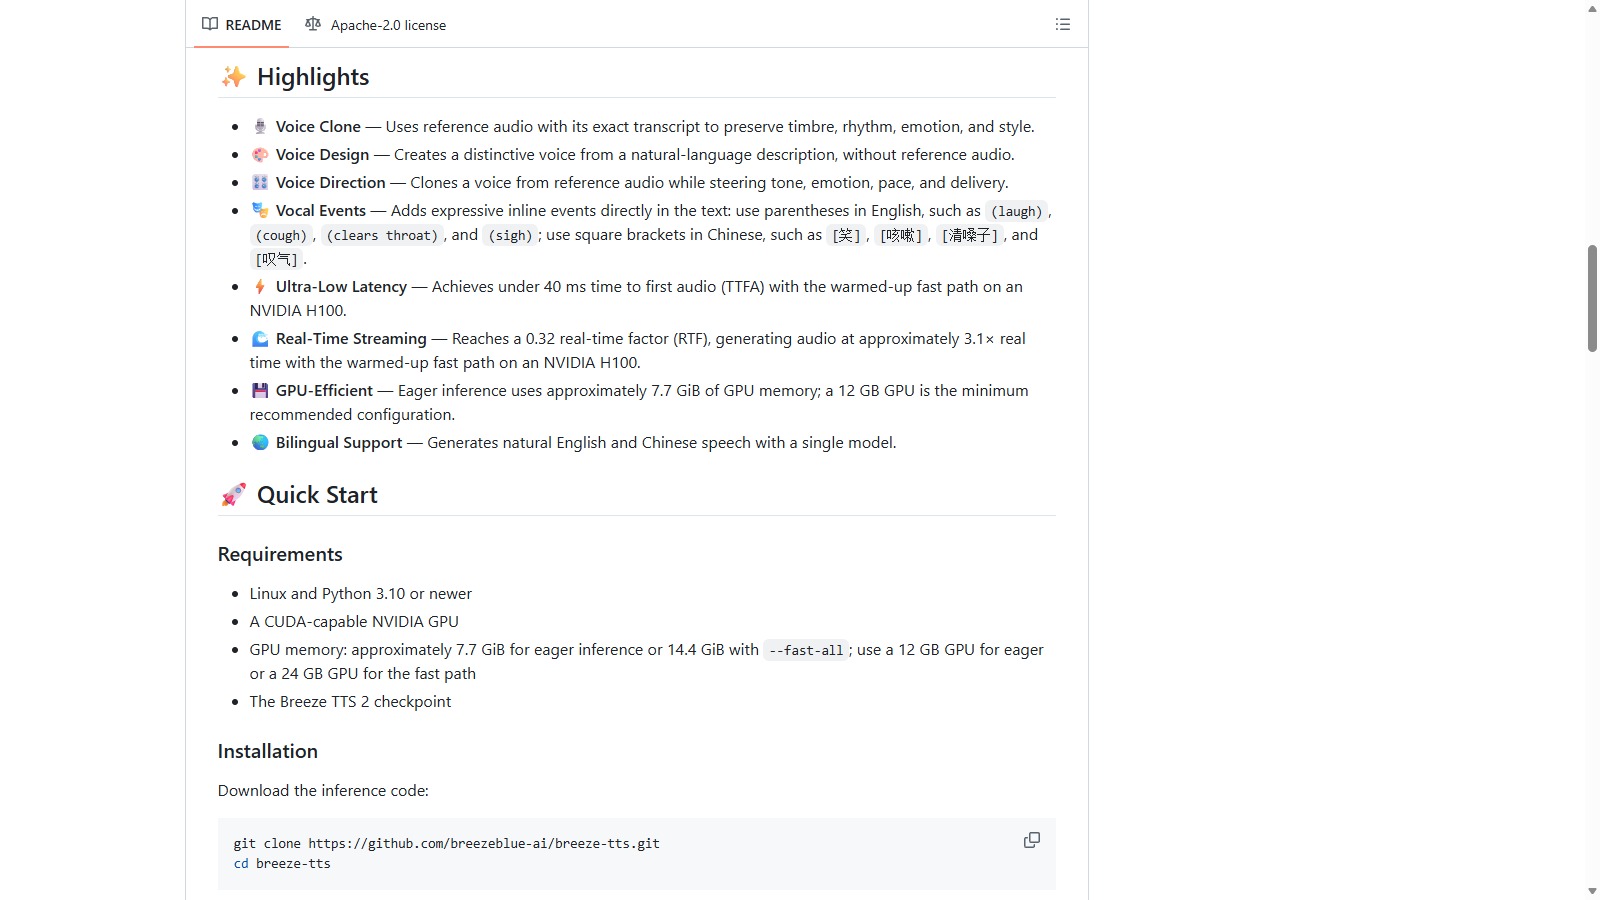
环境对上号之后,安装本身其实很短。第一步把推理代码克隆下来,在终端里执行 git clone https://github.com/breezeblue-ai/breeze-tts.git,然后 cd breeze-tts 进入目录。第二步安装依赖,官方给的命令是 python -m pip install -r requirements.txt,用 pip 走清华源之类的国内镜像可以明显提速。官方特别说明,所有必需的模型组件都包含在 Breeze TTS 2 检查点里,不需要单独再装一堆附属模型。
如果你的机器就是官方测试过的 CUDA 环境,也可以选择 Docker 路线,执行 bash docker/build.sh 构建自带镜像。默认镜像针对 H100/Hopper 架构,A100 用户要在命令前加 FLASH_ATTN_CUDA_ARCHS=80 再构建,这个细节 README 写得很清楚。权重的存放位置有两种等价写法:一是提前把检查点下载到本地目录,命令里填路径;二是直接填 HuggingFace 仓库 ID,首次运行时自动下载到默认缓存目录,之后走本地缓存。
推理实操:跑通第一段语音
官方 README 的入门玩法是语音克隆。准备一段干净的参考音频(无循环、背景噪音尽量少),加上与音频逐字一致的文字稿,然后执行 python infer.py 加四个参数:--ref-audio 指向参考音频,--ref-text 填它的准确转写,--text 填要合成的正文,--output 指定输出 wav 路径。仓库里同时给了中英文两组示例命令,中文示例连[叹气]这类情绪标记都演示了。这里最容易踩的坑是参考音频里若有重复说的话,文字稿也必须把重复部分写全,否则克隆效果会打折。
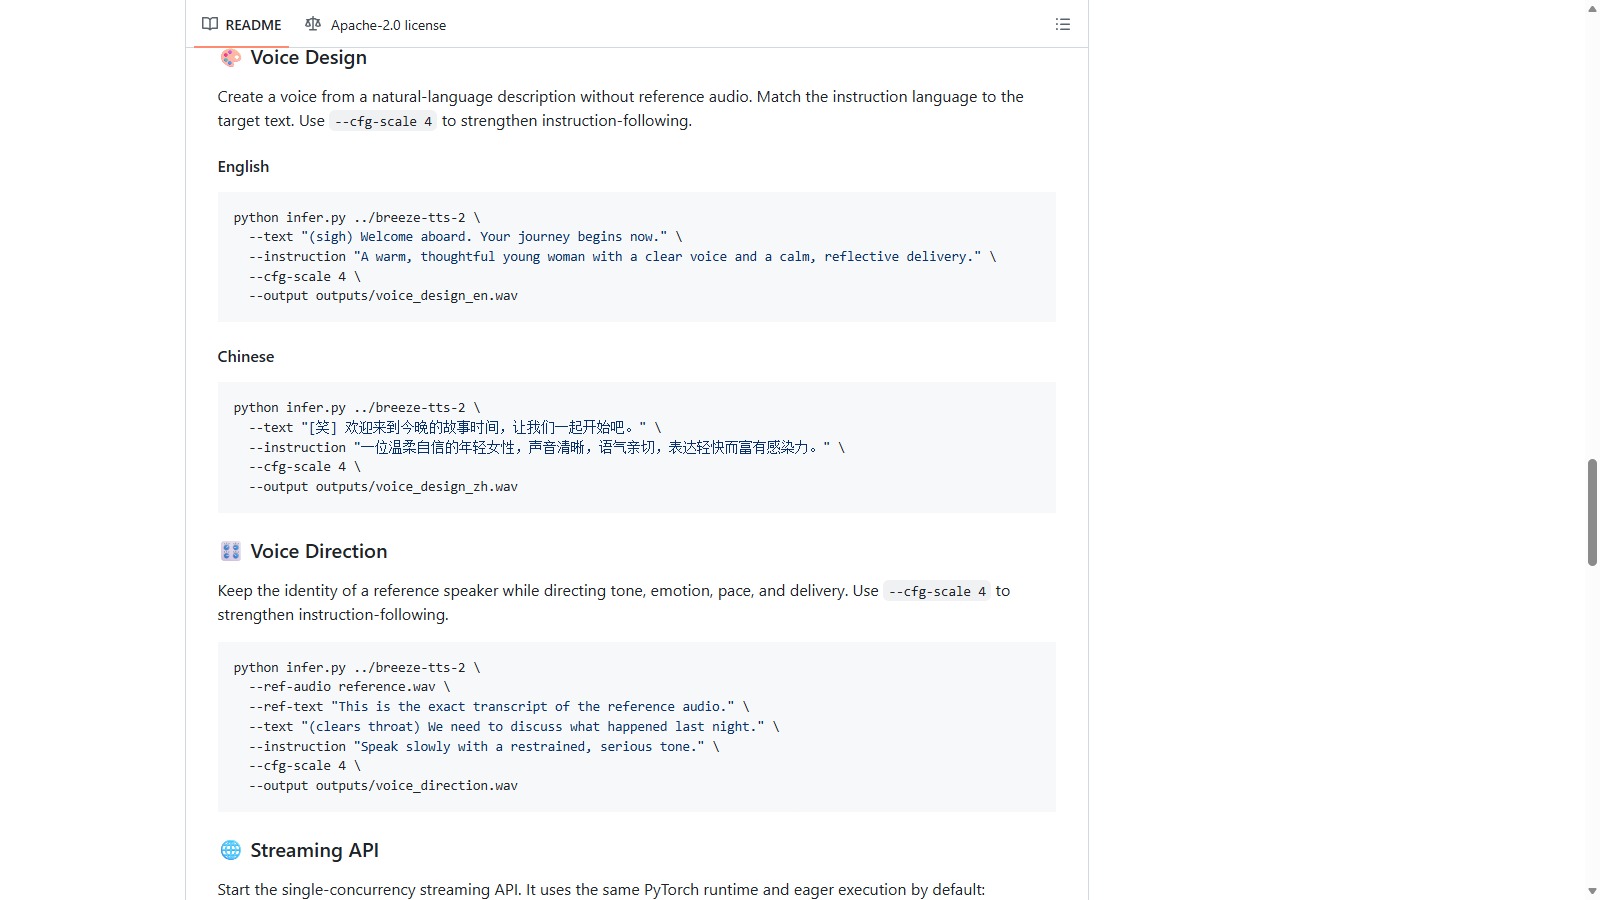
手头没有合适参考音频的话,可以试语音设计:不带 --ref-audio,只给 --instruction 写一句自然语言描述,比如温柔清晰的年轻女声、语速平缓,再配 --cfg-scale 4 强化指令遵循,官方提示描述语言最好和目标文本语言一致。在克隆的基础上加 --instruction 就变成语音导演模式,可以控制语气、情绪和语速。想给应用调用的话,官方自带流式 API:执行 python -m breeze_infer.api 加模型路径和 --host 0.0.0.0 --port 7860 启动服务,然后用 curl 向 /v1/audio/speech 端点发 POST 请求,返回的是 24 kHz 单声道 16 位 PCM 流,加 --fast-all 可启用快速路径。
常见报错与避坑清单
- 报显存不足(out of memory):先确认是不是在快速路径下跑的,--fast-all 需要 24 GB 级显卡;12 GB 卡老老实实用默认 eager 模式。
- 依赖安装阶段就失败:多半是 Python 版本低于 3.10,或者 CUDA 驱动太旧,先用 python --version 和 nvidia-smi 核对环境。
- 克隆出来的声音不像:检查 --ref-text 是否和参考音频逐字一致,音频本身是否干净、有没有循环拼接的痕迹。
- 权重自动下载卡住:国内直连 HuggingFace 超时是常态,切换镜像或手动下载检查点后填本地路径更稳。
- 在 Windows 上直接跑官方仓库:官方要求是 Linux,Windows 用户建议走 WSL2,路径写法和权限问题会少很多。
- 想拿去接商用项目:权重许可证只覆盖研究和非商业用途,商用要联系官方获得书面授权,别抱着开源等于随便用的想法。
本地部署与云端 API 怎么选
两条路线的取舍其实很清晰。本地部署的好处是零调用成本、数据不出本机、可以随便折腾克隆和设计玩法,代价是一张 12 GB 起步的 NVIDIA 显卡和一套 Linux 环境,而且输出只能用于非商业场景。官方托管服务走付费订阅,不挑本地硬件,订阅产生的输出可按服务条款商用,适合要接进产品的团队。实际用下来,个人玩家和学习用途选本地,商业项目走托管,是最省心的分配。
总结
整个流程串下来就是四步:GitHub 拉代码、pip 装依赖、从 HuggingFace 拿权重(或直接填仓库 ID 自动下载)、用 infer.py 或自带 API 跑推理。官方文档写得相当完整,命令都可以原样照抄,真正的门槛集中在硬件和网络上。
注意事项如下:
- 本文涉及的显存数字、参数量、许可证条款均摘自官方仓库与 HuggingFace 模型页原文,版本更新后请以官方页面最新说明为准。
- 克隆声音务必使用自己有权使用的音频,未经授权复刻他人声音属于明确禁止的用途。
- 镜像站仅作访问困难时的参考,下载请以官方渠道为准。
免责声明:以上评论仅代表网友个人观点,不代表官方立场。
