做会议纪要、整理访谈、给客服录音归档的人,多半都被语音转录取折磨过:转录是一个模型,区分说话人是另一个模型,翻译还得再接一个,三个工具来回倒腾,时间戳还老对不上。10 月 28 日,英伟达开放了语音转录模型 Nemotron 3.5 Transcribe 的权重,把转录、说话人归属、翻译和音频问答塞进了同一个检查点,还同步公开了配套的训练数据管线 Granary v2。对普通用户来说,最直观的变化可能是:以后一段八个人抢着说话的录音,它也能逐句标注清楚谁说了什么。
一个模型包揽四件事
先看基本盘。Nemotron 3.5 Transcribe 采用混合专家(MoE)架构,总参数约 340 亿,每个词元实际激活的参数量只有约 43 亿,基于 Nemotron 3.5 Lightning 混合 Mamba-Transformer 底座搭建,外面接了一个 Transformer 语音编码器和一个冻结的 Nemotron 3 说话人分离模型。官方给这套结构起名叫语音增强语言模型(SALM),说白了就是让大语言模型直接「听懂」音频,而不是像传统方案那样先转文字再交给语言模型处理。
能力清单相当长:最长可处理 1 小时的录音;转录覆盖 40 种语言,其中 31 种可与英语互译;说话人标注支持 13 种语言;音频问答能力则基于英语训练。更关键的是,这些能力全部通过自然语言提示来调度。开发者可以直接下达指令:「转录这段录音并标注每位说话人」「把这段音频翻译成英语」,甚至「这次会议上做了哪些决定」。遇到医疗、金融这类专业场景,还可以把药品名、产品术语等专有名词写进提示词,让模型按指定写法输出数字与术语,不用重新训练。
八人抢话也能分清谁在说
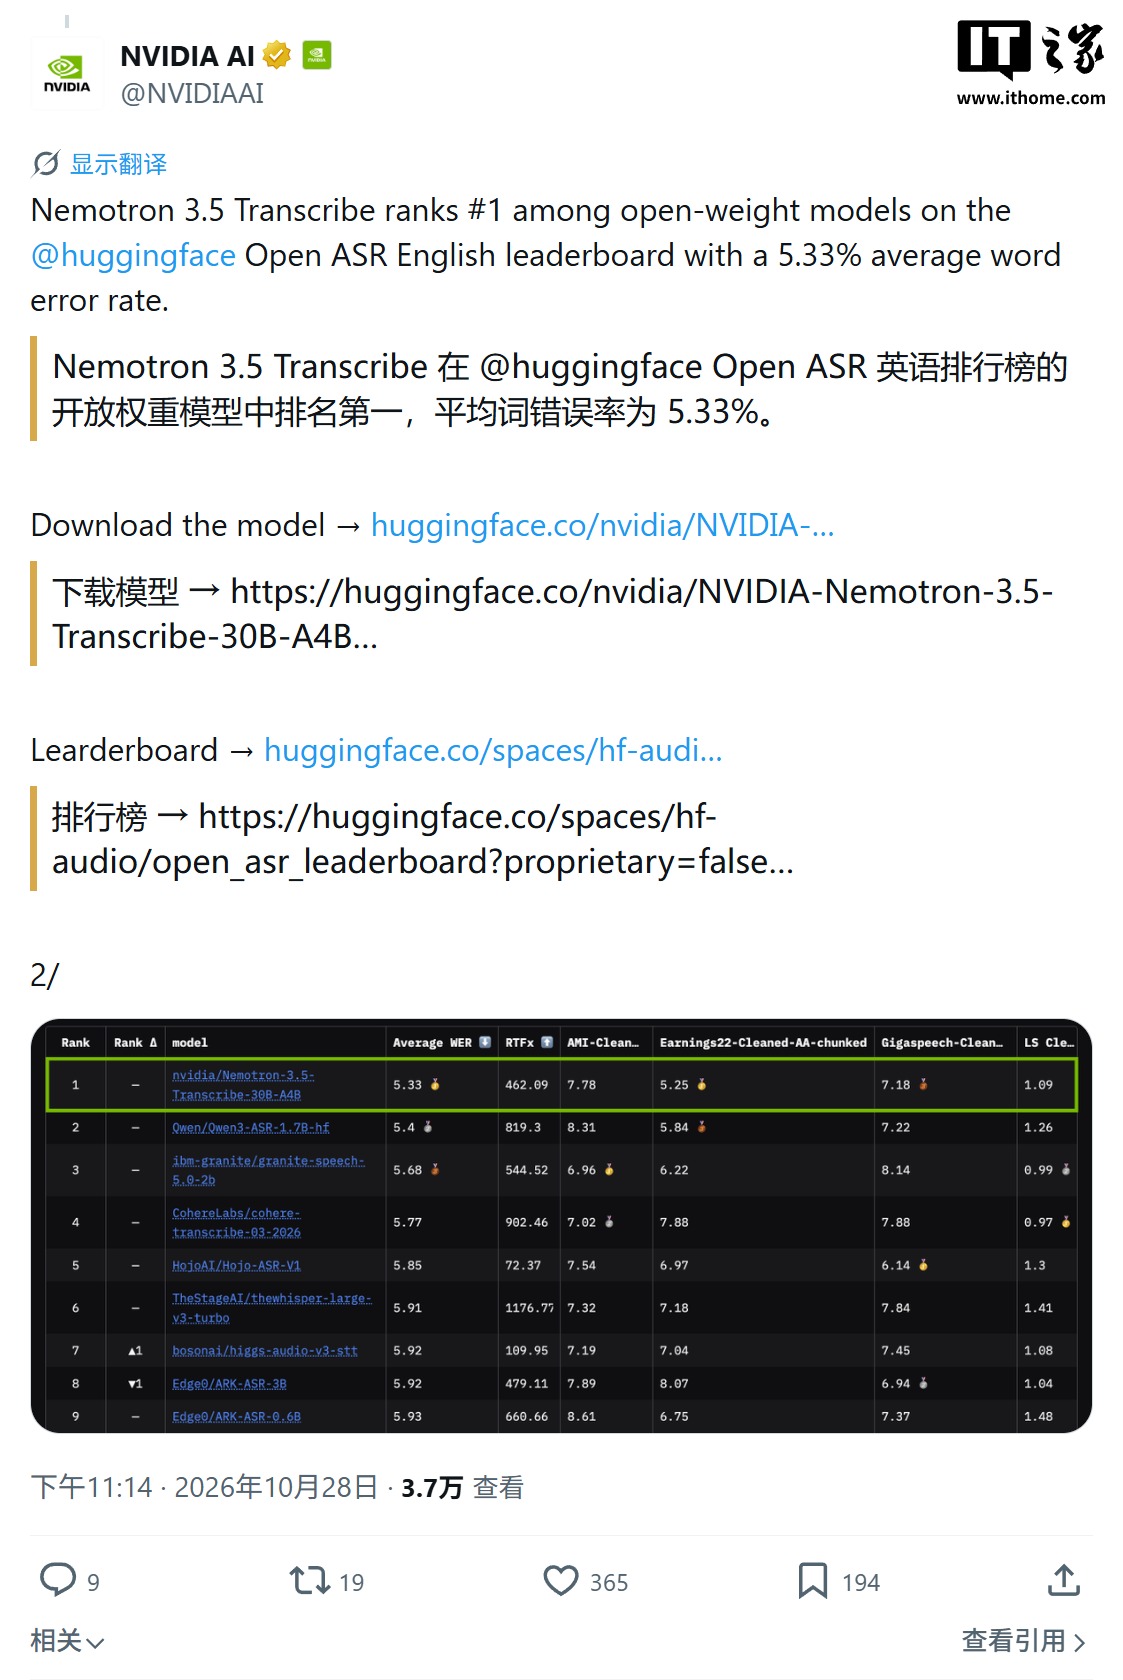
多人同时开口,一直是语音识别领域最头疼的场景。Nemotron 3.5 Transcribe 在生成文本的同时就为每段发言打上说话人标签,而不是先转录完再回头补标。官方演示里,它对 1940 年电影《他的女友礼拜五》中语速极快、大量重叠对白的片段,也能按角色生成带说话人标签的字幕,最多可区分 8 名说话人,并支持请求返回词级时间戳。
第三方评测同样给了正面反馈:在 David AI 覆盖 21 种语言的说话人分离基准中,它录得 18.26% 的最低错误率,超过了英伟达自家的专用分离模型 Nemotron 3 Diarization;在 VoiceArena 的 14 系统对比中,其 cpWER 低至 32.4%,同样排在第一,删词率 8.32% 远低于约 31% 的中位数。对开发者来说,这意味着一个模型就有机会替掉过去「转录+分离+标注」的三段式流水线,维护成本能实打实地降下来。
准确率到底什么水平
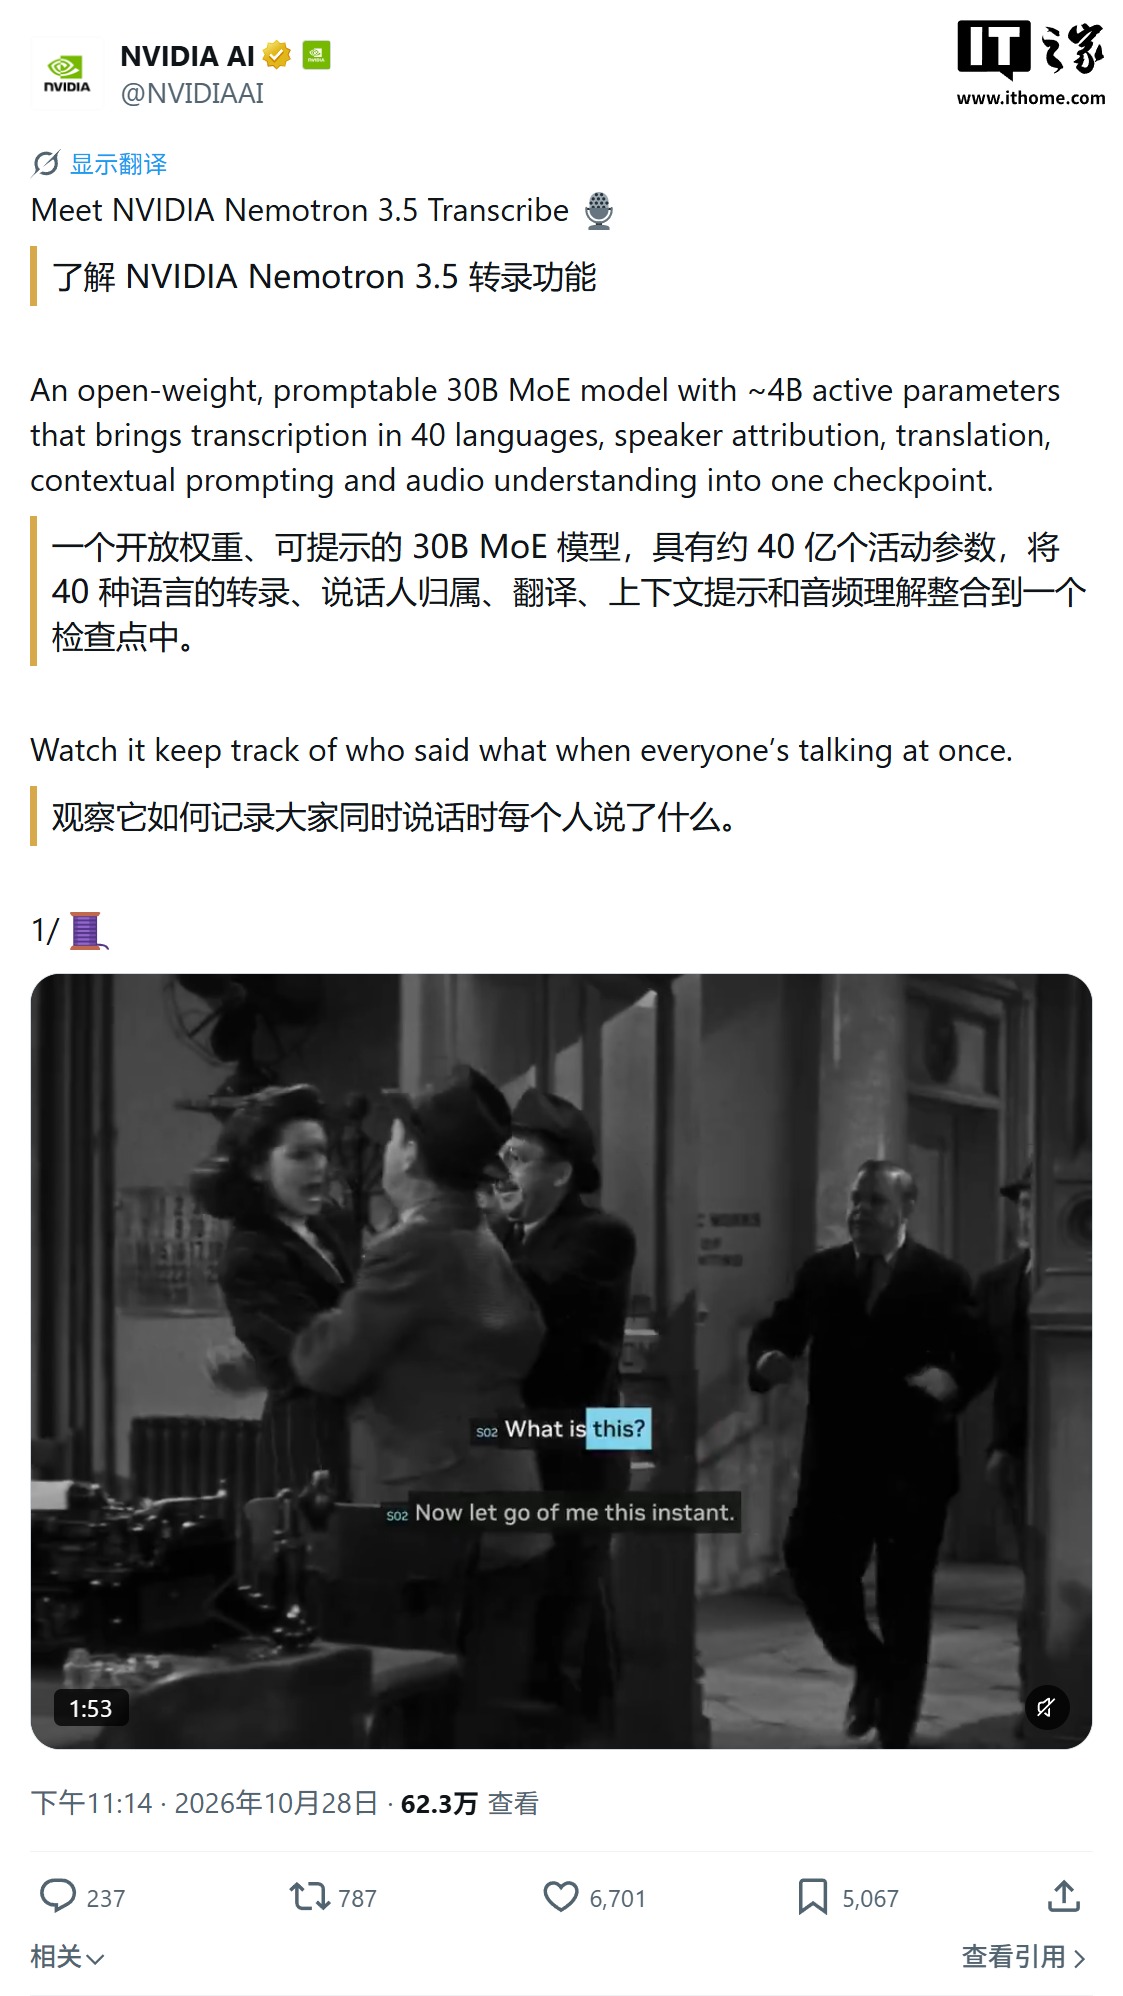
在 Hugging Face Open ASR Leaderboard 英语组,Nemotron 3.5 Transcribe 以 5.33% 的平均词错误率位居开放权重模型第一;多语言组平均词错误率 4.62%,长音频组 10.98%,同样是开放权重阵营的最低水平。在 Artificial Analysis 的非流式词错误率指数中,它以 2.8% 的成绩与 Voxtral Small Transcribe 并列开源模型首位——但后者的激活参数约为 240 亿,而它只有约 43 亿,效率差距一目了然。在面向语音智能体的 AA-AgentTalk 测试集上,它录得 1.8% 的词错误率,比第二名开放权重模型的 2.3% 更低。官方还表示其成绩领先多个广泛使用的专有语音 API。
另一个亮点是上下文提示带来的纠错能力:给定一份预期实体清单后,它在 ContextASR-Bench 上的专有名词错误率降到了原来的约六分之一。对于人名、药名、型号满天飞的真实录音,这类能力比榜单数字更有实际价值。当然,官方自己也提醒,口音、噪音和领域黑话都会影响实际表现,关键人名和说话人切换处建议人工抽查。
开源许可与商用门槛
模型已在 Hugging Face 与 ModelScope 免费开放,采用 OpenMDW-1.1 许可证,对二次分发和商用都相当宽松。权重提供 BF16、FP8、NVFP4 和 GGUF 多种格式,配套的 NeMo Speech 工具包还包含微调脚本,官方给出的参考数据是:在单张 GPU 上针对新语言、新领域或新任务做适配,通常只需 0.5 到 2.3 GPU 小时。
数据侧的公开同样有分量。同步释出的 Granary v2 数据清单覆盖 463,062 小时音频、48 种语言、16 个源语料库,比上一代的 25 种语言明显扩展。它能对同一段录音自动生成三种书面风格的转录:保留「呃」「嗯」等不流畅表达但规范数字写法的逐字稿、把口语数字还原为符号的版本,以及去除不流畅表达的干净文本。举个例子,同一段话可以分别输出为「I paid, uh, twenty-five euros」「I paid, uh, €25」和「I paid €25」,对应模型可被提示要求的不同输出风格。医疗场景的公开案例更能说明问题:某印度医疗语音项目里,仅靠优化提示词就把词错误率从 30.8% 压到 23.8%,再用 NeMo Speech 微调后进一步降到 11.8%。
本地部署与实际使用场景
得益于每词元仅约 43 亿的激活参数,这个模型对硬件的要求比同精度水平的同行友好不少。官方列出的支持范围从 Jetson AGX Thor、DGX Spark 这类桌面级设备,到 GeForce RTX 5090 消费级显卡,再到数据中心 Blackwell GPU 都能跑,NVFP4 版本可通过 vLLM 或 NeMo-Speech.cpp 部署,服务端则通过 Nemotron Transcribe NIM 提供。推理效率方面,配合原生多词元预测投机解码,单张 RTX PRO 6000 Blackwell GPU 每秒可转录超过 2200 秒的音频。
实际用下来,它面向的是录制完成的音频而非实时直播流:会议纪要、课堂录像、播客整理、访谈归档、多语言客服质检都是典型场景。有实时语音平台已经用它的词级时间戳做出了「转录稿与课堂回放同步对照」的演示。对普通用户来说,等量化版本和本地工具链跑顺之后,在自己的设备上离线转录一小时会议录音,应该会是一件相当平常的事。
网友评论
- 「八个人抢话都能分清,字幕组和做播客纪要的人狂喜,就看实际噪音环境下稳不稳了。」
- 「340 亿总参数,我那张 4070 显存 12G 就别想了,坐等量化版和 GGUF 生态跟上。」
- 「40 种语言里中文表现怎么样?有实测过的朋友出来说说,方言混普通话的场景能打吗?」
- 「OpenMDW-1.1 这个许可证能直接商用吗?想接进公司的会议纪要系统,法律条款看不太懂。」
总结
把转录、说话人归属、翻译和音频问答收进一个提示词可调度的开放权重模型,是这次发布最实在的价值:参数效率够高,基准成绩够硬,许可证够宽松,连训练数据管线都一起开放了。短期内它未必能立刻取代每个人的现有工具链,但「一个模型搞定整条语音转录流水线」这件事,已经从构想变成了可以下载试用的现实。值不值得上手,取决于你的录音有多乱——录音越混乱、说话人越多,它的价值就越明显。
