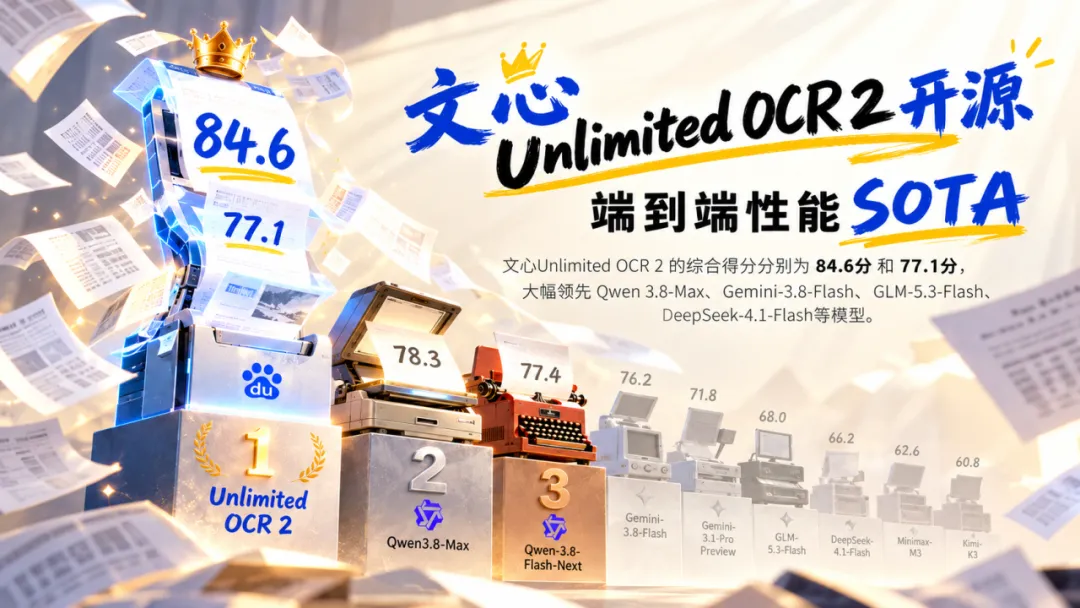
10 月 27 日,百度发布并开源文心 Unlimited OCR 2,主打一个听上去很夸张的能力:任意页数文档解析。官方实测口径里,它一次性读完了累计超过 3600 页的《哈利·波特》全系列和超过 1200 页的《三体》,并给出两个基准的 SOTA 成绩。这篇不打算复述通稿,而是把技术机制、官方成绩单和市场横向对比一次讲清,数字都标了出处,包括那些需要打折看的部分。
从单页到无限:三代演进
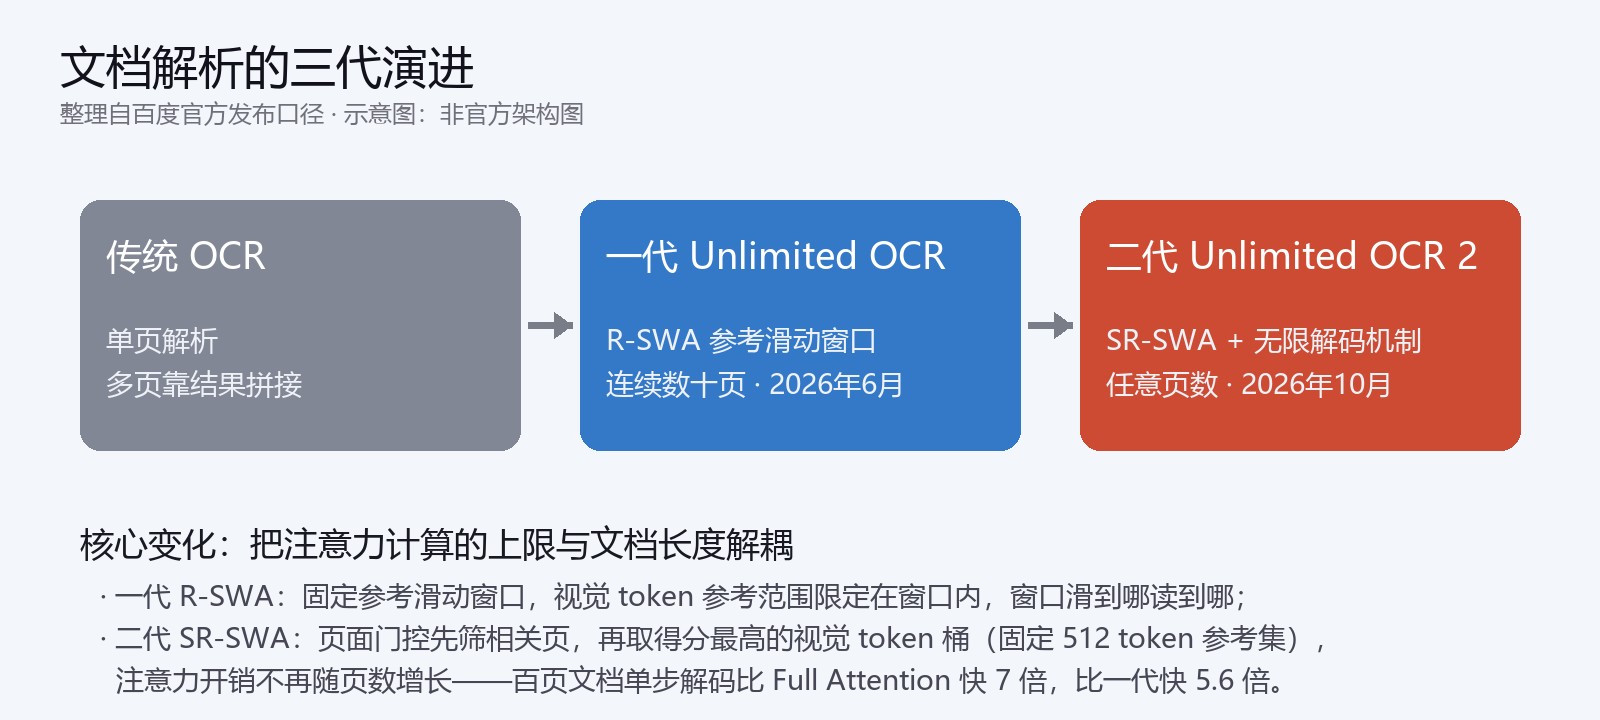
先理清谱系。传统 OCR 的解析范围基本局限在单页,多页任务靠结果拼接,页与页之间的表格跨页、阅读顺序、指代关系全靠后处理规则硬补。第一代 Unlimited OCR 在今年 6 月 22 日发布,引入参考滑动窗口注意力 R-SWA,把连续解析范围拓展到数十页,发布次日登顶 GitHub Daily Trending 总榜和 Python 榜、HuggingFace 全球模型总趋势榜和多模态趋势榜,五天破万星。第二代就是这次的 Unlimited OCR 2,用 SR-SWA 加无限解码机制把「数十页」的上限改成「任意页数」,官方称推动文档解析进入 OCR 3.0 时代。
这两代的共同思路是把注意力计算的上限与文档长度解耦。一代靠固定窗口滑动——窗口滑到哪读到哪,开销恒定但只能看到局部;二代在此基础上补了跨页回看的能力,这正是长文档里最难的部分:第 300 页的表格可能引用第 20 页的定义。
SR-SWA:把注意力预算花在刀刃上
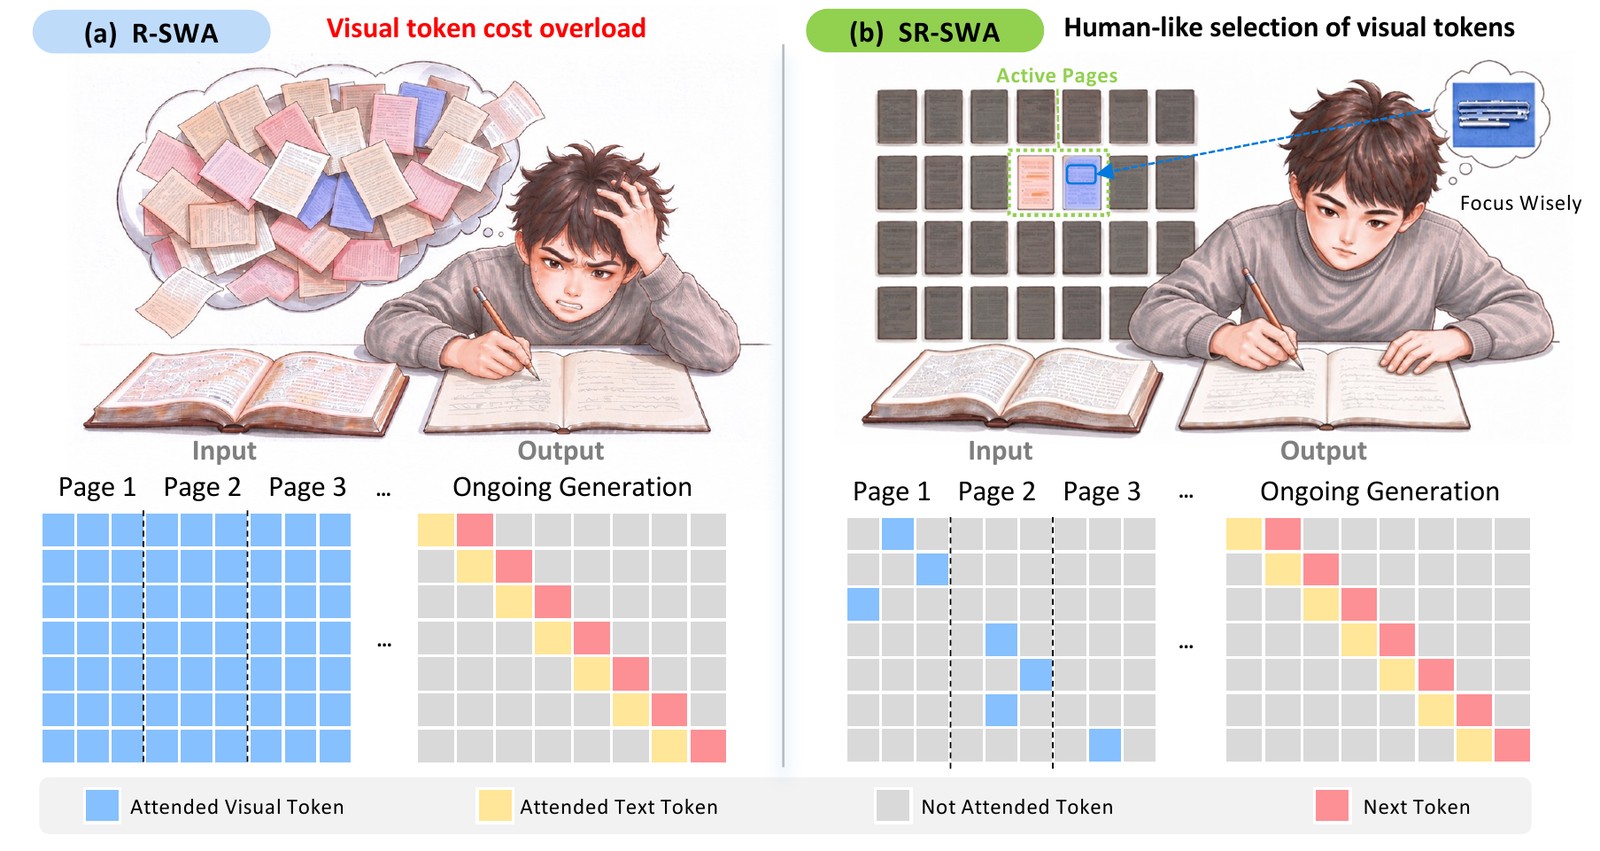
SR-SWA 的全称是稀疏参考滑动窗口注意力,官方给的灵感类比是人类抄书:抄写时专注当前页,只在需要核对前文时才回头翻,而不是每写一个字都重读整本书。落到机制上是两级筛选:页面门控 Page Gate 先把每个查询的视觉参考范围从整个文档缩小到少数相关页面,同时建模跨页位置关系;随后在这些页面里取出得分最高的视觉 token 桶 Token Buckets,捕捉长距离视觉依赖。社区部署分析指出,参考集被压缩到固定的 512 个 token,这意味着每步解码的延迟和显存占用与文档总长度基本无关——百页文档场景下,单步解码速度比 Full Attention 快 7 倍,比一代 R-SWA 快 5.6 倍。
配合的无限解码机制负责控制超长输出的计算与显存开销。还有一个不太登台但很实用的细节:社区分析发现推理代码内置了 35-gram 禁重复处理器,单页窗口 128 token、多页窗口 1024 token——3600 页一口气读完不陷入复读机循环,这类反退化机制功不可没。
官方成绩单:84.6 与 77.1
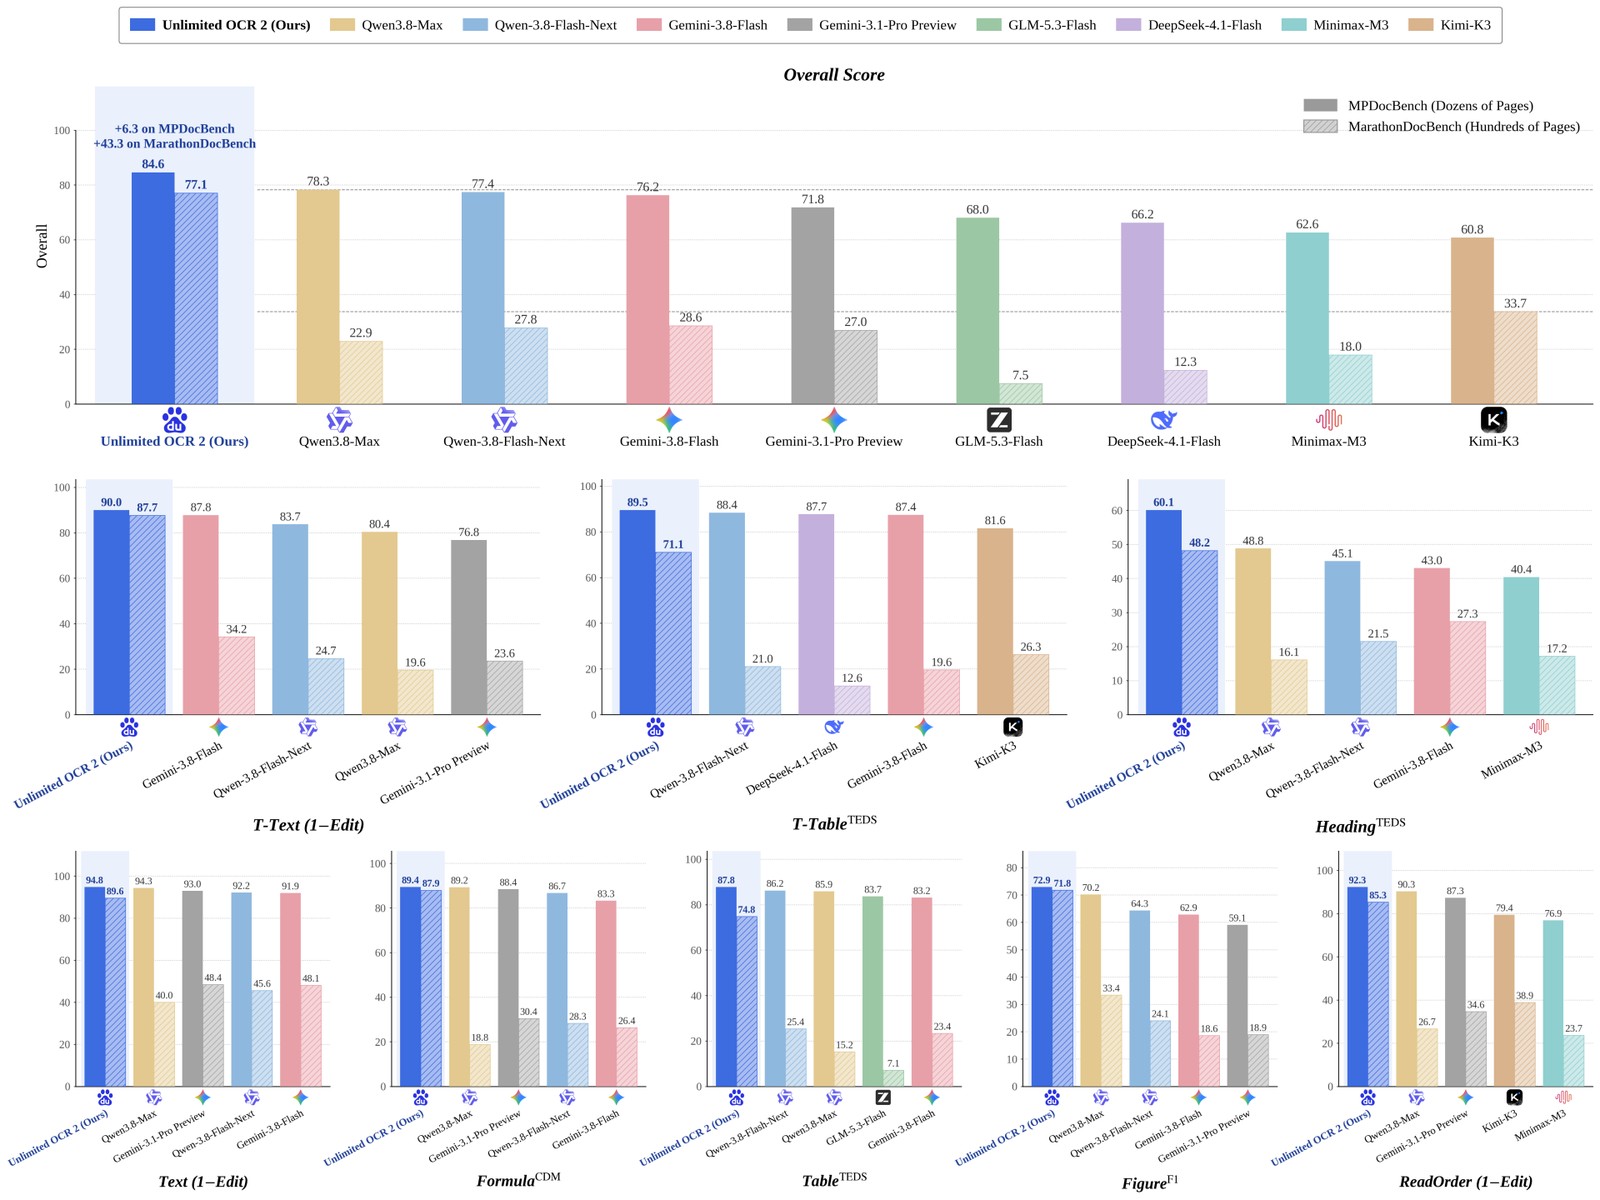
基准是两个。MPDocBench 面向数十页文档,公开的 Parse 子集包含 433 份文档、3246 页;MarathonDocBench 专门评估百页级超长文档,10 月 27 日随模型一起在 HuggingFace 公开了数据集。Unlimited OCR 2 的综合得分分别为 84.6 和 77.1,官方口径为端到端 SOTA,领先 Qwen 3.8-Max、Gemini-3.8-Flash、GLM-5.3-Flash、DeepSeek-4.1-Flash 等模型。分项看,数十页基准上文本 94.8、公式 89.4、阅读顺序 92.3、表格 87.8,都相当扎实;最弱的是标题层级,只有 60.1,到了百页基准进一步掉到 48.2——长文档里层级结构混乱仍然是这类模型的共同软肋。
市场横向对比:断崖与三条路线
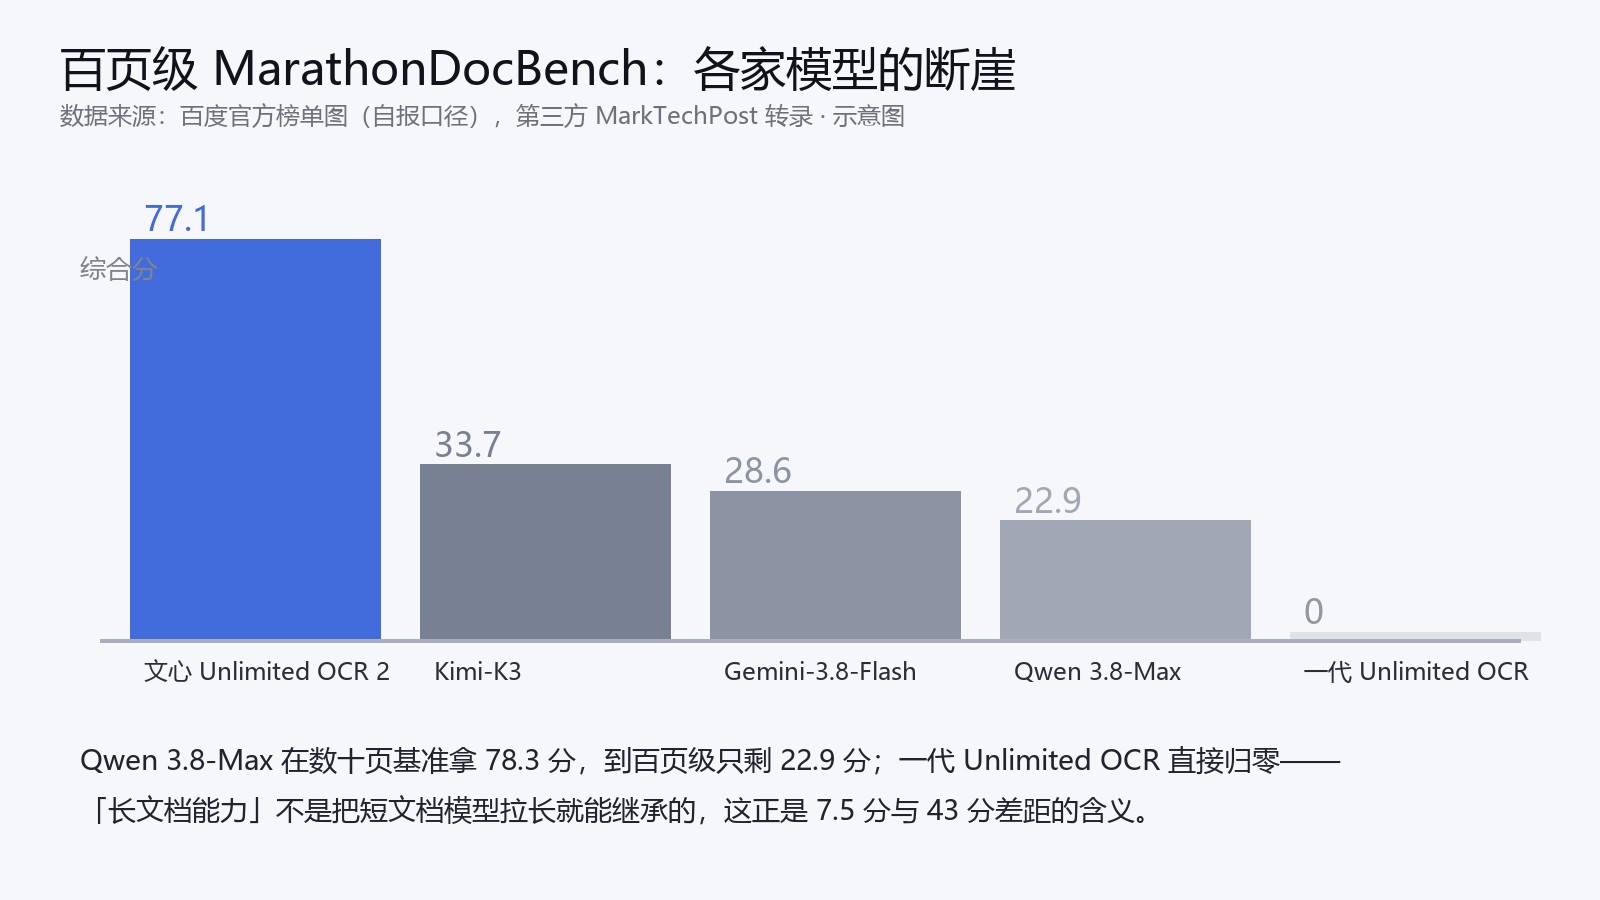
真正有信息量的是百页基准上的断崖。第三方 MarkTechPost 转录的官方榜单图显示:MarathonDocBench 上 Unlimited OCR 2 拿 77.1,第二名 Kimi-K3 只有 33.7,Gemini-3.8-Flash 28.6,Qwen 3.8-Max 剩 22.9,一代 Unlimited OCR 直接归零。最扎眼的是 Qwen 3.8-Max——它在数十页基准拿 78.3 分,只比 OCR 2 低 6.3 分,到百页级却掉了 55.4 分。这说明长文档解析能力不是短文档能力的自然延伸,上下文长度、注意力退化、显存墙会在某个页数阈值上集中爆发。
把开源阵营的主要玩家排开,能看到三条不同的技术路线。百度自家就有两个:文心 Unlimited OCR 2 走注意力机制改造,3.34B 参数、MIT 许可;同门的 PaddleOCR-VL-1.6 只有 0.96B、Apache 2.0,走轻量专精路线,工程生态成熟但这次没有报 MPDocBench 成绩。DeepSeek 的 DeepSeek-OCR-2 是 3.39B、Apache 2.0,走光学上下文压缩路线,把长文档压成极少量视觉 token,思路激进但长文档官方成绩同样未报。三条路线的分野很清晰:改造注意力换长度上限,压缩表示换吞吐成本,缩小模型换部署门槛。
冷静看待:自报口径与工程门槛
必须指出:两个基准的综合得分全部来自百度自家榜单图,第三方只是转录,目前没有独立复现;MarkTechPost 也确认 MPDocBench-Parse 是公开基准,但榜单数字仅以图表形式存在。选型时把它当作「厂商定义的赛道里谁领先」更稳妥。工程侧的门槛也在:推荐部署用百度定制的 SGLang wheel 而非上游版本,Transformers 加载需要 trust_remote_code=True,长文档服务默认按 10 页一个窗口复用 KV 尾部,默认偏置设置有单次 462MiB 的显存分配警告,PDF 输入要先栅格化成图片而非原生解析。这不是开箱即用的玩具,是要读文档调参数的工程件。
社区热度与下一步
社区数据是实打实的:第一代发布次日四榜第一,五天 GitHub 破万星;截至目前 HuggingFace 累计下载突破 1000 万次,GitHub 星数 2.85 万以上(官方公众号口径 2.88 万),并拿到 Yann LeCun 的转发推荐。11 月 12 日百度世界 2026 大会将继续展示这个项目的技术与应用进展。对文档密集型行业——研报、招股书、整本书籍的批量结构化——任意页数解析打开的场景确实此前没有现成方案。
开源地址与上手建议
- GitHub:baidu/Unlimited-OCR——推理代码、SGLang 部署文档与评测脚本。
- HuggingFace:baidu/Unlimited-OCR-2——3.34B 权重,MIT 许可。
- ModelScope:PaddlePaddle/Unlimited-OCR-2——国内镜像。
- MarathonDocBench 数据集——百页级超长文档解析基准,已公开可复现。
- arXiv 技术报告:Unlimited OCR Works——一代论文,机制细节看这里。
上手建议按需求分流:只解析单页高清版面,用 infer 单页模式即可,动态切图保证精度;整本书、整份长研报一口气结构化,用 infer_multi 或 SGLang 服务,记得显存给到 80GB 级并检查窗口配置;如果场景以百页文档为主但对层级结构敏感,先拿自己的数据测一下标题层级这一项再决定。
