国产大模型这边又添一员猛将。阶跃星辰(StepFun)的旗舰基座模型 Step 5 Preview,官方在 9 月 20 日正式官宣,总参数量 600B、每个 Token 只激活 27B 的稀疏 MoE 架构,支持 1M Token 上下文窗口和视觉输入,主打真实世界的 Agentic 任务。进入 10 月之后,这款模型登上了 OpenRouter 的模型目录,开发者发现、对比、接入的门槛一下子低了不少,讨论热度也跟着又起了一波。
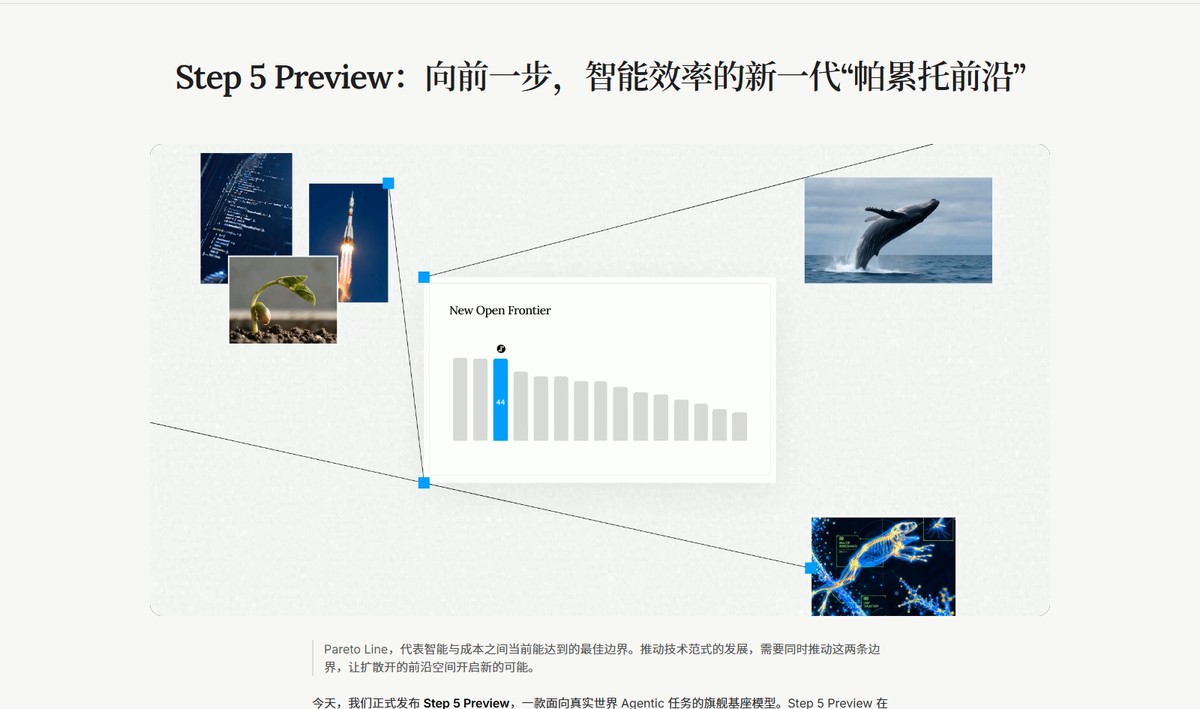
对普通用户来说,最关心的无非三件事:能力到底怎么样、贵不贵、什么时候能白嫖。官方给出的答案是:Artificial Analysis 智能指数 44 分,与 Kimi K3(Max)处于同一水平线,而在相近智能水平下,单任务成本(Task Cost)明显更低——第三方汇总的口径是,比同级领先开源模型大约便宜 65%,也就是成本只有人家的三分之一强,约 1/2.8。更关键的是,官方已明确模型将于 10 月 15 日正式开源,权重很快就能自己拉下来跑。
600B 总参、27B 激活:稀疏 MoE 的效率算盘
先拆一下这组参数。600B 是总参数量,代表模型的容量上限,相当于一个规模庞大的「专家团队」;27B 是每个 Token 实际激活的参数量,占比只有 4.5% 左右。稀疏 MoE(专家混合)架构的做法,是让路由器为每个 Token 挑选一小部分专家子网络参与计算,其余专家这轮休息。这样既保住了大容量模型的知识储备,又不用每一步都把全部参数算一遍。
不过要提醒一句,激活 27B 不等于推理成本等同于一个 27B 的稠密模型。专家路由、显存与通信开销、批次大小、上下文长度、服务端硬件,都会影响实际成本和速度。稀疏激活传递的是「效率导向」的设计信号,而不是成本保证。这一点在评估任何 MoE 模型时都适用,不光是 Step 5。
输入侧,Step 5 Preview 原生支持文本和图像输入,输出最高 64K Token。从官方定价页看,API 价格为每百万 Token 输入 1 美元、输出 2.7 美元,缓存命中时输入低至 0.05 美元——对需要反复跑长上下文的 Agent 循环来说,缓存命中价相当有吸引力。定位上,官方把它描述为面向复杂工作与代理任务的前沿模型,软件工程和金融领域是两个重点倾斜方向。
基准成绩:与 Kimi K3 掰手腕,多项小分反超
官方放出的评测里,最值得看的是它与 Kimi K3(Max)、GLM-5.3(Max)这两个国产旗舰的正面交锋。DeepSWE v1.1 上,Step 5 Preview(High)拿到 67.7,Kimi K3 是 67.5,GLM-5.3 是 66.9——三家咬得极紧,基本同一档位。StepCodeBench 上 Step 5 拿下 49.0,领先 K3 的 43.9 和 GLM 的 40.2;ProgramBench 通过率 80.5%,同样排在两家之前。
当然也有短板。Terminal-Bench v4 上 Step 5 只有 33.3,明显落后于 GLM-5.3 的 41.9;通用 Agent 的 GDPval-AA v2.1 也是 GLM 领先。金融方向倒是相当能打:FrontierFinance 66.4 排在国产三强之首,官方自研的 FinStepBench 三项金融评测(检索、估值、深度研究)也都压过 Kimi K3。而在第三方 Artificial Analysis 智能指数上,44 分的成绩与 Kimi K3 持平——考虑到成本只有大约 1/2.8,这笔账对价格敏感的用户就很直观了。
需要说明的是,StepCodeBench 是阶跃自研基准,多数成绩为厂商自报,目前还没有技术报告和完整的第三方复现。看看就好,别全信,等 10 月 15 日权重放出后社区自然会验一遍成色。
编程与长程任务:demo 有几分含金量
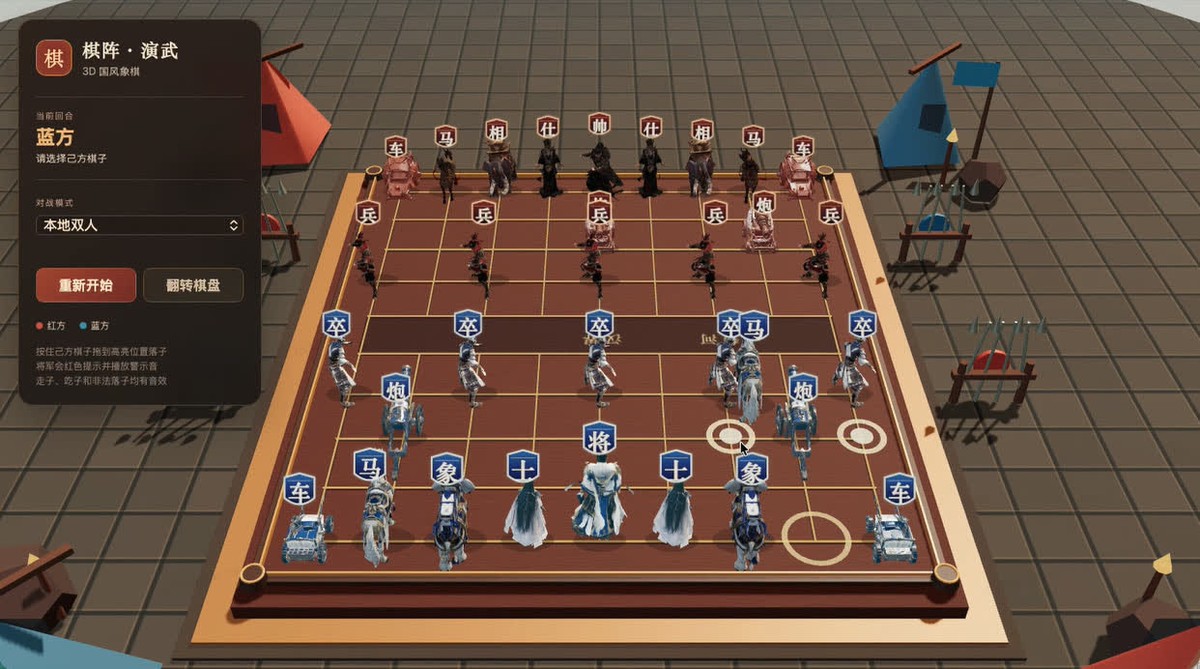
官方展示的能力案例里,有两类特别值得展开。一类是真实软件工程:Step 5 不止会写前端代码,还能直接参与视觉内容的生成与迭代,比如完成网页界面和数据可视化,调用 Blender 创建并反复调整 3D 资产,再把资产接进基于 Three.js 的交互式 Web 应用和游戏。官方自建的 StepCodeBench 覆盖 553 个独立代码仓库、9 类任务、20 个应用领域和 33 种编程语言,在内部和外部专家参与的评测中,约 70% 的评测者认为它可以自主完成中高复杂度的编程任务。
另一类是长程任务执行。一个直观的例子:官方给 Step 5 一张 H100、24 小时时间,让它从零优化一个 MLA GPU Kernel。模型自行实现、运行、根据吞吐结果继续修改,性能不升反降的版本直接放弃,最终在约 22 小时后做到前向加反向合计 508 TFLOPS,是对比中的最高结果。另一个实验里,它通过自动化后训练把一个 Qwen3-30B-A3B 基础模型的 AIME24 准确率从 53.3% 提到 60%,与 Claude Opus 5 持平,消耗的标注 Token 还更少。
长任务真正难的不只是跑得久,而是模型能不能一直记住前面的结果、理解新反馈、计划走不通时重新调整。1M Token 的上下文窗口,配合持续数百小时级的任务执行,正是冲着「上下文漂移」这个痛点去的。如果你试过大仓库级代码重构或者横跨几百份文档的深度研究,就能体会这种能力值多少钱。
国产高性价比路线:与 Qwen 3.8 打配合
把视角拉高一点,Step 5 Preview 的发布策略其实是国产开源路线的延续。就在不久前,阿里巴巴开源了 2.4 万亿参数、95B 激活的 Qwen 3.8,本站也写过它的开源解读;加上此前的 GLM、Kimi、DeepSeek,国产第一梯队几乎全部押注「超大稀疏 MoE + 开放权重」这条路。逻辑很一致:用 MoE 把旗舰能力做上去,再用开源把生态和开发者心智占住,商业 API 与开源权重双线收租。
Step 5 的差异化在于把「性价比」明牌打在了明面上:不宣称是最强模型,而是宣称在给定价格下你能买到的最好模型。Artificial Analysis 那张「帕累托前沿」图就是这个意思——智能与成本两条边界同时往前推。对跑 Agent 工作流的团队来说,单任务成本直接决定能不能规模化:同样预算下,成本只有 1/2.8 意味着能多跑近三倍的任务量,这在批量评测、数据标注、代码生成这类高吞吐场景里是实打实的竞争力。
国外同行也在同一个方向上卷:Mistral 刚发布了万亿参数的开源权重模型 Mistral Large 4,美国的 Reflection AI 拿出 501B 开源权重的 Beam。超大稀疏模型、小激活参数、按成本论英雄,已经是这一轮开源竞赛的公认打法,而中国实验室在这条赛道上明显跑在前面。
10 月 15 日开源:开发者怎么用好这波
落到实操层面。现在想尝鲜,可以直接在阶跃星辰的产品端和 API 里调用 step-5-preview,也可以走 OpenRouter 接入——进了聚合目录意味着发现和比价都方便,但各渠道的定价、限流、视觉与工具调用支持未必一致,接入前还是以你实际看到的模型页为准。
如果你在犹豫值不值得等开源:Step 的 Flash 小模型线此前以 Apache 2.0 协议开源,市场对 Step 5 的协议也抱有同样期待,但截至发稿官方还没公布模型卡和许可证,这点留个心眼。社区早期反馈里有人提到输出偏啰嗦,27B 的激活量也比一些「轻量版」旗舰更重,本地部署门槛不低——没几张卡的话,API 仍是更现实的选择。
对普通用户来说,最实在的建议是:拿自己手头的真实任务去测。把同一段提示词分别喂给 Step 5 Preview 和你现在用的模型,比一比结果质量和实际扣费,比看任何跑分都靠谱。10 月 15 日权重一放,第三方评测会很快跟上,到时候再决定要不要把它纳入生产环境也不迟。
相关阅读:
