开源大模型阵营又迎来一个重量级节点:阿里 Qwen 团队在魔搭 ModelScope 社区正式开放 Qwen3.8-2.4T-A95B 的模型权重,总参数规模达到 2.4 万亿,每个 Token 仅激活约 95B。这是 Qwen-Max 级别的旗舰底座第一次对外放开权重——以往开放的多是中小尺寸型号,云端旗舰长期只提供 API 调用。到了 10 月上旬,这批权重仍是国际科技媒体简报里的常客,被反复拿来与 Mistral Large 4 等万亿级开放权重模型并列讨论。对开发者来说,这不只是「又多了一个模型」:顶级闭源底座第一次变成可以下载、微调、私有化部署的资产,门槛和机会都值得掰开算一算。
2.4 万亿参数、原生 262K 上下文:Max 级底座首次开源
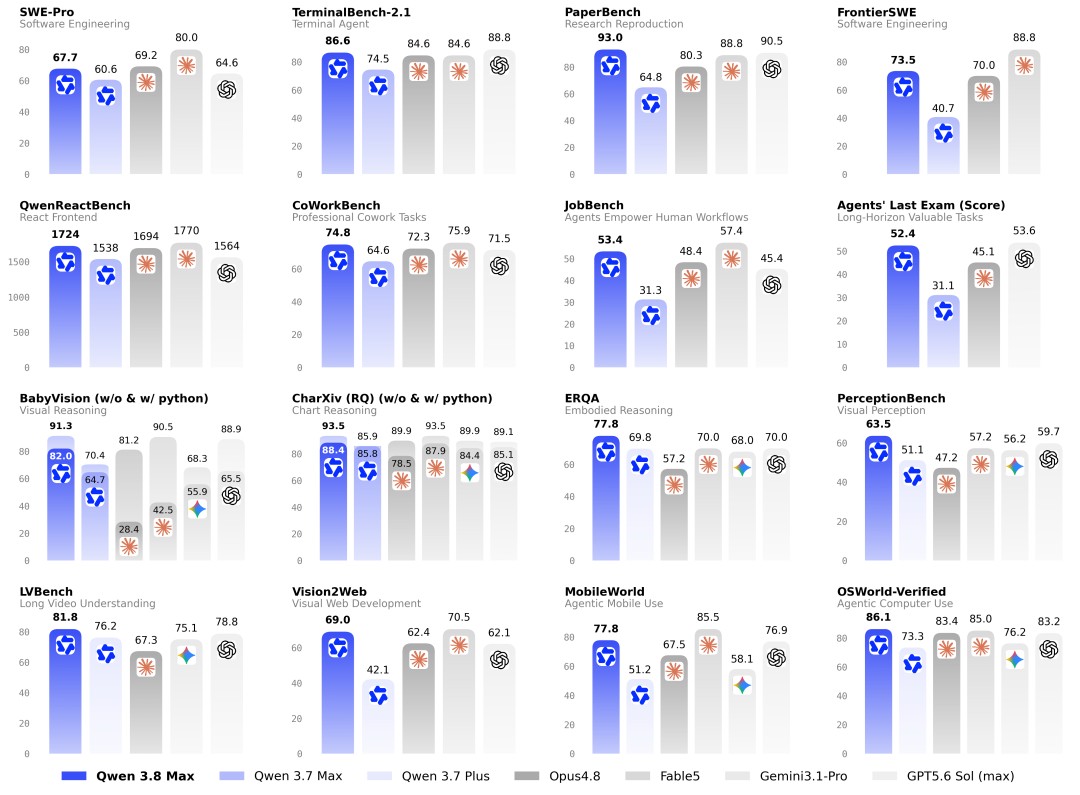
先看硬规格。Qwen3.8-2.4T-A95B 是一个因果语言模型,总参数 2.4T,每个 Token 激活 95B,延续 Qwen3.5 的混合架构,重点提升编程、办公、科研和长周期 Agent 任务的端到端完成能力。上下文方面,原生支持 262,144 Token,并可扩展至约 1,010,000 Token,模型还做了多步 MTP(Multi-Token Prediction)训练,配合支持该机制的推理引擎可以一次预测多个后续 Token,把长文本生成的吞吐再抬一截。
能力层面,官方评测覆盖编程 Agent、通用 Agent、专业工作和长上下文几个方向,与 Opus 4.8、Fable 5、GPT 5.6 Sol 等第一梯队模型对比,各项成绩互有高低。从官方公布的基准图表看,PaperBench 拿到 93.0、Terminal-Bench 2.1 为 86.6、FrontierSWE 为 73.5、CoWorkBench 为 74.8,在所列模型的编程与通用 Agent 任务里排在靠前位置。云端版 Qwen3.8-Max 正是基于这批开放权重构建,额外加入视觉输入、内置工具等生产环境能力——换句话说,你下载到的和阿里云端跑的是同一个底座,差异主要在生产化功能上。
需要留意的是,开源版和云端版并不是完全等价的产品面:据模型卡说明,开放权重版目前仅支持文本输入,且必须开启 Thinking 模式,推理强度可调(xhigh 为默认,另有 medium、low 两档);云端版则没有这些限制,还默认提供约 1M 上下文。
512 个专家只用 10 个:稀疏 MoE 这笔账怎么算
2.4 万亿参数听起来吓人,真正决定推理成本的是「激活多少」。Qwen3.8 采用稀疏 MoE 架构,据模型卡披露,每个 MoE 层包含 512 个专家,每个 Token 只选择 10 个路由专家,并同时激活 1 个共享专家。也就是说,处理任何一个 Token 时,真正参与计算的组织度不到专家总数的 2.2%,这才能把单 Token 激活量压到 95B——大约相当于一个中大型稠密模型的算力开销,却背后站着一个万亿级知识容量的「专家池」。
这笔账对部署者的意义很直接:显存里要装下全部 2.4T 参数,但单步计算的 FLOPs、KV 缓存增速和时延只按 95B 激活量走。相比同规模的稠密模型,稀疏 MoE 把「容量」和「算力」解耦了——容量换质量,稀疏换速度。共享专家的设置则负责承接跨任务的通用计算,避免路由专家重复学习共性知识。再加上 MTP 多令牌预测,官方称推理效率相比上一代有明显提升。这也是为什么各家旗舰不约而同都走向了 MoE:在万亿参数时代,不走稀疏路线,推理成本根本撑不起对外开放。
这里展开说说共享专家的用意。路由专家负责「分工」,每个 Token 按需挑人;共享专家则常驻计算图里,专门承接所有任务都用得上的通用能力,比如基础语法、常见推理模式。这样路由专家就能把容量全部投入更专精的领域,避免重复劳动。路由策略本身也是训练出来的——模型要学会把 Token 准确派给最合适的专家组合,路由错了,再多的专家也白搭。这也是各家 MoE 模型的核心技术差异之一。
万亿开源旗舰「三国杀」:Qwen、Mistral 与 DeepSeek 的路线分野
把时间线拉长看,今年开源阵营的旗舰竞争已经卷到了万亿级。Mistral 在 10 月上旬发布了 trillion 参数的开放权重模型 Mistral Large 4,主打网络安全与编程方向,被欧洲媒体视为「跟上中国竞争者」的关键一步;DeepSeek 等中国团队此前也已多次开放 MoE 架构的旗舰权重,以低成本推理著称。Qwen3.8 的加入,让「万亿级、可下载、旗舰底座」这个俱乐部一口气有了三家代表性玩家,而且三家路线差异相当鲜明。
Mistral Large 4 强调安全与代码场景的针对性优化,欧洲身份让它在数据合规敏感的行业里有独特位置;DeepSeek 一贯把性价比和推理效率放在第一位,深受预算有限的开发者欢迎;Qwen3.8 则走「云端旗舰同底座」路线,把阿里云上经过生产环境验证的能力直接下放,再加上中文语料上的长期积累,中文写作、中文办公与国内业务场景的适配是它的天然强项。对使用者来说这不是零和游戏——同一个问题丢给三家模型,答案风格和擅长领域各有侧重,选型空间反而更大了。
值得一提的还有一个细节:据国际媒体 10 月 9 日的周报梳理,Qwen 3.8 的开放仍被列为当周 AI 行业标志性事件之一,与 GPT-6 全量推送、Mistral Large 4 发布并列。发布数月后还能进入国际一线简报的讨论序列,说明万亿级旗舰开源这件事本身的行业分量。
想自己部署?先掂量显存、量化和许可证三道门槛
权重开放不等于人人能跑。第一道门槛是体积:据媒体报道,即便按约 4-bit 量化,Qwen3.8 的权重体量仍在 1.2TB 量级,几乎只有数据中心级的服务器才装得下,笔记本和单卡工作站可以直接死心。实际部署要按官方推荐走 vLLM、SGLang 这类支持 MoE 与 MTP 机制的推理引擎,多机多卡是常态。对绝大多数个人开发者,现实的选择是通过 API 或 Qwen Studio 体验,把私有化部署留给有集群资源的企业团队。
第二道门槛是许可证。这次阿里没有沿用以往常用的 Apache 2.0,而是改用了 Qwen3.8 专用条款:普通用户可以自由下载、修改、部署,做二次开发没问题,但大规模商业使用需要另行取得授权。企业引入前务必把条款读一遍,别按开源惯性直接上生产。第三道门槛是产品形态:开源版强制 Thinking、仅支持文本输入,对时延和成本敏感的批量任务来说,这是架构层面的硬约束,选型时要提前评估。官方还预告了尺寸更友好的 Qwen3.8-27B,对资源有限的团队来说,那个版本可能才是真正够得着的选项。
话又说回来,门槛高不代表开放没意义。对中小团队和政企客户而言,顶尖底座从「只能云端调用」变成「可以拿来做私有化二次开发」,数据不出域、行为可定制、供应链不受制于单一 API——这些价值足以让有能力的玩家认真投入。万亿旗舰权重从闭源锁死走向开放,这个方向本身,比任何一项跑分都重要。
总结
Qwen3.8-2.4T-A95B 的开放,把「旗舰级开源模型」的定义线直接拉到了 2.4 万亿参数:规格上是 2.4T 总参、95B 激活的稀疏 MoE,原生 262K 上下文可扩展到百万级;能力上在编程与 Agent 任务里跻身第一梯队;生态上与 Mistral Large 4、DeepSeek 形成三分天下的开源旗舰格局。个人开发者短期内更适合通过云端入口使用,有集群资源的企业则第一次拿到了可以私有化的 Max 级底座。如果你正在做国产大模型的私有化选型,这批权重值得列入首批评估名单——记得先核对许可证条款和硬件预算,再决定是全量部署还是等 27B 版本。
