发布详情
10 月 5 日,英伟达投资的美国初创公司 Reflection AI 在官方博客宣布 Beam,这是该公司的首个开源权重模型。Beam 是一个稀疏混合专家(MoE)模型,总参数 501B,每 token 仅激活 23B,官方将其定位为面向编程、推理与智能体工作负载的「主力工作模型」,声称要推进西方阵营的开源权重前沿。目前 Beam 正处于最终红队评测与评估阶段,开发者可以在官方候补名单中申请早期访问。
Reflection AI 的方向早有铺垫:据 Semafor 此前报道,这家公司明确表示要在开源权重市场与 DeepSeek、Qwen 等中国实验室正面竞争。TechCrunch 与 Business Insider 等媒体的早期报道也将 Beam 的发布解读为西方开源阵营对快速进步的中国开源模型的回应。与前几个发布即完全开源的模型不同,Beam 这次先公布能力与工程细节,权重要等红队评测结束后再开放。
模型规格与训练
Beam 的能力来自预训练与强化学习两方面的投入。预训练阶段,模型在 23.8 万亿经过筛选的高质量 token 上训练,数据来自网络、公开来源与专有授权数据集,官方称其基座模型与同规模开源基座对比时持平或更好。预训练集群由 6144 块 GB300 NVL72 组成,全程不到四周完成,运行后期的 goodput(有效训练时间占比)达到 92.3%。数据管线上,约 95% 的原始互联网 token 在解析、去重与筛选中被淘汰,官方称传统开源数据框架的过滤方式会漏掉大约 1.8 万亿条他们保留的高质量 token,其中包括 87% 的精选网页代码 token。中训练阶段还把模型的有效上下文扩展到 1M token,为后续长链路强化学习打底。
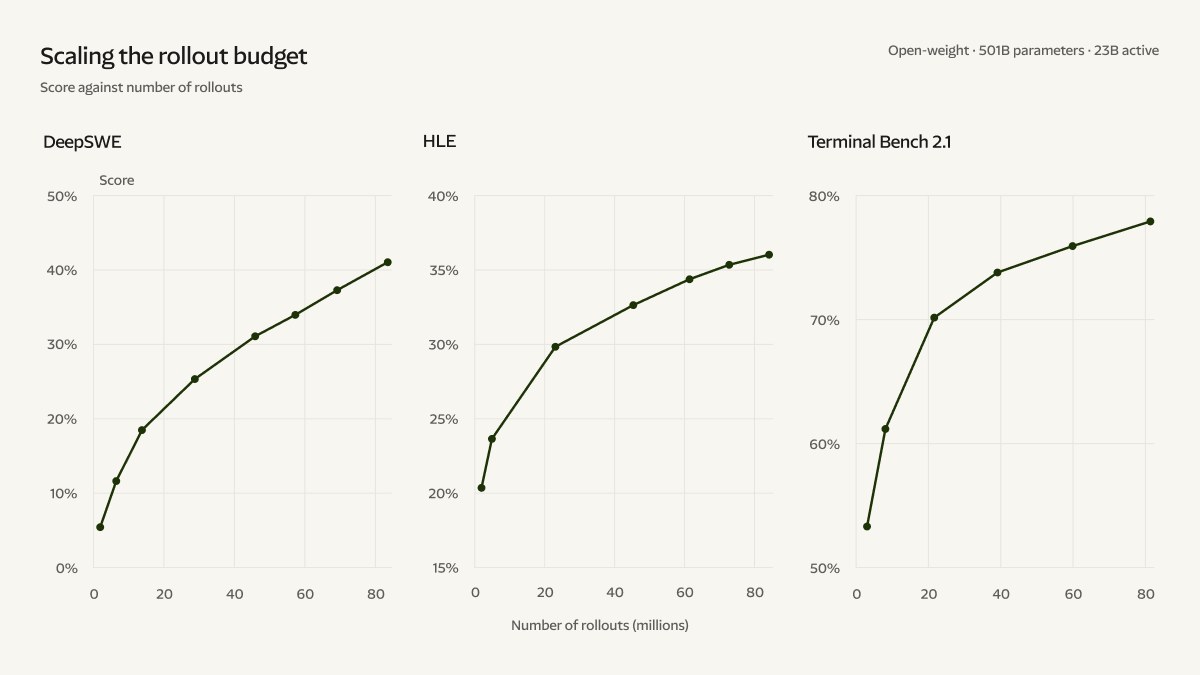
强化学习是这次发布的核心叙事。官方在 10500 块 GB300 GPU 上进行了为期四周的高强度 RL 运行,生成超过 1 亿次 rollout,最大上下文长度 256K;训练与判分环节消耗约 13 亿次沙箱,峰值支持 17 万并发沙箱;环境池规模约 100 万个,覆盖软件工程、终端操作、竞赛编程、STEM、网页搜索与工具使用。整个运行期间平均维持 11 万并发 rollout,新权重下发到推理集群的中位耗时约 12 秒,期间 71 次推理故障都在不中断训练的情况下恢复。官方称这是已知实验室中规模最大的 RL 运行之一,并给出对照:Inkling 的训练用了 3000 万次 rollout,MiMo 用了 75.3 万次。为了在超大异步策略梯度下保持稳定,团队开发了新算法处理策略陈旧问题——即使样本落后当前策略一整天、滞后 107 个权重版本,训练数值依然稳定。
基准成绩
官方博客给出了一张覆盖编程、智能体、推理与 STEM 的基准表,Beam 的关键成绩如下:
- SWEBench Verified 80.9,高于 Inkling 的 77.6 与 Nemotron 3 Ultra 的 70.7;
- Terminal Bench v2.1 80.1,接近 GLM 5.2 的 81.0,落后 Qwen 3.8-Max 的 86.6 与 Kimi K3 的 88.3;
- SWE Bench Pro v1 65.5,v2-Hard 拿到 77.2;
- AIME 2026 97.8,GLM 5.2 为 99.2;
- GPQA Diamond 90.5,GLM 5.2 为 91.2,Kimi K3 为 93.5;
- HLE 无工具设定下 36.2,Kimi K3 为 46.9;
- MCP Atlas 78.7,略高于 GLM 5.2 的 77.8。
整体来看,Beam 在编程与智能体任务上与总参数比自己更大的开源模型掰手腕,推理类基准进入开源权重第一梯队,但还没有站上绝对能力的天花板。官方表格中,DeepSeek V4.1 Flash 在部分智能体编码项目上仍然领先。
与 GLM 5.2 对比与定位
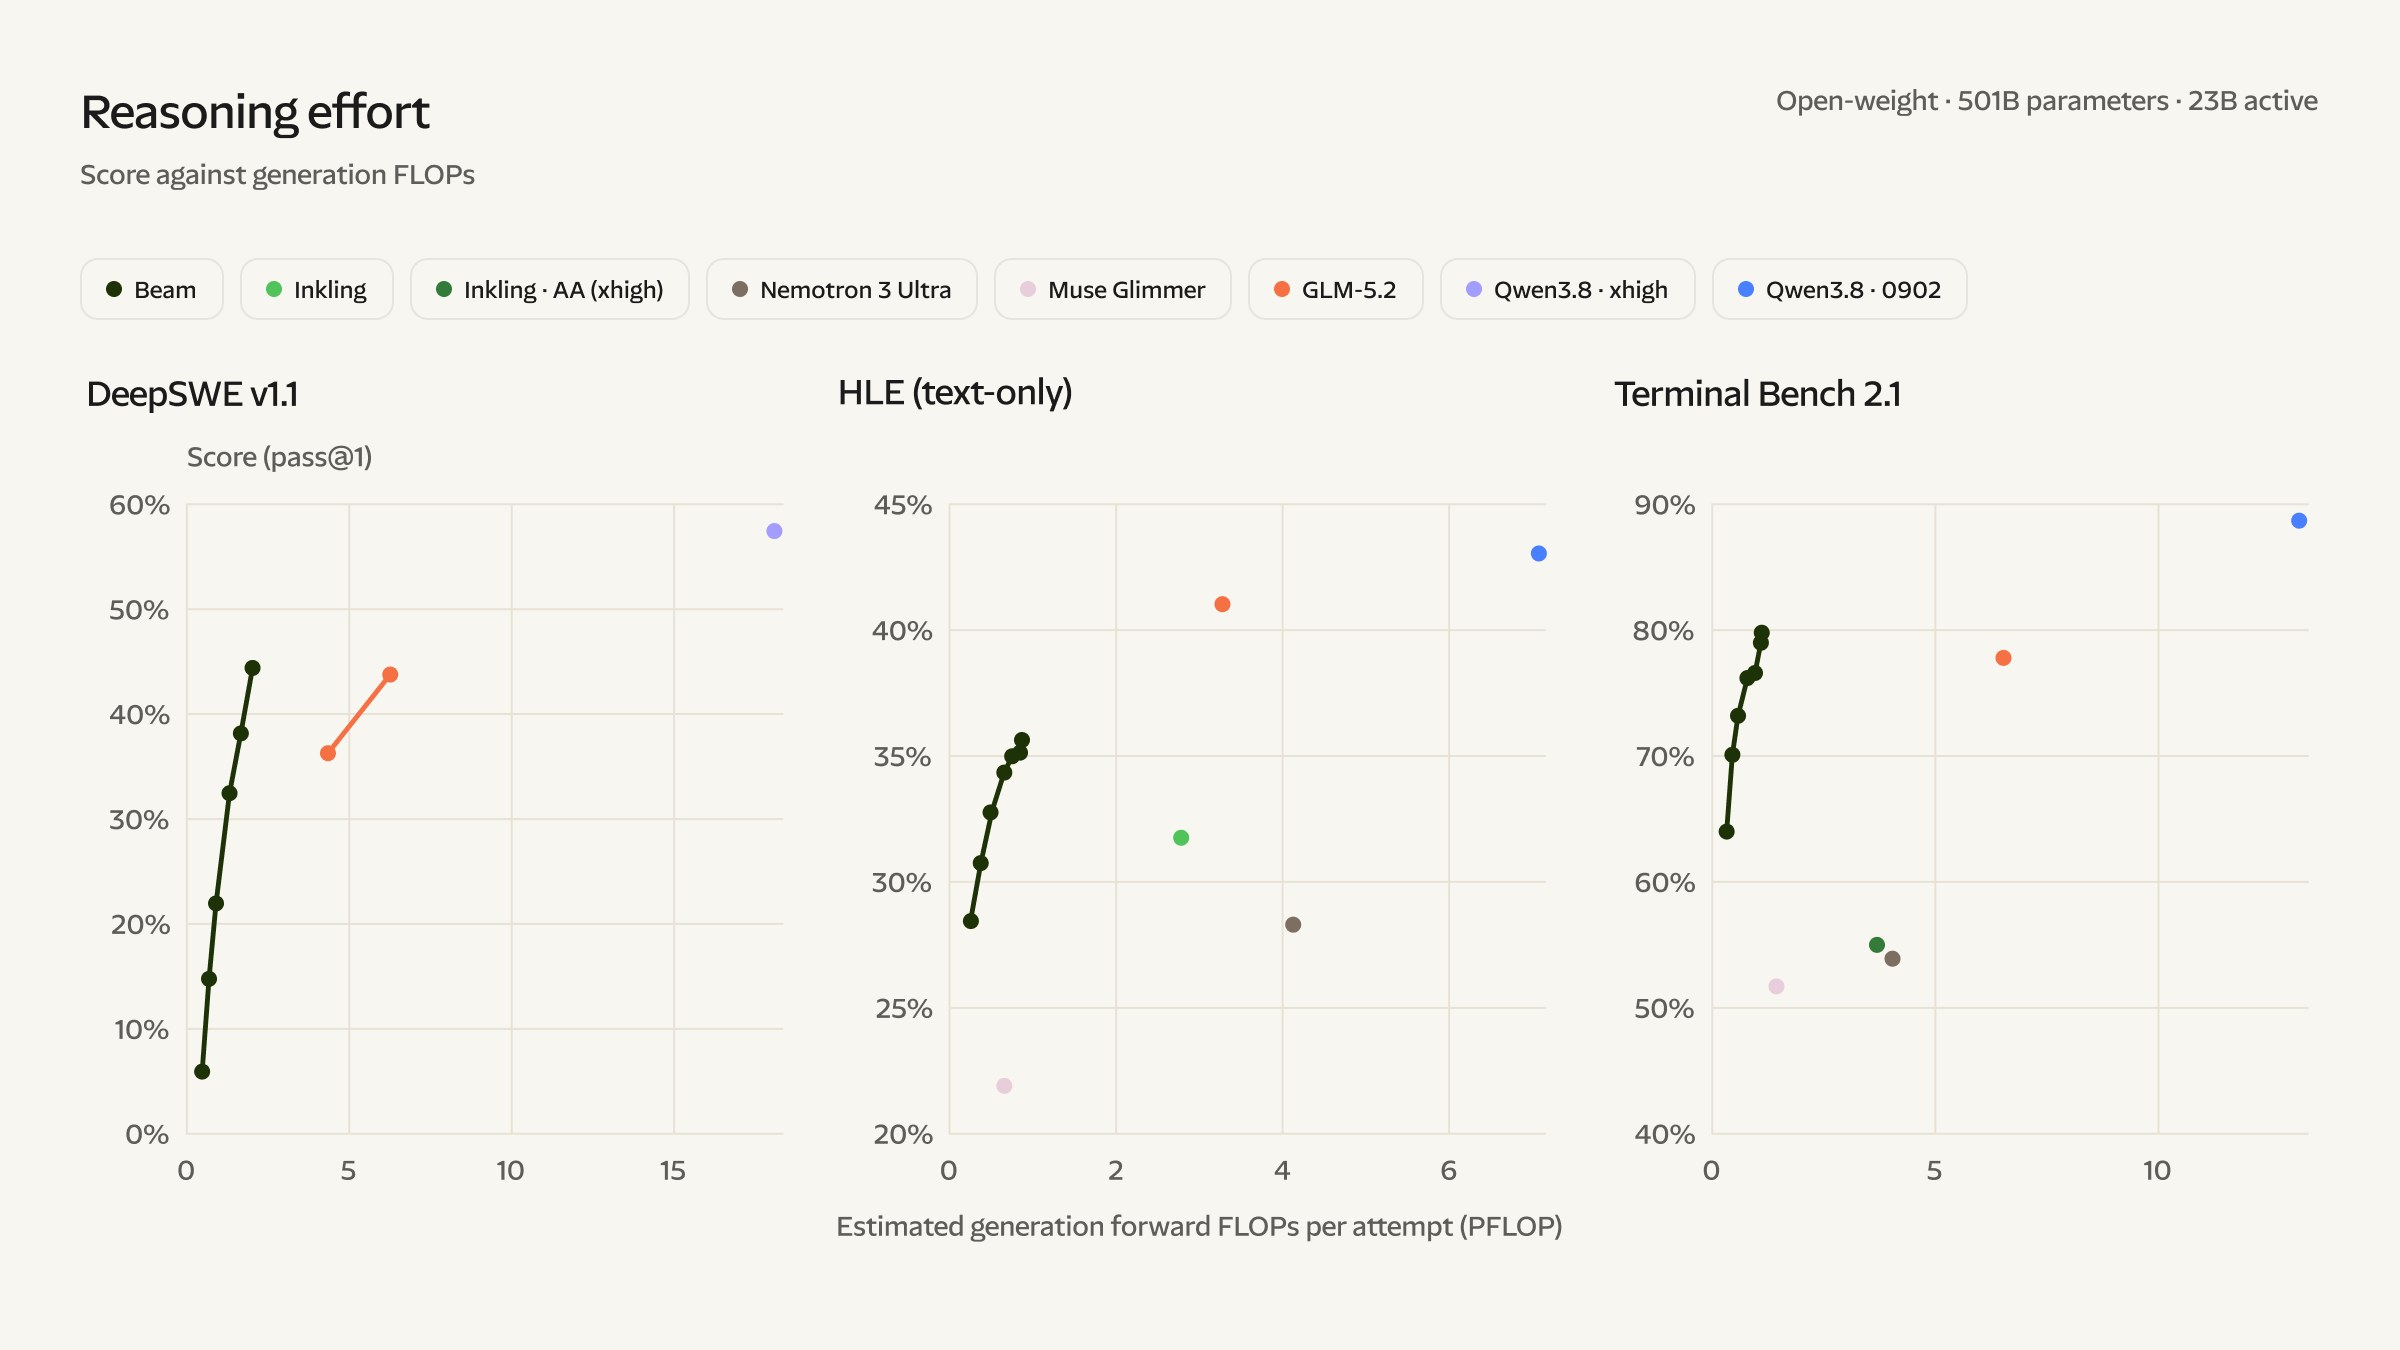
这次发布最值得注意的口径是效率。官方称,Beam 在高级推理基准上取得与 GLM 5.2 相当的分数,同时推理算力节省 3-4 倍;与 Qwen 3.8-Max 这类 2T+ 参数家族的模型相比,效率优势更加明显,因为后者每 token 需要的推理算力显著更多。官方同时明确承认:Kimi K3 等前沿开源模型在原始能力上仍然领先,Beam 的差异化优势是推理时的效率,而不是绝对性能。换句话说,Beam 的目标是「每个 token 产出更多智能」,用更低的成本扛起企业级的编程与智能体负载。
效率来自训练方法的配合。团队在 RL 阶段引入可控长度惩罚,奖励成功的解法同时抑制不必要的 token:训练早期模型学会用更短的推理解决问题,后期随着智能体能力增强,回答长度回升,但新增 token 换来了更高性能。用户可以通过推理力度(reasoning effort)参数在速度与深度之间权衡——低档位偏好短回答,高档位允许更长的推理链来攻克难任务。官方还基于 Artificial Analysis 与 DataCurve 的数据,用 FLOPS 与生成 token 数两种口径估算了各模型的生成算力,结论都是 Beam 处于效率前沿。
架构与稳定性细节
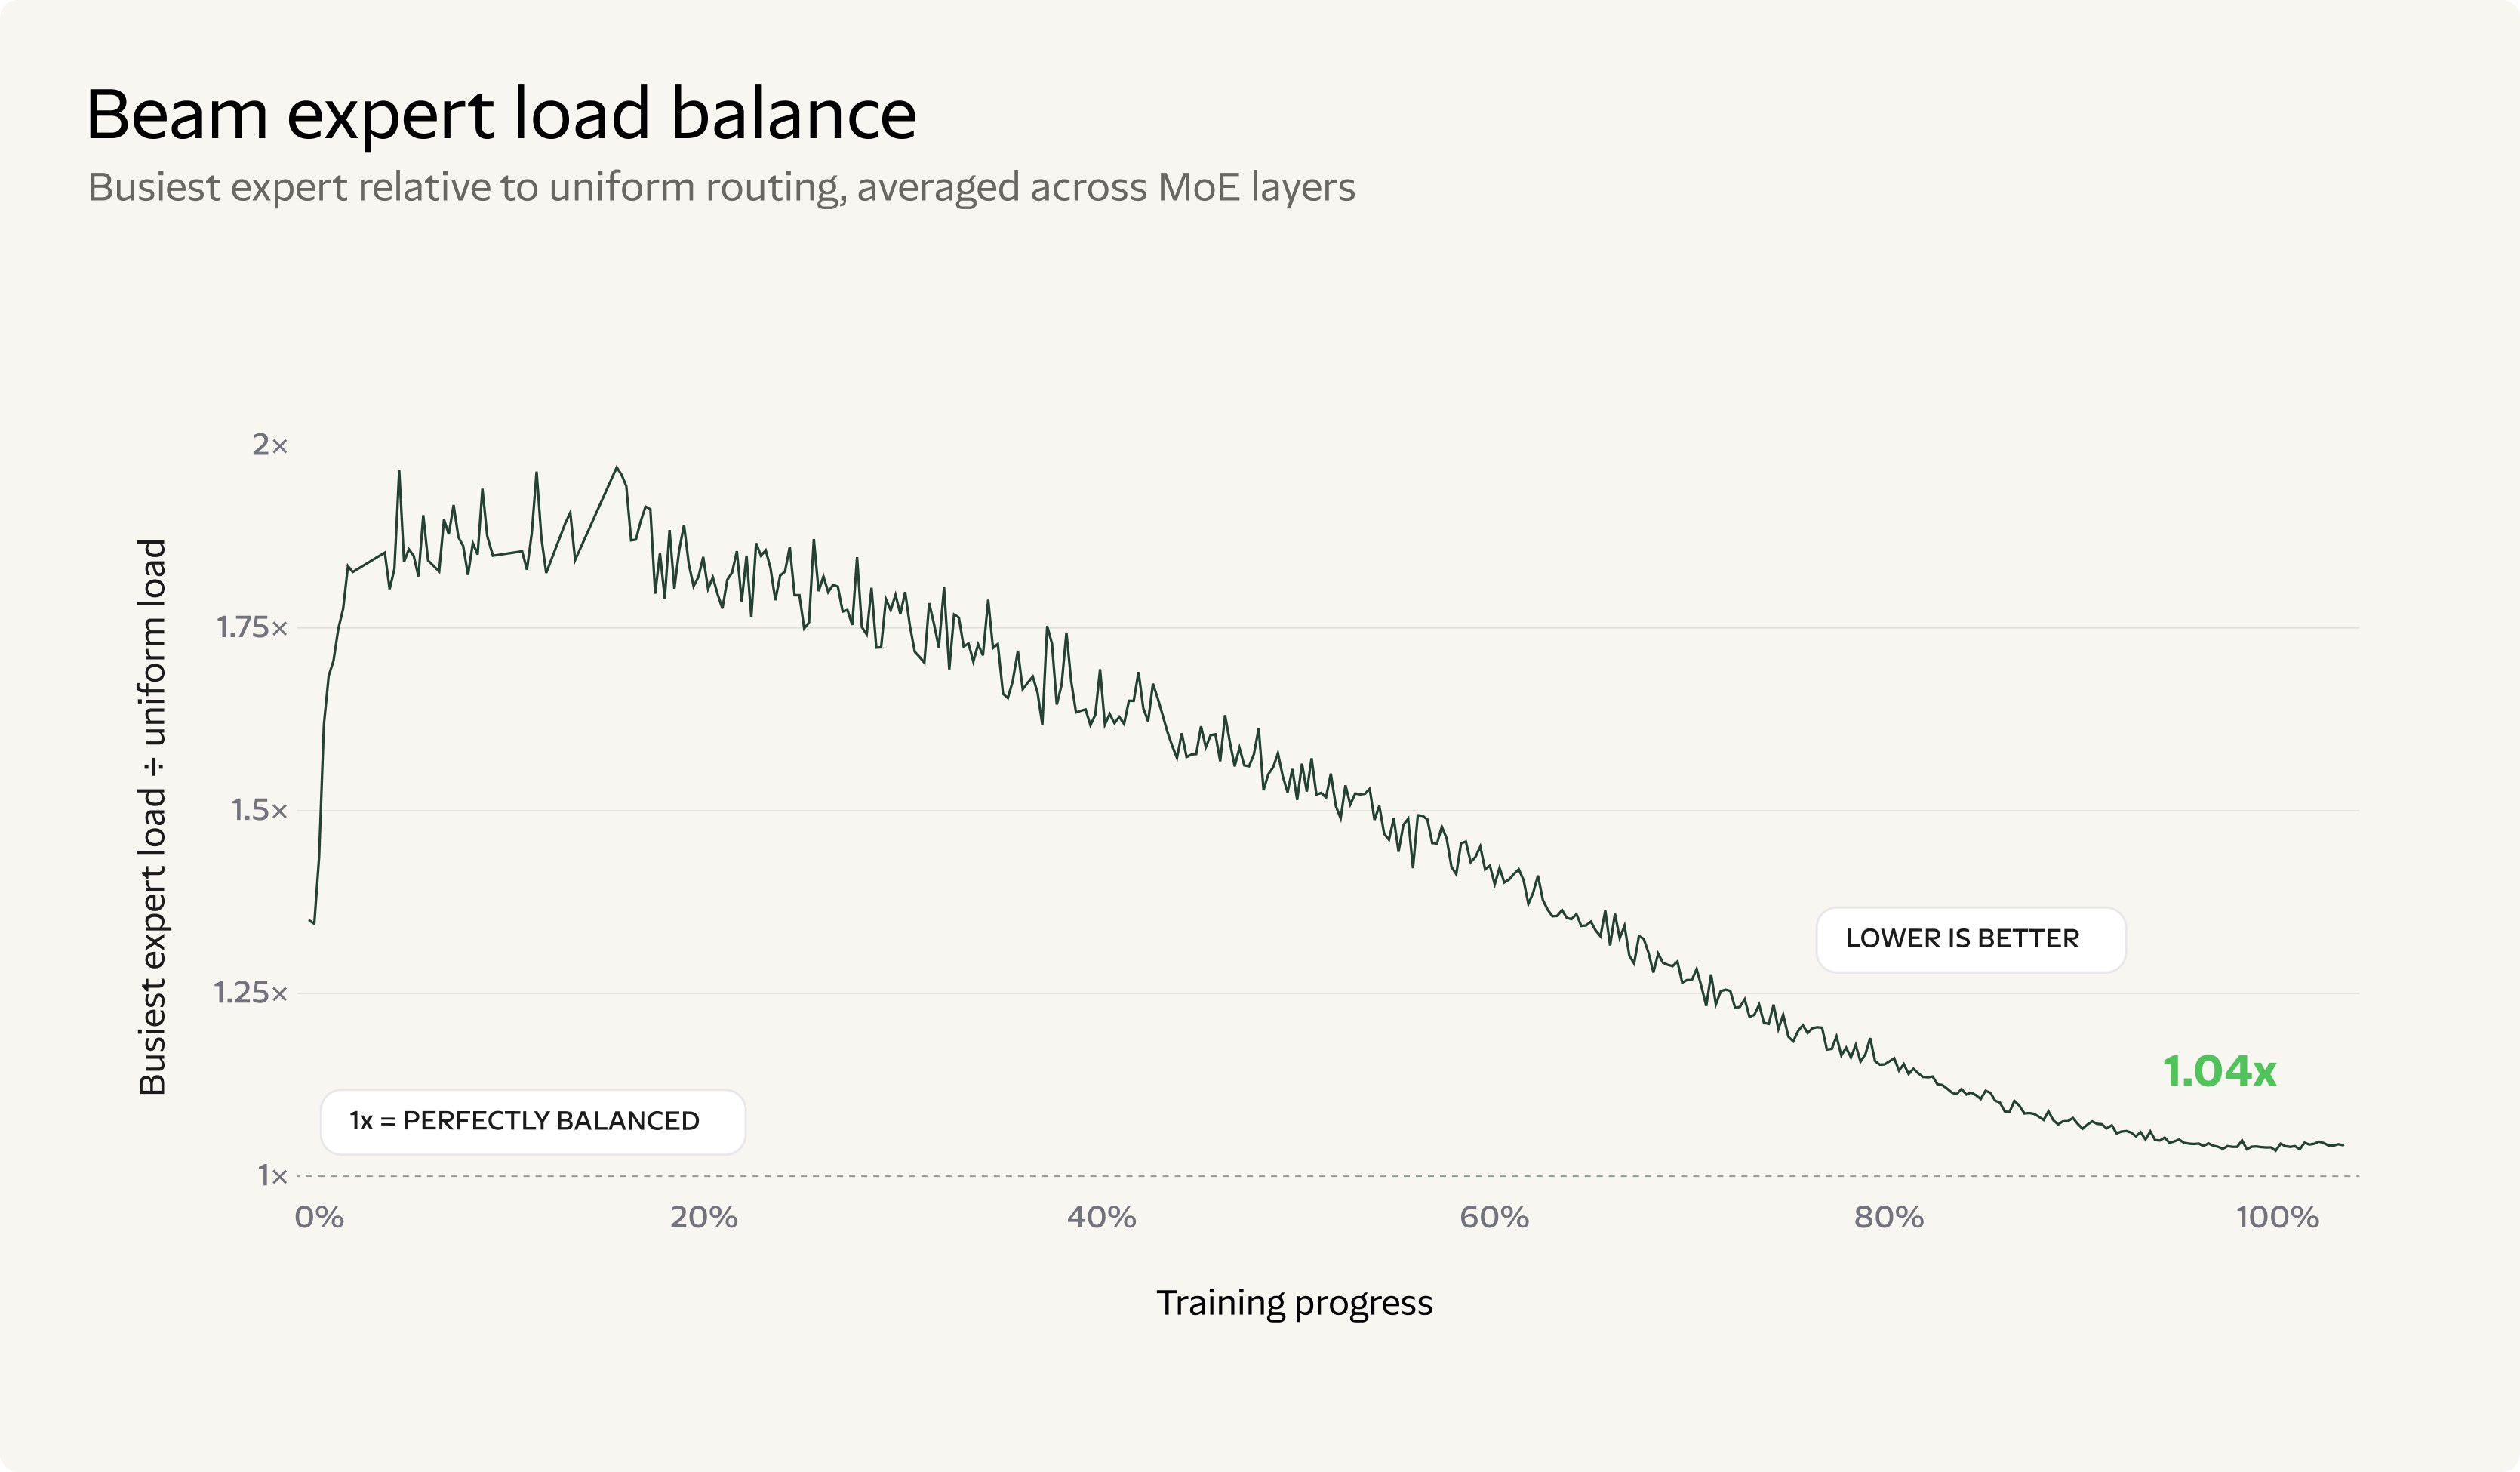
架构上,Beam 共 52 层,采用交错的局部与全局注意力、细粒度路由专家和多种负载均衡手段。官方在 auxiliary-loss-free 负载均衡的基础上引入专家偏置更新的余弦衰减,减少训练后期的路由扰动;序列级均衡则保证分布外数据上的专家利用依然均匀。最终预训练基座的专家利用接近完美均匀——按 MoE 层平均,最忙专家的负载只有 1.04 倍。残差流方面,团队用随深度缩放的方案对抗激活增长,配合 SandwichNorm、逐元素注意力门控与 FP32 残差累加,让 52 层的信号传播全程稳定,预训练损失曲线没有出现不可恢复的尖峰。
开源节奏与许可
许可与时间表已经明确:Beam 将在本月内以 Apache 2.0 许可发布权重,同时附上技术报告、模型卡与运行、评估、微调所需的全套开发者工件。Reflection 还计划与一批发行伙伴合作,并接入主流开源库与工具链,让开发者能在现有开源工作流里直接使用 Beam。安全方面,团队用多教师在线蒸馏(MOPD)把大规模 RL 教师与专职安全教师的能力合并进同一个模型,安全原则分为不可违反的规则、须持续满足的质量与默认交互风格三层;训练数据按对抗方式迭代生成,用成功攻击反哺下一轮训练。官方承诺将开源内部使用的安全评测,为开源生态提供可检验的标准。
Beam 是官方规划的系列中的第一个模型,官方透露下一代已经在训练中,目标是每次发布都把开源前沿往智能前沿推近一步。
开源阵营格局
把 Beam 放进当前的开源竞争格局里看,发布的时间点很微妙。中国阵营这边,GLM 5.2、Qwen 3.8-Max、Kimi K3 已经把开源权重的性能天花板抬得很高,Kimi K3 近期还登上了 Amazon Bedrock 走进云市场(参见本站此前报道:月之暗面把 Kimi K3 摆上了 Amazon Bedrock);西方阵营里,Mistral 也刚公布万亿参数的 Large 4 并计划月底开源权重(参见:Mistral Large 4 发布,月底还要把权重开源)。
Beam 的入场方式因此显得务实:不与 Kimi K3 拼原始能力,而是以 23B 激活的稀疏结构和可控推理力度切入企业最敏感的成本问题。对自托管团队来说,Apache 2.0 意味着没有定制许可的商业限制,23B 的激活量也让推理可以落在相对亲民的硬件上,数据全程不出域。开源权重市场的效率之战才刚刚开始,Beam 是否真能以三到四倍的算力优势站稳,还要等权重开放后第三方实测来验证。
