Breeze TTS 2 这个名字最近在百度搜索里冲到了第一位,说明中文圈对它的关注度已经起来了。本站此前发过一篇面向使用者的入门解析,讲了三种造声方式、内联事件标记和本地部署门槛。这一篇换一个视角:把模型拆开,看它的架构选择、语料策略和评测方法论,尽量以论文审读的口径核对每个数字的出处。
两阶段自回归:四个模块怎么分工
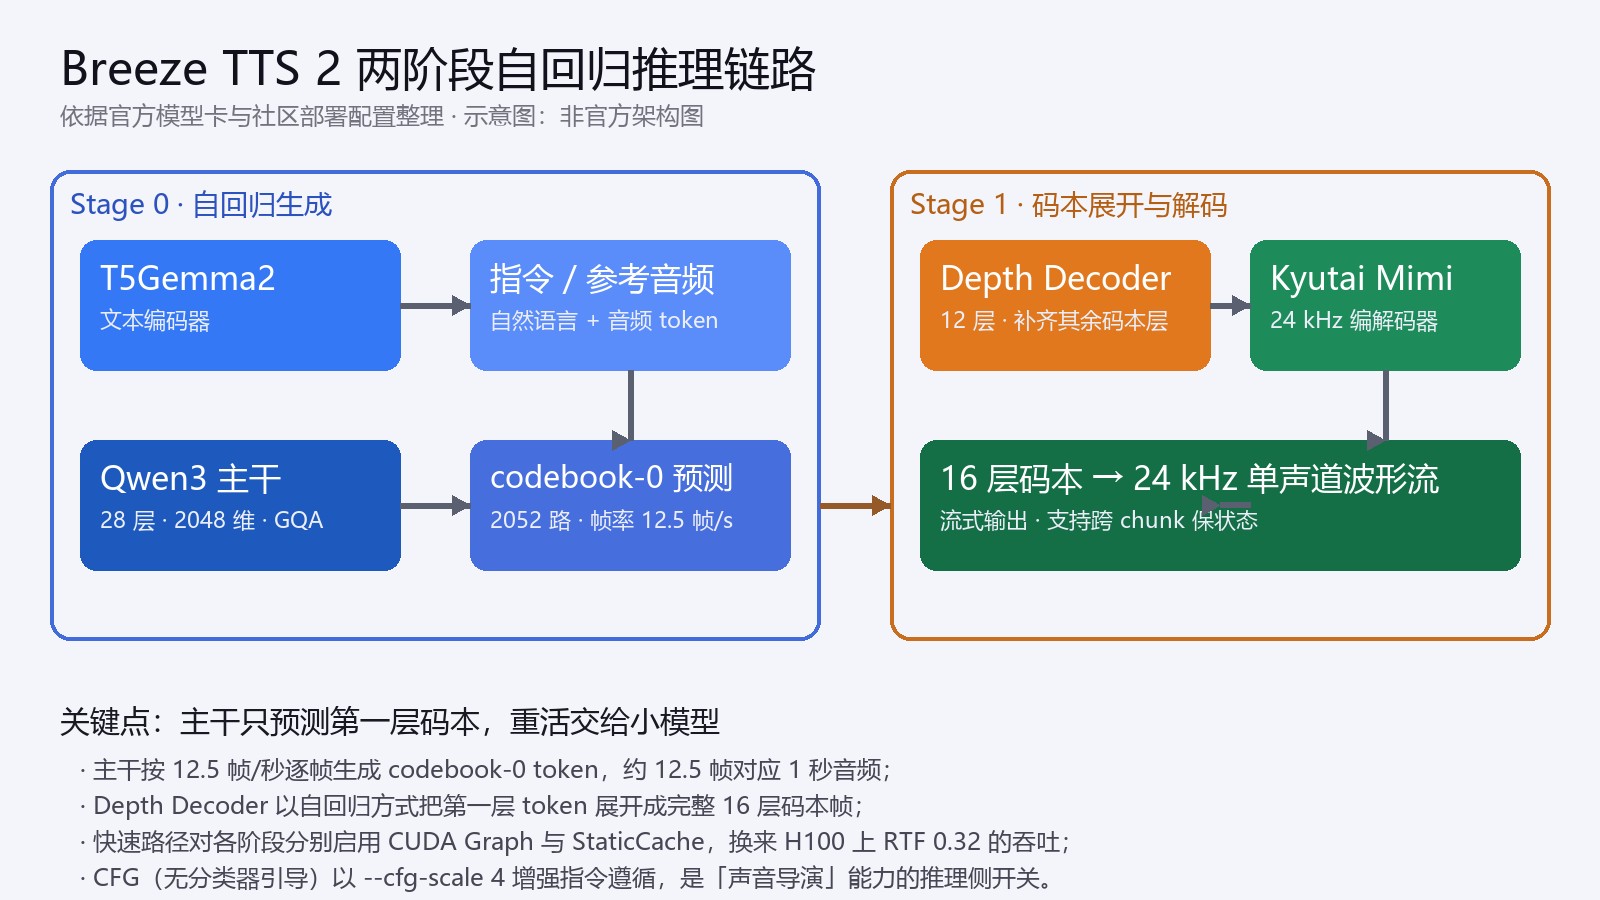
先看骨架。Breeze TTS 2 的总参数量约 3.48B,官方没有公布完整的分模块参数表,但推理代码和社区部署配置把结构暴露得很清楚:文本编码器用 T5Gemma2,主干是一个 Qwen3 架构的因果语言模型,规格接近 llama-1B——28 层、隐藏维 2048、16 个注意力头配 8 个 KV 头,标准的 GQA 分组查询注意力,RoPE 基频取一百万。音频侧的编解码器选了 Kyutai 的 Mimi,输出 24kHz 单声道,帧率 12.5 帧/秒。
真正值得琢磨的是它把生成过程切成两个阶段。Stage 0 里,Qwen3 主干以自回归方式逐帧预测码本的第 0 层 token,预测头有 2052 路,帧率 12.5 帧——也就是说一秒音频在主干眼里只有 12.5 个 token,这比直接对波形建模的方案轻了几个数量级。Stage 1 里,一个 12 层、规格约 llama-100M 的深度解码器把第 0 层 token 展开成完整的 16 层码本帧,最后由 Mimi 解码成波形。
这个「大模型只写主旋律、小模型补齐和声」的设计是近两年神经编解码 TTS 的主流演化方向。它的收益很直接:自回归的序列长度决定延迟下限,把最贵的计算压缩到单层码本上,流式场景的首帧延迟才有可能压进百毫秒量级;代价是两层之间如果协调得不好,会出现音质或韵律的断层。从评测数据看,这条链路的协调是合格的。
推理工程:40 毫秒从哪来
官方口径里最抓眼球的数字是模型侧首字节延迟低至 40ms。这个数字需要放在正确的坐标系里理解:它是 H100 上完整暖机后的快速路径成绩,属于实验室最优值。部署文档给出的实测分布要保守得多——TTFB 的 p50 是 119.4ms,TTFA 的 p50 是 133.6ms,p95 也只有 163.3ms。看 TTS 的延迟应该看 p95 而不是宣传值,163.3ms 意味着绝大多数请求都能稳定落在人类对话可接受的响应窗口内。
快速路径的工程手段并不神秘,但做得很细。推理代码把整条链路拆成文本编码、主干预填充、主干解码、深度解码器、编解码器五个阶段,每个阶段可以独立开关 CUDA Graph,主干解码用 StaticCache 缓存 KV,编解码器按单帧 chunk 做流式解码。显存代价是清晰的:eager 推理约 7.7GiB,12GB 卡就够;全开快速路径要 14.4GiB,官方建议 24GB 卡。RTF 0.32 意味着 H100 上每秒能生成约 3.1 倍时长的音频。
另一个容易被忽略的推理侧开关是 CFG——无分类器引导。官方建议把 cfg-scale 设为 4 来强化指令遵循,这个参数直接决定了「声音导演」能力的效果:模型在生成时会同时跑一条带指令、一条不带指令的路径,用两者的差值放大指令对韵律和情绪的调制幅度。CFG 开得越高,指令服从越强,但音质会轻微受损,这是一个典型的可控性与保真度的权衡旋钮。
语料哲学:不做朗读,做对话
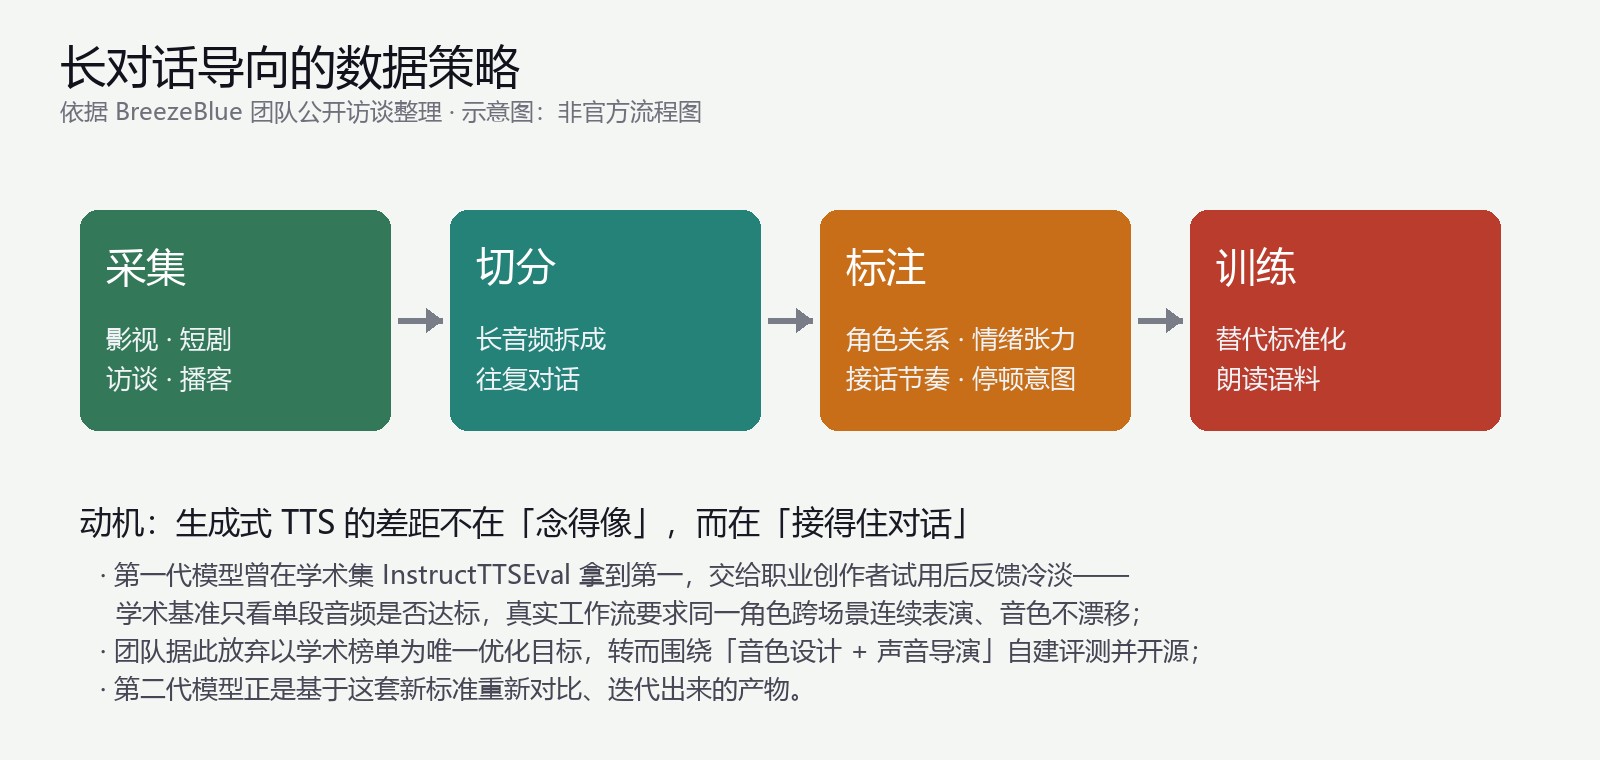
如果说架构是公共题,语料才是 BreezeBlue 的差异化下注。团队公开谈过他们的数据策略:主要训练材料不是录音棚里照稿朗读的标准语料,而是影视剧、短剧、访谈和播客里的真实长对话。这类语料自带情境——人会接话、打断、停顿、根据对方的情绪调整自己的表达方式,这些恰恰是朗读语料里不存在的信息。
处理流程也不轻松。长音频要先拆解成往复对话的结构,再逐段标注角色关系、情绪张力、接话节奏和停顿意图。这个标注粒度远超传统 TTS 数据集的「文本对音频」配对,本质上是把对话的行为层信息显式喂给模型。这解释了为什么这个模型的内联事件标记和自然语言指令遵循表现突出——它见过的数据里,声音从来不是孤立的朗读,而是互动的一部分。
评测换轨:从学术榜单到自建基准
方法论层面最有趣的一段故事发生在第一代模型身上。2025 年底,Breeze 一代曾在学术评测集 InstructTTSEval 上拿到第一,但把模型交给职业创作者试用后反馈冷淡。团队复盘的结论是:学术基准只判断孤立单段音频是否达标,而真实工作流要求同一个角色在连续场景里表演、过渡自然、音色不漂移——这是两个不同的问题。
于是团队做了一件在模型公司里不常见的事:放弃以学术榜单为唯一优化目标,围绕「音色设计」和「声音导演」两个环节自建评测体系,并且把测试用例、细分指标和自动化评测代码全部开源。用这套新标准重新对比迭代,才有了第二代模型。这套自建基准的成绩是:Voice Design 的 Role Fit 得分 78.02,领先第二名 MiMo-V2.5-TTS 的 72.78 约 5.24 分;Voice Direction 得分 4.25,比 MiMo 的 3.76 高 13%,同时保持 0.67 的音色相似度;Voice Diversity 达到 708,比最接近的竞品多 39%。
当然要指出:这两套基准是厂商自建的,虽然开源了评测代码、不是黑箱自测,但目前还没有看到大规模的第三方复现。读这些数字时应该把它们当作「厂商定义的游戏里谁赢」,而不是普适结论。
盲测分裂:赢在哪,输在哪
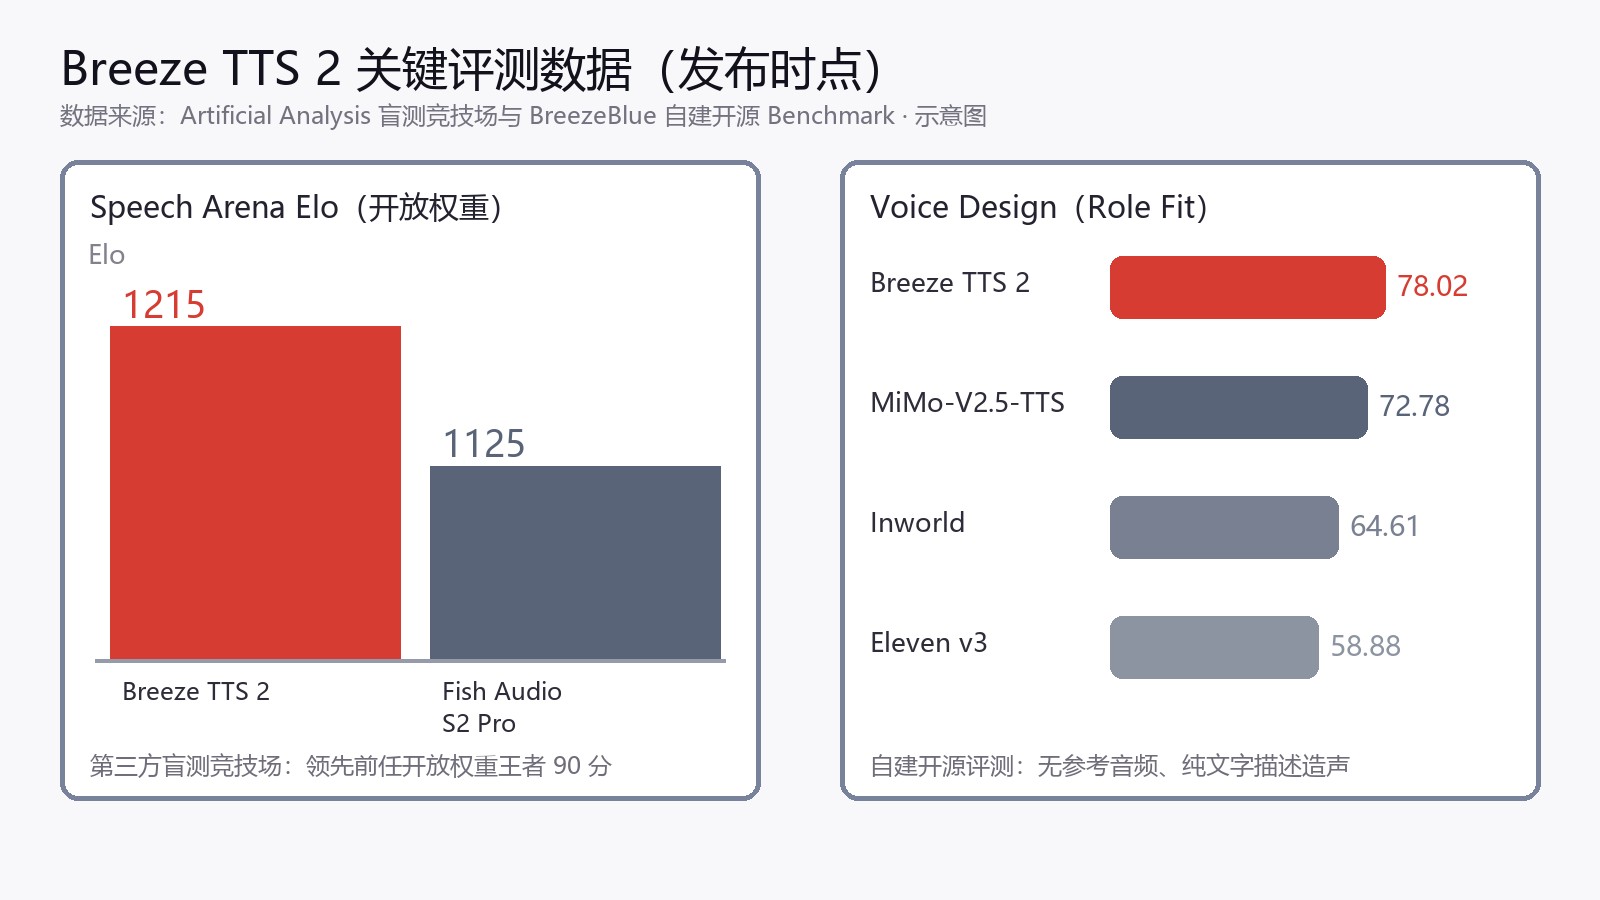
真正有第三方背书的数据来自 Artificial Analysis 的盲测竞技场。在 Provider Voices 赛道——各家模型用自己的原生声音参赛——Breeze TTS 2 拿到 1215 Elo,是开放权重模型里的第一名,领先前任王者 Fish Audio S2 Pro 的 1125 整整 90 分,在全站约 100 个模型里排第六。
但同一个平台还有一个 Controlled Voices 赛道:所有模型合成同一位参考语者。这里 Breeze TTS 2 只拿到 1002 Elo,与 Fish Audio S2 Pro 打平,还输给了 Mistral 的 Voxtral TTS 的 1010。这个分裂非常说明问题:它的优势不在「模仿某个特定的人」这类传统自然度维度,而在「为每个角色设计一个合理且不撞声的声音」这个产品化维度。这也反过来印证了它自建评测的定位——Role Fit 和 Voice Diversity 测的正是传统基准测不出来的东西。
代价同样明码标价。第三方整理的吞吐数据显示它只有 45 字符/秒,不到 Fish Audio S2 Pro 102 字符/秒的一半;托管 API 定价 34 美元/百万字符,是 Fish Audio 15 美元的两倍多,更远高于轻量开放权重方案 Kokoro 82M 的 0.65 美元。如果业务只是把文本转成朗读音频,这个模型在成本上是明显劣势;它的账只有在「每个角色一种声音、每次表演实时可控」的场景里才算得过来。
边界与代价
- 它只做单向语音生成。Artificial Analysis 还维护着一个全双工语音交互榜单 Speech Agent Arena,头名是 Gemini Live 和 GPT-Realtime 系列,BreezeBlue 的产品并不在列——能听、能说、能实时接话的交互智能是官方规划中的下一站,还没有交付。
- 开源权重面向中英双语,官方宣传口径里的 50 种语言覆盖指的是托管 API 服务,两套口径不要混淆。权重许可为研究与非商用专用,推理代码是 Apache 2.0,商用部署需要向母公司 RESONIA 另行取得授权。
- Voice Design 与 Voice Direction 两套基准虽已开源,但缺乏大规模第三方复现,成绩解释权实际仍在厂商手里。
- 吞吐量与价格对高吞吐朗读场景不友好,选型前先想清楚自己要的是「配音」还是「造声」。
结语:它把 TTS 的竞争换了个维度
回看 Breeze TTS 2 的三重设计——两阶段自回归架构压延迟、长对话语料养表演、自建评测定方向——它们其实是同一件事的三个切面:把语音合成从「念得像真人」重新定义为「演得像角色」。创收层面,团队刚拿过 600 万美元种子轮,规模不大,但方向卡在了语音智能体和多角色内容的交汇点上。
对研究者来说,它开源了权重、推理代码和评测基准,是当前研究指令控制型 TTS 最完整的开放样本之一;对开发者来说,选型前先跑一遍它的许可条款和显存账。想看上手体验和功能层面的介绍,可以回到本站的入门篇;同赛道的竞品动态可以看Fish Audio 开源 Drama 3那篇。
参考资料
本文事实与数字的核对来源:
