一个会「演戏」的开源语音模型
Fish Audio 在 2026 年 10 月 13 日丢出了 Drama 3。它不是一个普通的文字转语音模型,而是冲着「让机器读剧本」去的。35B 参数的 MoE 架构,每 token 只激活约 3B,开源权重直接挂上 Hugging Face(fishaudio/drama-3),代码在 fish-speech 仓库,还附了一篇技术报告。Fish Audio 目前服务超过 1500 万用户,刚完成 5200 万美元种子轮,做这件事的底气不薄。
你如果做过配音或者有声书,会立刻明白它想解决什么——传统 TTS 读出来是平的,情绪要靠后期堆;Drama 3 想让情绪成为生成的一部分。官方给它贴的标签是「最具表现力、最可控的 TTS 模型」。这话听着像营销,但看它支持的玩法,确实有料:一次文本塞进 16 个角色,用方括号写导演指令,83 种语言随便切。下面拆开看。
和前代 S2.1 Pro 比,Drama 3 不只是换大模型,而是把「可控性」当成核心卖点。S2 系列也能合成,但情绪和角色得靠外部工程去拼;Drama 3 把它们收进模型内部,写剧本的人不用再身兼后期。对内容团队来说,这一刀切在了真正的痛点上。
方括号里写情绪:自然语言直接「导戏」
这是 Drama 3 最抓人的点。你在剧本里直接写 [happy]、[angry],或者更口语的 [barely holding it together](快撑不住了),模型就照着演。指令用什么语言写都行,不要求和台词同一种语言。比如一句台词前面标 [whisper](耳语),只有裹在
多角色更简单:用 <|speaker:0|> 到 <|speaker:15|> 切人,一条请求里最多 16 个角色轮流说话,API 里每人配一个 voice ID,整场戏一次调用就渲染完。你写对话剧本不用再拆成 16 段分别合成再拼接,口型节奏自然接得上。社区里已经有人试过「用大白话导态度」,比如写「替他们高兴,但要让人听出你心里在崩」——模型真把那种皮笑肉不笑演出来了。
英文还能喂 CMU Arpabet 音素、中文喂拼音、日文喂 romaji,遇到多音字和外来词可以手动指定读音,进一步压住发音翻车。你要的是可控,它就给你从词级到音级的双层旋钮,而不是一个笼统的「开心点」开关。
35B MoE 与架构:参数大却跑得动
Drama 3 的骨架基于 Qwen3.5-35B-A3B 初始化,40 层,每 4 层里 3 层是 Gated DeltaNet、1 层是门控全注意力。关键在 DeltaNet 用固定大小的状态存历史,所以只有四分之一的层需要保留 KV 缓存,显存和算力都省下来。MoE 部分有 256 个路由专家加 1 个共享专家,每 token 只唤醒 8 个路由专家,所以总量 35B、激活约 3B。
解码端换了新的 codebook-MTP 解码器,取代了 S2 的逐帧快自回归头,一次性预测每一音频帧的 9 个声学码本;音频分词器沿用 S2 的 Descript Audio Codec,44.1kHz、10 个码本、约 21.5 帧每秒。训练分三阶段预训练,再加指令微调和强化学习——RL 用 GRPO、不要 KL 惩罚,奖励来自一个学到的人类偏好模型,而不是死板的规则打分。
代价是参数涨了七倍多,但官方说在单张 H200 上单流解码 271 帧每秒,比 S2 的 177 还快,首包音频中位数 88.9 毫秒。这数字说明架构优化确实顶用了,不是纯堆参数的粗放方案。为什么要在意「激活 3B」这个数——解码是逐 token 进行的,每一步算力几乎只取决于激活参数量,而不是总参数量。所以你才不会因为 35B 的体量被显存和速度拖死,MoE 在这里就是那根效率杠杆。
官方还放出了 SGLang-Omni 的 Drama 3 配方(cookbook),按它跑能在单张 H200 上把 16 路并发推到 927.6 帧每秒。对想自托管的团队,这等于给了份现成的高速部署手册,不用自己从零调算子,也侧面说明这套架构在吞吐上留了不小的余量。
发音稳健性 93.2%:它到底强在哪
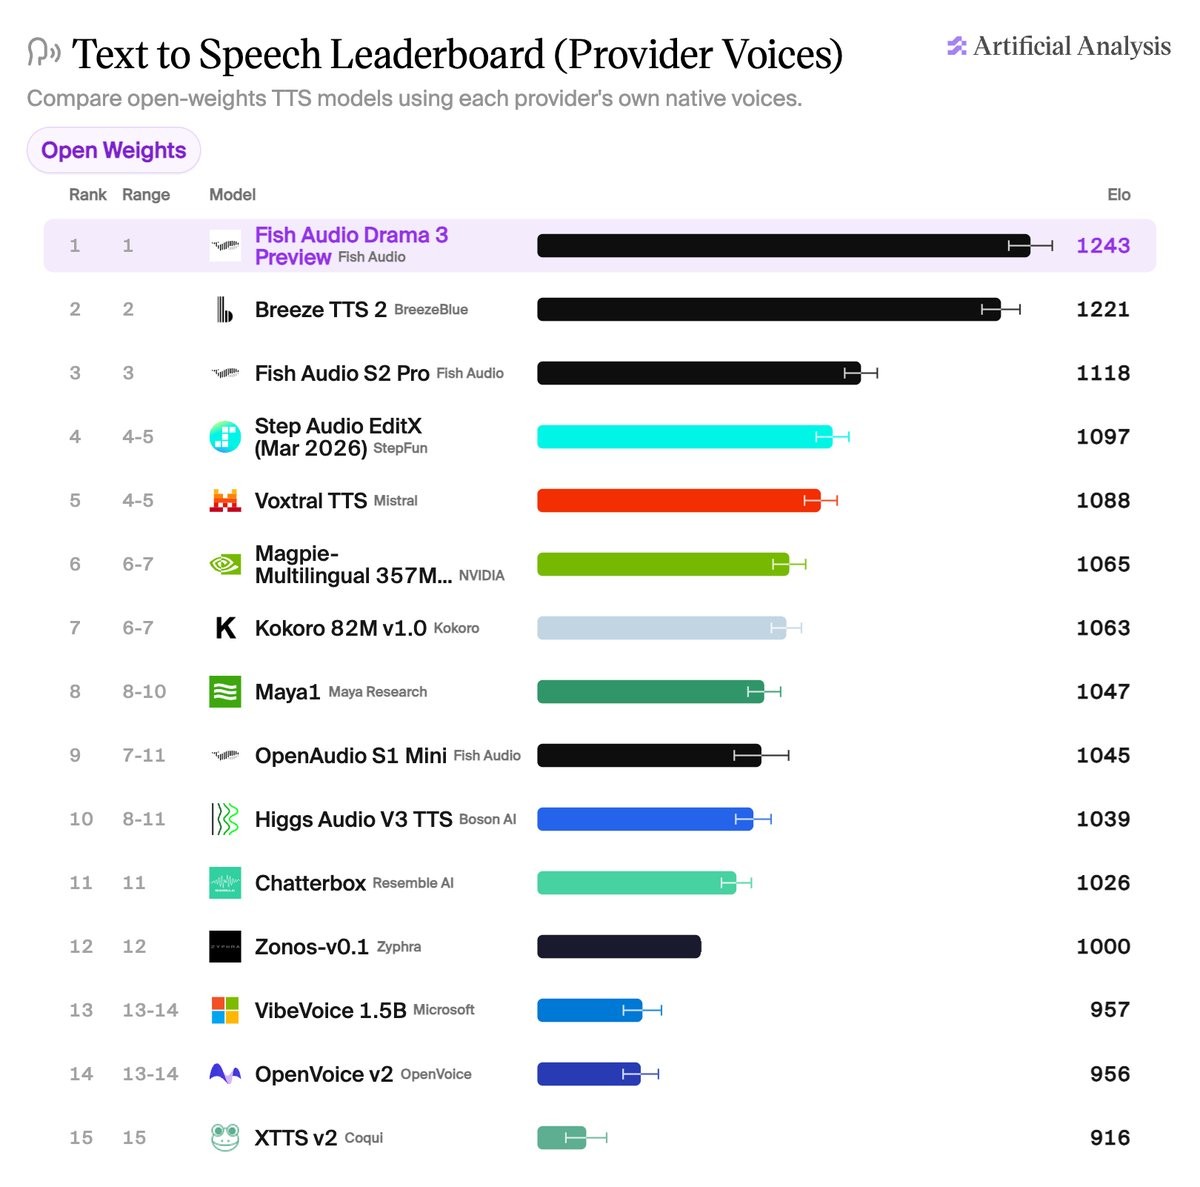
Artificial Analysis 的英文发音稳健性榜单上,Drama 3(标成 Drama 3 Preview)拿到 93.2%,排第一,压过了闭源的 Eleven v4(91.7%)和 Eleven v4 Turbo(90.1%),也比自家 S2.1 Pro 的 88.1% 高出一截。简单说,这项测试就是让真人评审听模型念一批难词——品牌名、地名、技术术语、上下文歧义词、编号缩写——再判断念对了没有,考的是嘴皮子准不准,不是情感好不好听,所以别拿它当音质唯一指标。
细分项更说明问题:品牌、地名、技术词 95.9%(S2.1 Pro 是 87.3%);看上下文才知怎么读的词 95.3%(86.1%);缩写、数字、日期、单位 93.6%(92.7%);最难的是精确序列——代码、路径、邮箱——86.3%(79.4%)。做技术播客、念产品名和长串编号的人,会直接感受到这块提升。在子榜上它也很能打:独立词条和精确序列保持两项排第一,缩写展开排第二。换句话说,念一长串产品型号、URL、账号这种最容易翻车的地方,它反而最稳。不过它在综合音质 Elo 上排第 10(约 1243 分),落后 Eleven v4 Turbo 的 1328,开源模型里倒是三榜第一。
48GB 显存门槛与社区许可边界
想自己部署,门槛写得很清楚:至少一张 48GB 显存的英伟达显卡,用 FP8 精度跑。CPU、苹果 MPS、AMD ROCm 一律不支持,官方服务走 SGLang-Omni,融合算子只在 Hopper 架构(H200、H100)上验证过。也就是说,你那张 24GB 的消费卡基本没戏,得上数据中心级显卡,自托管成本先算这一笔。
许可是 Fish Audio Community License v1.0,不是标准开源协议,边界要盯紧:研究和非商用免费;年营收 50 万美元以下商用也免费;超过这条线,或者你拿它对外提供 TTS、克隆声音、推理服务,就得单独找 Fish Audio 拿授权。成品还得标「Built with Fish Audio」。最硬的一条:未经同意克隆真人的声音,明令禁止。对个人开发者和中小团队,50 万美元的免授权线其实很宽,但做大之后成本会跳变,规划时要算清楚。
落地场景:配音、有声书与游戏 NPC
最对口的就是多人剧本:广播剧、播客、对话戏,一稿 16 人,导演指令精确到词。需要「带情绪旁白」的配音也合适——眼泪、愤怒、笑声、耳语,都能钉在台词的具体位置。念品牌名、技术词、长串编号的内容(教程、财报播报、新闻朗读)正好吃它发音稳健性的红利。游戏和互动叙事里,NPC 按剧情切换语气、多语言台词一次生成,省掉大量后期。
API 调用很简单:在原本给 S2.1 Pro 的 POST /v1/tts 上把 model 头设成 drama-3 即可,标价 50 美元每百万字符,发布期(10 月 13 日到 11 月 12 日)降到 10 美元。提醒一句,头写错或漏写不会报错,会静默回退到 s2.1-pro,排查时要留意。
横向看,开源阵营里它基本没有对手能同时给你 35B 表现力加开放权重;闭源这边 Eleven v4 Turbo 音质 Elo 更高,但价格贵且完全托管;阿里的 Qwen-Audio-3.0-TTS-Plus 走托管、列的语言也少。Drama 3 的取舍很清楚——用硬件和许可门槛,换可控与可自托管,适合不想把内容管道交出去的团队。
总结
Drama 3 把「用大白话导戏」做成了 TTS 的一等公民,方括号指令加 16 角色单请求,配合 83 语言,基本是为长内容配音量身定做的。93.2% 的发音稳健性帮它压过 Eleven v4 拿下第一,35B MoE 靠架构优化把显存和速度都压住了。真正的拦路虎是 48GB 显卡门槛和那条营收 50 万美元的许可线——自部署要算硬件账,商用过了线要谈授权。对中小团队和个人创作者,这是眼下最能打的开源语音模型之一;想上车的,趁发布期低价先把 API 玩熟再说。
