一句话看懂:Breeze TTS 2 到底是什么
如果你这两年关注过 AI 语音,大概会有个共同感受:第一波生成式 AI 把文本、图像、视频、语音都变成了随叫随到的成品,但大多仍是生成一次、消费一次的死东西。BreezeBlue 在 2026 年 8 月开源的 Breeze TTS 2,想解决的是下一波需求——让声音能实时响应:AI 角色、游戏 NPC、陪伴应用、语音 agent,都要边聊边出声,而且每次演绎还能跟着语境变。它把自然语言音色设计、对任意音色的指令遵循、低延迟流式生成,塞进同一个 3.48B 参数的模型里,官方把它称作"为交互体验而生的语音模型"。
三种造声方式:设计、克隆、引导
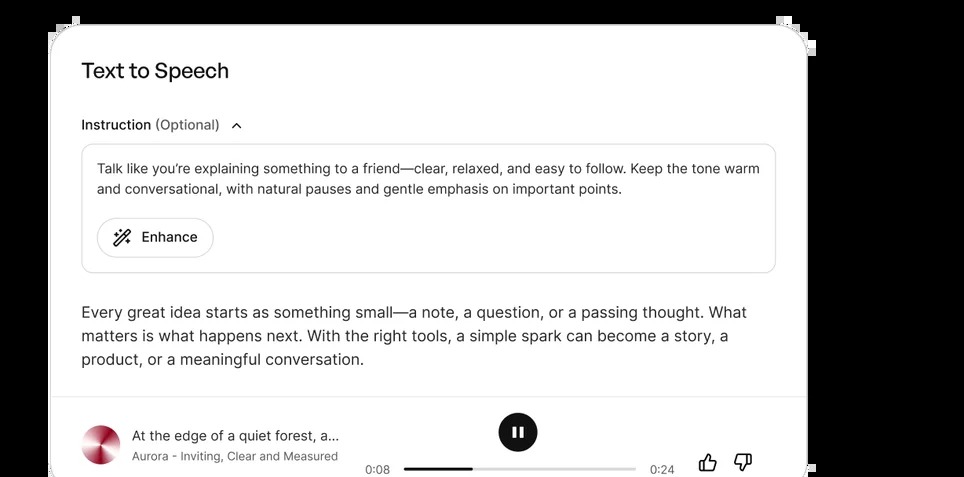
Breeze TTS 2 真正有意思的地方,是把过去要分开做的三件事合并了。语音设计(Voice Design)最省事:你不用去找参考音频,直接用自然语言描述想要的声音,比如"A warm, thoughtful young woman with a calm, reflective delivery",模型就生成对应的独特音色;官方建议加 --cfg-scale 4 来加强指令遵循。语音克隆(Voice Clone)则是给一段干净参考音频加上它的准确文字稿,模型保留音色、节奏、情感和风格,生成同一说话人的新台词。语音引导(Voice Direction)是两者的结合:先克隆身份,再用一条指令独立控制语气、情绪、语速和演绎方式——同一位配音演员,能在一行一行台词之间切换严肃或轻松,而身份不变。对游戏对话、互动叙事这类一个声音演很多情绪的场景,这一条最实用。
把笑和咳写进文本:内联发声事件与中英双语
真实对话里那些非语言的声音,以往要么靠后期叠层、要么干脆丢弃。Breeze TTS 2 支持在文本里直接写内联发声事件:英文用圆括号来标注,示例:(laugh)、(cough)、(clears throat)、(sigh);中文则用方括号,示例:[笑]、[咳嗽]、[清嗓子]、[叹气]。它一个模型同时生成自然的英文和中文语音,做中英双语内容不用再部署两套系统。这看着是小功能,但落到实际产品里,角色的真实感往往就差在这些细节。
延迟才是真门槛:首包 40ms、3.1 倍实时
对实时交互来说,自然度只是及格线,延迟才是体验分水岭。BreezeBlue 公布的实测是:在 NVIDIA H100 上走预热的快速路径,首包音频时间(TTFA)低于 40 毫秒,实时率(RTF)做到 0.32,也就是约 3.1 倍于实时速度生成音频。这意味着语音 agent 轮到它说话时,几乎不会出现让人出戏的停顿。GPU 占用也压得比较低:eager 推理大约吃 7.7 GiB 显存,12GB 显卡就能跑起来;想开 --fast-all 快速路径则需要约 14.4 GiB,官方推荐 24GB 显存。
跑分说话:在开源权重里它排第一
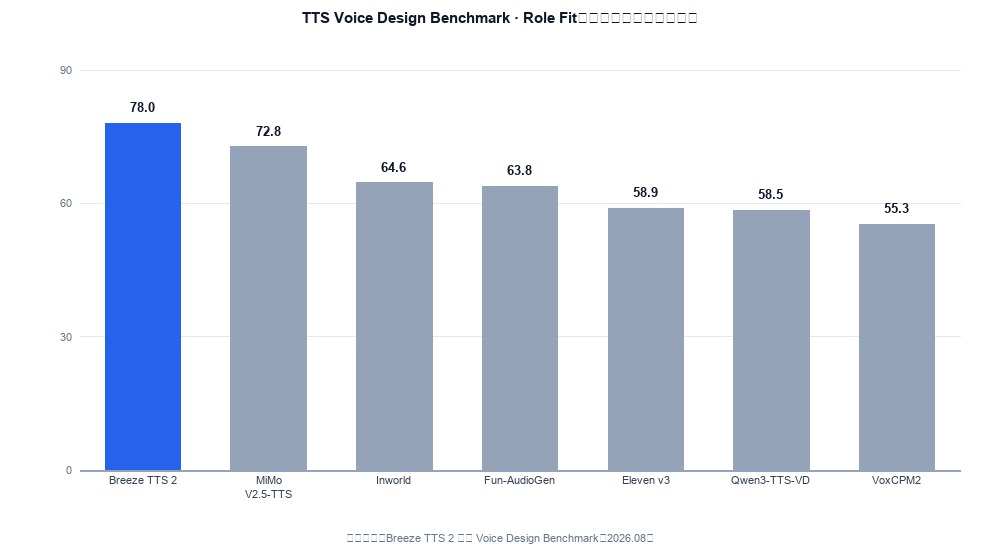
光说参数不够,得看榜。Breeze TTS 2 在 Artificial Analysis 的 TTS 排行榜上,按 Elo 打分在开源权重模型里排第一,官方称其表现甚至超过部分前沿闭源系统。更硬的是语音设计专项榜:Role Fit 拿到 78.02,Voice Diversity 708,Transcript Pass 98.5%,领先第二名 5.24 分,并且比最接近的对手多生成约 39% 的不同声音。同榜里 MiMo-V2.5-TTS、Inworld Voice Design、Fun-AudioGen-VD、Eleven v3、Qwen3-TTS-VD、VoxCPM2 都排在它后面。需要提醒的是,TTS 评测长期以自然度为中心,而音色设计、指令遵循和延迟一直缺系统基准,BreezeBlue 这次也同步开源了这三项的评测套件,算是把衡量标准一起往前推了一步。
本地部署与许可:硬件、安装、商用边界
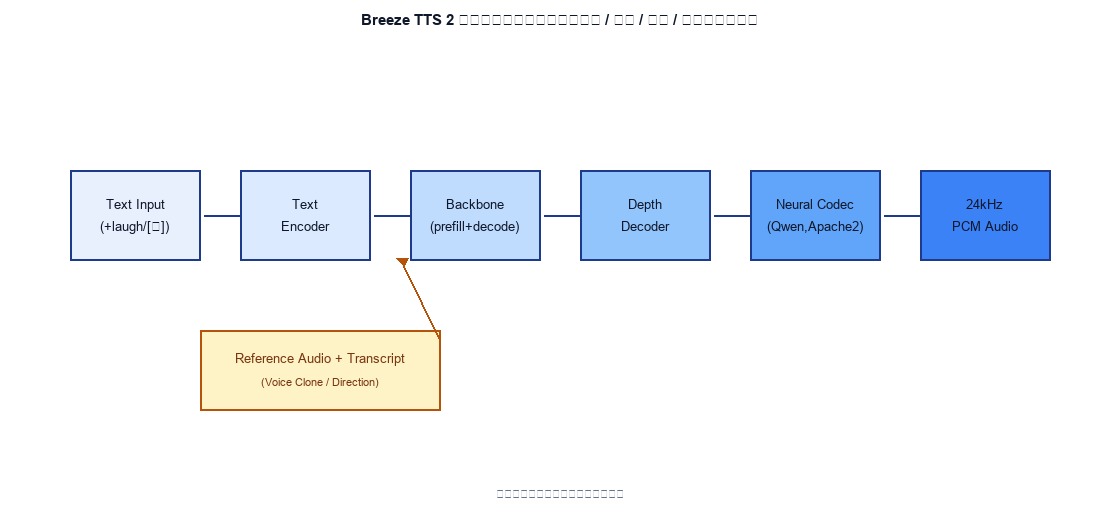
想自己跑不难。环境要求是 Linux、Python 3.10 以上、带 CUDA 的 NVIDIA 显卡,显存 12GB 起步。代码在 GitHub 上,git clone 下来装依赖,官方还给了 Docker 构建脚本(默认面向 H100/Hopper,A100 要设 FLASH_ATTN_CUDA_ARCHS=80)。推理就是一条 python infer.py ../breeze-tts-2 --ref-audio ... --ref-text ... --text ...;要做实时服务就起流式 API:python -m breeze_infer.api --host 0.0.0.0 --port 7860,请求走标准 POST /v1/audio/speech,返回的是 mono 24kHz 16-bit PCM——注意它目前是单并发,真要扛多用户得在前面架负载均衡。模型权重和推理代码也同步放在 Hugging Face 与 魔搭社区。许可这块得划清:源代码是 Apache 2.0,但模型权重、衍生模型以及自托管生成的输出,走的是 BreezeBlue 研究与非商业许可,只能用于研究和非商业;要商用,只能通过 BreezeBlue 的托管平台或 API 付费订阅,自托管输出本身不附带商用权利。
总结
Breeze TTS 2 不是又一个小众 TTS 玩具。它把用自然语言设计声音、按指令导戏、还能实时出声这三件过去要拼积木的事,压进了一个开源权重模型里,并且在语音设计基准上确实跑到了开源阵营头部。对做语音助手、游戏 NPC、互动叙事的开发者来说,它把造一个角色的声音从音频工程变成了写一句话。缺点也得说清楚:闭源商用有墙、自托管是单并发、目前只覆盖中英双语。如果你正打算给项目接一套能边聊边演的语音,它值得放进候选清单里认真试一把。
