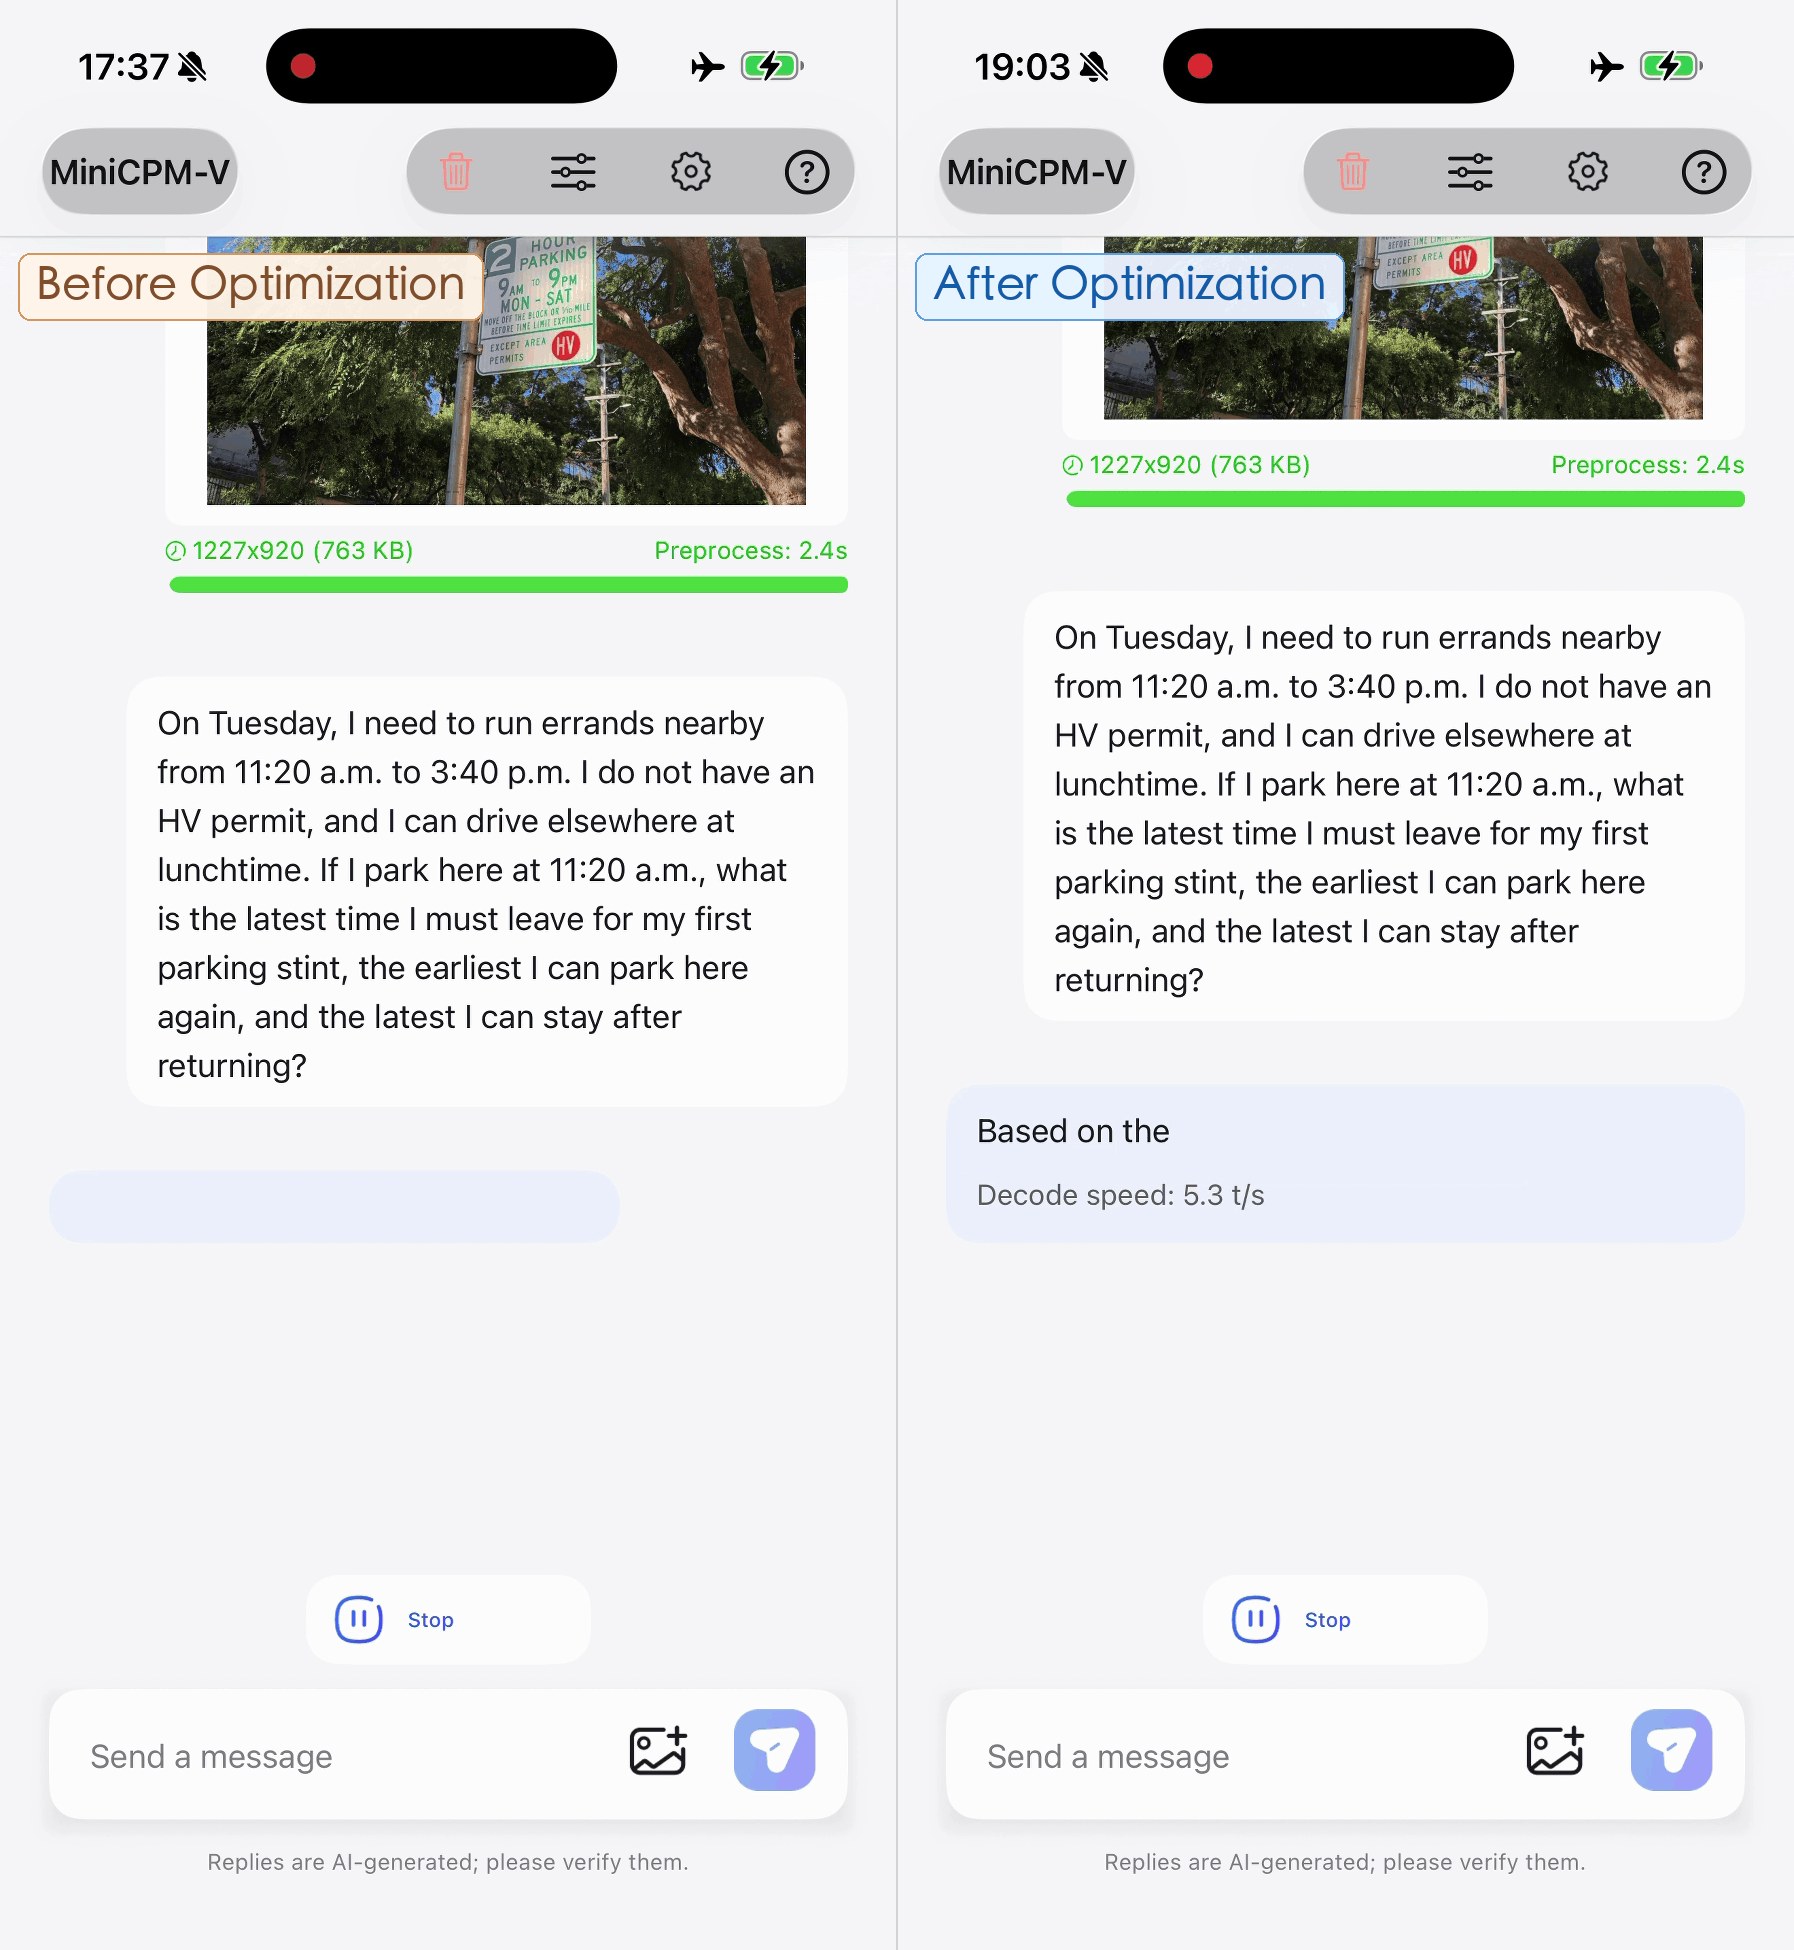
35B 参数的多模态模型跑在一台手机上,还能有 13 token/s 的解码速度——这不是调过速的演示视频,而是 OpenBMB 在 10 月 12 日发布 MiniCPM-V 4.7 35B-A3B 时给出的官方口径数据。它是 MiniCPM-V 系列第一个 MoE 架构模型,总参数约 35B,每个 token 只激活约 3B,官方称其为首个能在设备端无损流畅运行的开源 MoE,在 iPhone 17 Pro Max 上只占 3GB 内存。对想在自己手机上跑模型的开发者来说,这组数字以前基本只存在于愿望清单里。
35B 只激活 3B,这套 MoE 怎么搭的
先看命名。35B-A3B 沿用了开源 MoE 圈熟悉的写法:总参数 35B,每 token 激活约 3B,算力开销按激活参数走,存储开销按总参数走。HuggingFace 权重元数据显示总参数约 35.21B,配置文件里写了 256 个专家、每个 token 路由到其中 8 个,外加一个共享专家。语言骨干换成了 Qwen3.5 衍生的稀疏 MoE 文本栈,这是 MiniCPM-V 系列头一回用上 MoE 文本结构;视觉侧依然是 SigLIP 编码器,带窗口注意力合并。
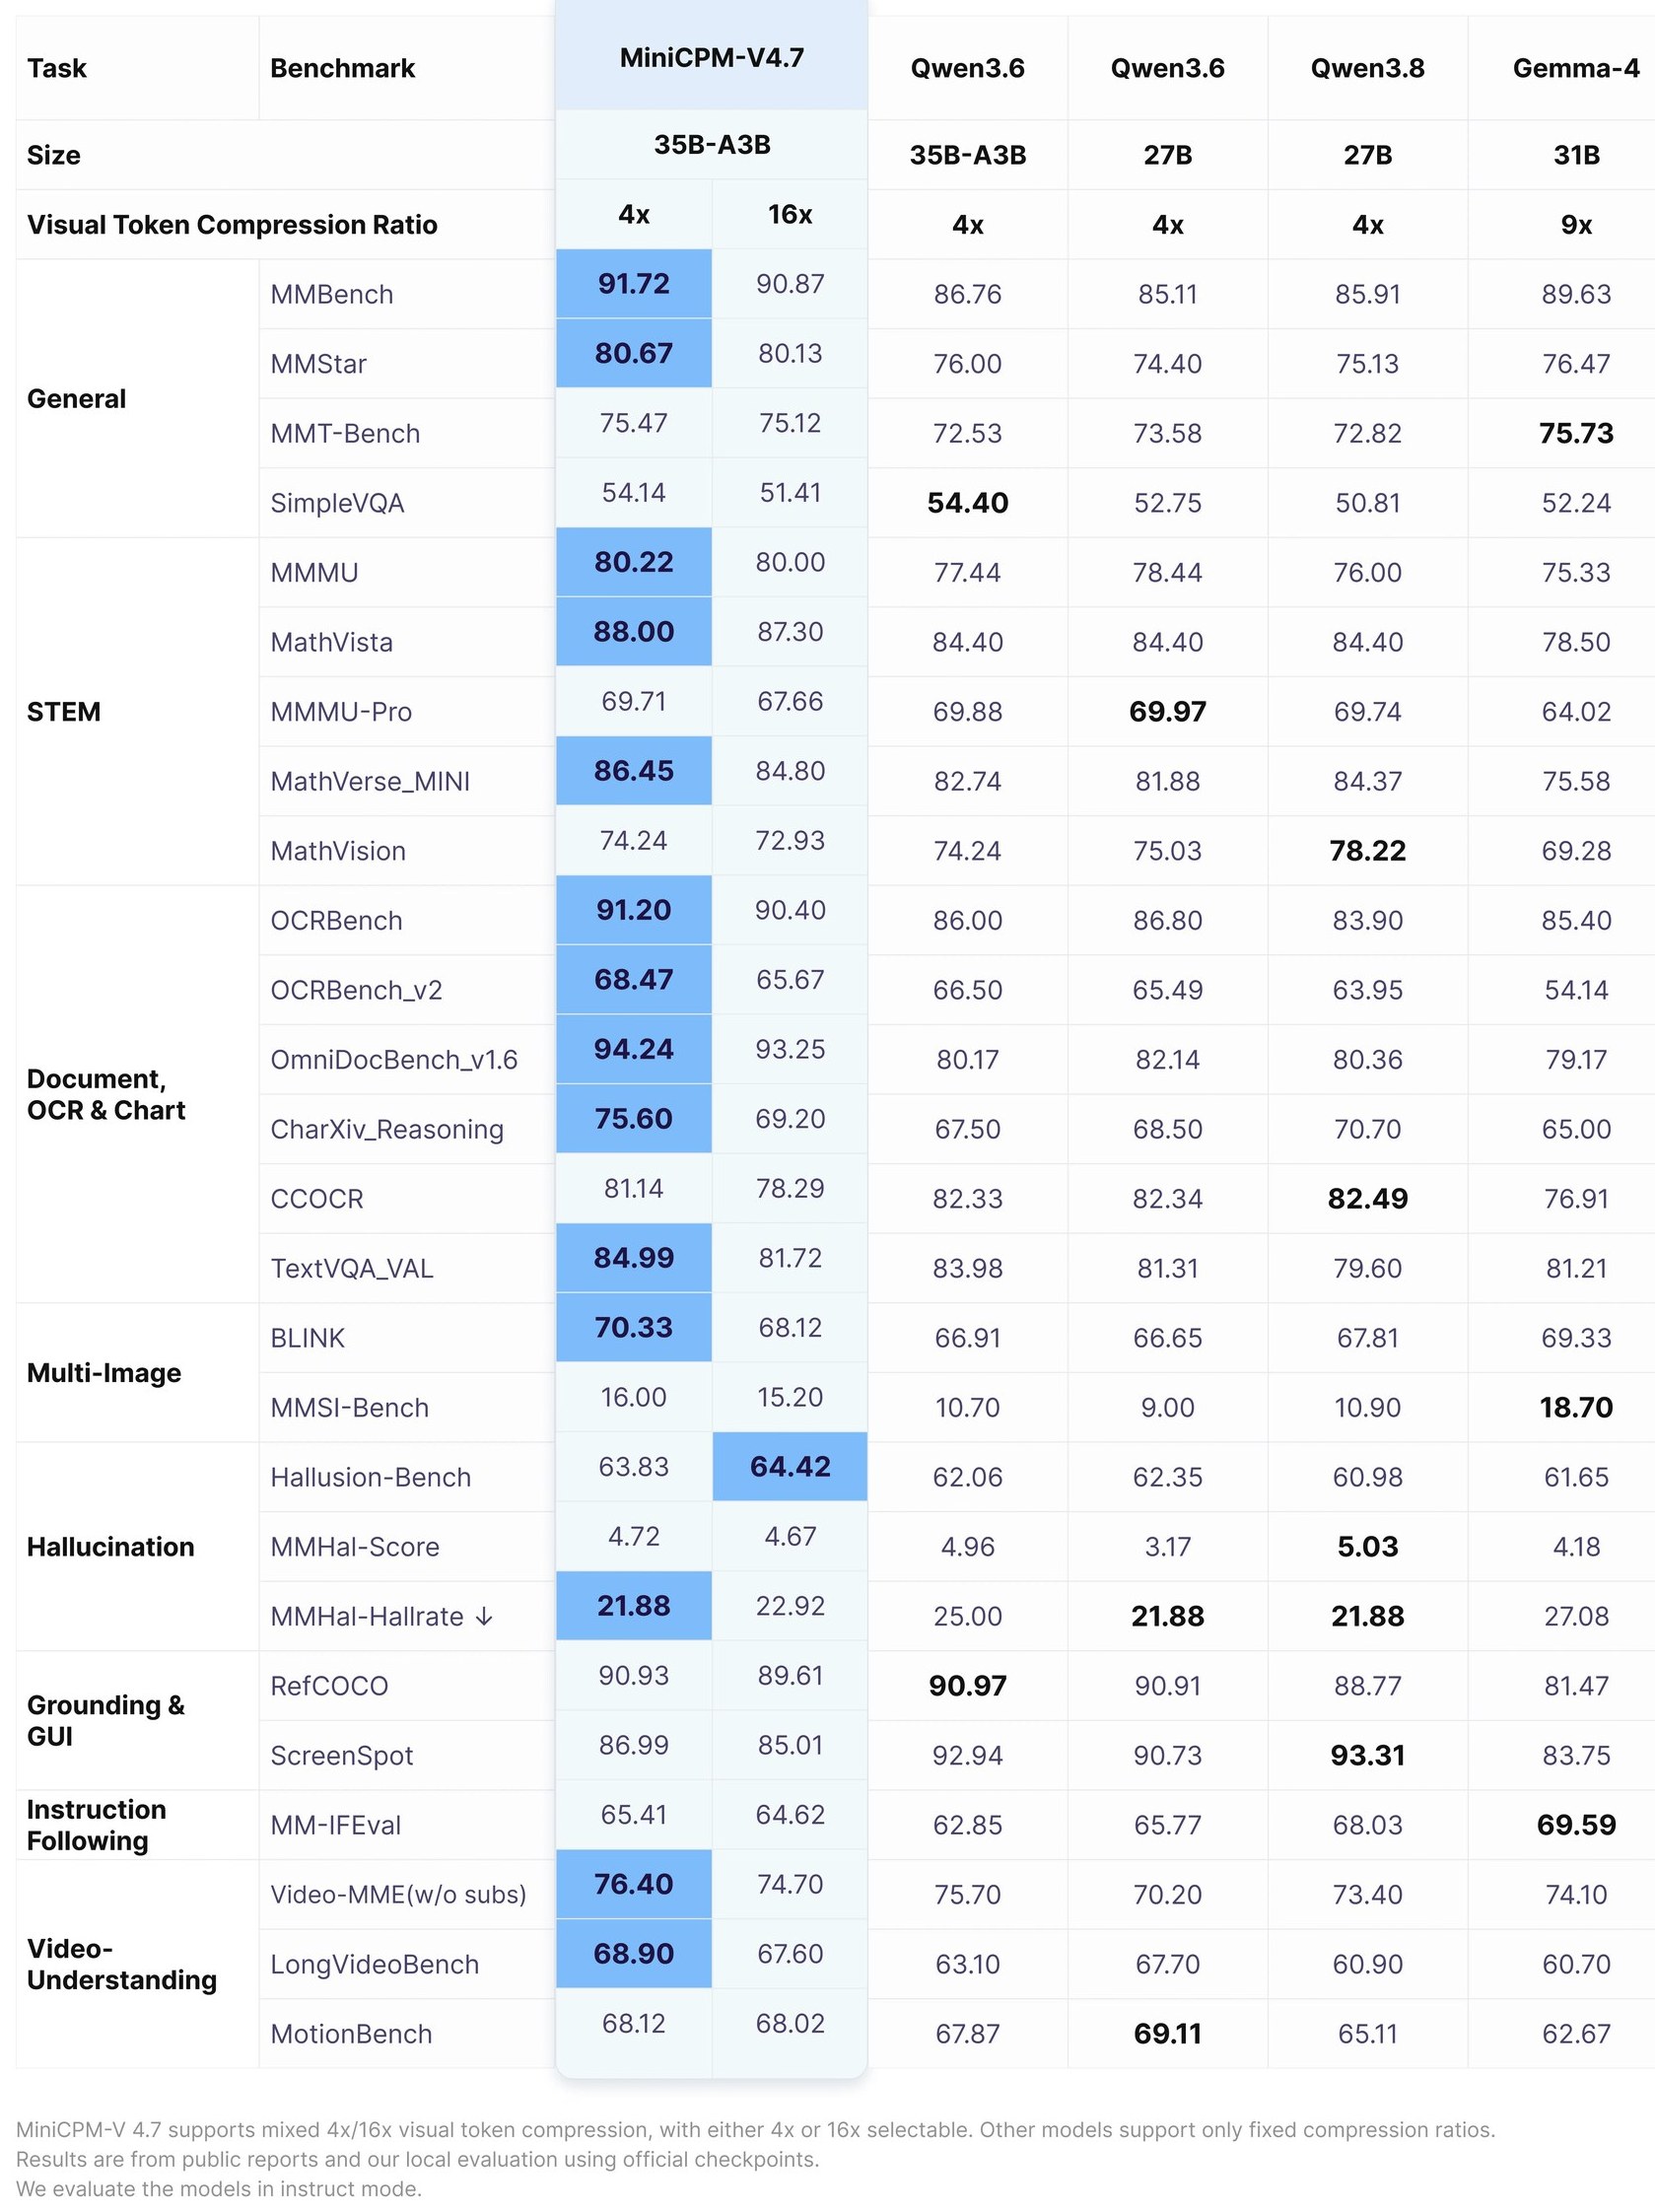
有两个细节值得展开。一是画布式 M-RoPE:视觉 token 不再沿一维序列编号,而是铺在二维画布上,每个 token 拿到(时间、高、宽)三维位置编码,同一张图的切片保住空间关系,视频帧保住时序,多图对话时模型也能分清「第一张图」和「第二张图」。二是视觉 token 混合压缩,视觉编码器内部就提前做了 4 倍与 16 倍两档压缩,运行时可切换。官方数据显示 16 倍压缩下 MMMU 只从 80.22 掉到 80.00,代价几乎可以忽略,不过 CharXiv 推理项会掉 6.4 分,压缩对图表类细粒度推理还是有感知。
整体配置是 40 层、hidden size 2048、16 个注意力头配 2 个 KV 头。注意力层做了混合设计:每 4 层里 3 层用线性注意力、1 层用全注意力,40 层里只有 10 层做全注意力。这套安排明显是在给长上下文和端侧显存省预算,配置上限写到 256K 上下文。
从用户视角看,这套设计的收益很直接:激活参数小,意味着每个 token 的计算量小,发热和耗电都压得住;权重在本地,截图、票据、私人照片不用传云端,隐私这条线捏在自己手里;离线也能干活,地铁里、飞机上不掉链子。多模态能力叠上去之后,手机能做的事就从「问个文本问题」扩展到「看懂屏幕、看懂文档、看懂视频」,这类体验过去只能在旗舰云服务里找到。
专家装不进内存,速度到底从哪来
MoE 放到手机上,难点不在算,在存。激活 3B 意味着算得快,但 256 个专家的权重是实打实要占地方的,一部手机根本装不下全部。官方在模型指南里把两条老路的坑都点明了:权重放 SSD 按需加载,频繁的加载停顿会让解码慢到没法聊天;限制专家池或者固定一个专家子集,速度是上去了,能力跟着掉。
MiniCPM-V 4.7 的解法是三件事叠着用。第一件是 Lookahead Expert Scheduling(LES):用跨层路由预测,提前把下一层可能用到的专家从 SSD 预取进内存;等真正的路由结果出来,已经被预取到的专家优先计算,剩下的专家边加载边让计算和读取重叠。关键在于预测只影响预取和调度,实际计算仍然完全遵循模型原始的 token 级路由,所以官方敢说「无损」——路线图没改,只是把等待时间藏进了流水线里。官方给的真机数据是 5 倍加速。第二件是细粒度逐层量化,把专家权重的存储占用和内存流量同时压下来,散碎读取也更高效。第三件是集成 DSpark 投机采样,用小草稿头替大模型起草、大模型验证,进一步抬解码速度。三件事各管一段,最终在 iPhone 17 Pro Max 上跑出 13+ token/s、3GB 内存的官方成绩,iPad M4 上也有实机演示。
实际部署下来还有个容易被忽略的细节:官方 App 说明建议设备至少 12GB 运行内存,端侧 GGUF 包下载体积约 16.6GB,里面除了主文件和视觉权重,还拆成 40 个专家分片方便按需流式读取。也就是说「3GB 内存」指的是运行时占用,想玩这台模型,手机本身得是旗舰档。
和 Qwen3.6 35B-A3B 掰手腕,赢面在哪
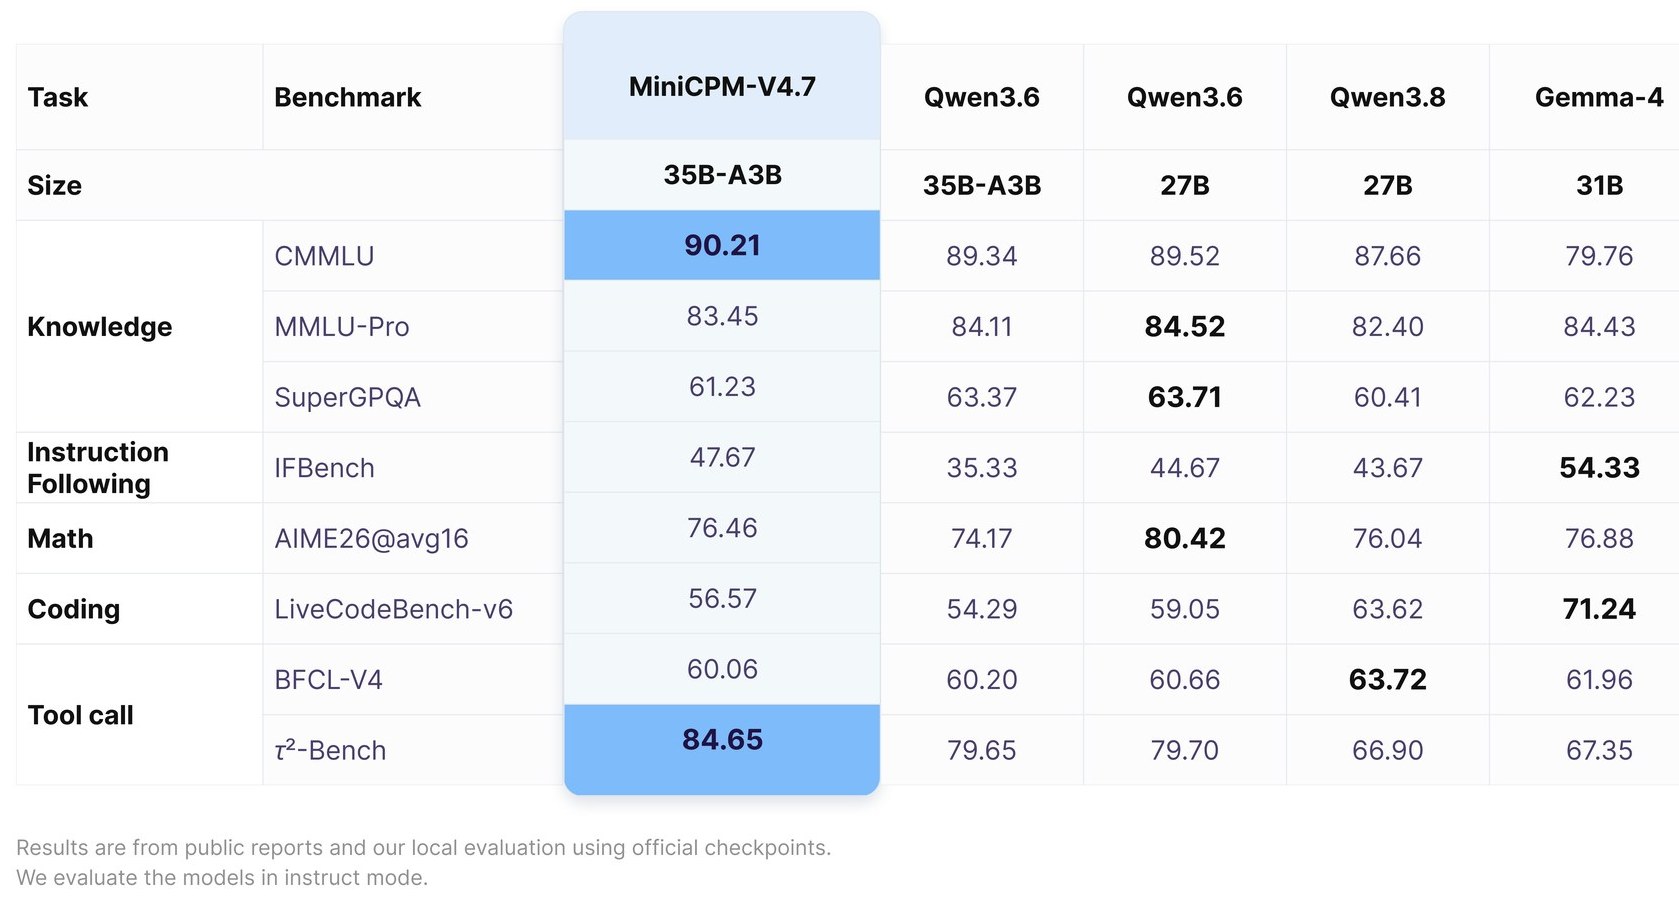
对标环节,官方把 Qwen3.6 35B-A3B 当成了主要参照物,结论是 Instruct 模式下整体得分更高、推理时间更短,画出了新的性能-效率前沿。拆开看各项:OmniDocBench v1.6 从 80.17 拉到 94.24,领先 14 分,文档解析这块优势明显;OCRBench 91.2 对 86.0,长视频理解 LongVideoBench 领先 5.8 分,工具调用 τ²-Bench 领先 5 分。输的地方也不藏着:屏幕定位 ScreenSpot 落后 5.95 分,BFCL-V4 工具调用基本打平,MMMU-Pro 和 MathVision 两项被反超,LiveCodeBench v6 拿到 56.57,跟 Gemma-4 31B 的 71.24 差了 14 分多,写代码不是它的强项。
得说清楚一件事:以上全部数字都是 OpenBMB 自己的报告,截至发布日还没有独立第三方的同口径复测。官方图表一向漂亮,最终成色要等社区用同一套 harness 跑过才算数,参考时建议以官方为准并留一分怀疑。不过即便只看方向,把 35B 级多模态能力的运行成本压到手机档位,这件事本身的价值不依赖某一项分数。速度这条线也有看点:官方口径里它用比对手更少的推理时间拿到更高总分,前沿要是坐实,同样的手机续航就能多干不少活。
顺带一提同场发布的 1B 版本,官方称总分和推理效率都高过 Qwen3.5 0.8B,还带 GGUF 权重。加上 35B-A3B,这次等于端侧高低搭配一次配齐。
Apache 2.0 全家桶,端侧生态第一天就铺开
开源策略上 OpenBMB 这次没有留手:代码和权重都是 Apache 2.0,商用没门槛。配套支持列表拉得很长——推理框架 SGLang、vLLM、llama.cpp、mlx-vlm、Ollama 全都有,微调走 SWIFT 和 LLaMA-Factory,量化格式覆盖 GGUF、BNB、AWQ、GPTQ、FP8。芯片侧第一天就支持 Apple、Intel、AMD、Arm、Rockchip 平台,经 FlagOS 还适配了华为、海光、摩尔线程、昆仑芯,Transformers 5.18.0 起可用,官方还给了一个 OpenAI 兼容的 serve 端点。端侧系统覆盖 iOS、Android 和鸿蒙。
落到使用场景,文档解析、OCR、截屏理解、多图问答这些端侧高频需求正好对着它的强项来。对做本地知识库、离线票据识别的人来说,OmniDocBench 那 14 分领先如果能复现,意义比跑分榜更大。微调侧同步开源了 SRFT 方法,用固定回放数据混训来压遗忘,官方例子显示任务上 gain 基本不变的情况下,通用能力回退从 7.92 分缩到 1.59 分,想在垂直场景改造它的人可以少踩坑。
想先看效果再动手的人,官方在 HuggingFace 上挂了在线 Demo,不用自己部署就能试多图和视频理解。跑通本地之后,常见姿势是用 llama.cpp 或 Ollama 拉量化包,日常对话走 4 倍压缩档、长文档切 16 倍档,按需在速度和精度之间做取舍。1B 版本则更轻,连鸿蒙设备都在支持列表里,老手机也有得玩。
网友评论
- 3B 激活跑 13 token/s,听着提气,但 12GB 运存起步把大部分老机型挡在外面了,等 llama.cpp 复现再说。
- 量化到端侧,牺牲多少精度才是关键,官方图表永远漂亮,我就关心 OCR 硬指标掉没掉。
- OmniDocBench 94 这个数要是真的,我的发票识别脚本可以直接下岗,先蹲一个第三方复测。
- 40 个专家分片从 SSD 流式读,这读取强度天天跑,闪存寿命扛得住吗?
- 线性注意力占四分之三的层,256K 上下文是配额不是承诺,长文档实际表现还得看实测。
以上评论仅代表网友个人观点,不代表官方立场。
写在最后
MiniCPM-V 4.7 35B-A3B 的看点不在某一单项分数,而在于它把「35B 级多模态」和「手机端侧」这两个原本不搭界的词接到了一起。LES 加量化加投机采样的组合拳思路也算给同行打了样:端侧 MoE 的瓶颈在存储和调度,不在参数本身。眼下所有成绩都是官方口径,复现结果出来之前不妨让它先飞一会儿;但对端侧 AI 这个方向来说,多一个认真的开源玩家,总是好事。
