10 月 6 日,OpenAI 在 GitHub 上悄悄公开了一个仓库,没有发布会,也没有倒计时海报。里面躺着 719 份数学研究手稿,全部出自一个至今没有对外发布的内部模型。上线第二天,仓库的更新记录里就出现了 3 份撤稿和 14 处修正。一边是几天之内批量产出的前沿数学论文,一边是要以年为单位计算的验证进度——这场倒挂,才是整件事最值得琢磨的地方。
719 份手稿里到底装了什么
先把家底数清楚。模型在评估阶段总共写出了 722 份手稿,目前目录里收录 719 份,归入 372 个「家族」——一个家族可能包含一个主结果、几条配套论证、若干推论,或者同一命题的不同证法。学科跨度相当大:数论、代数、几何、组合、拓扑、概率、统计力学、数学物理、理论计算机科学都有涉及。
产出的流程倒是不神秘:官方说明里写了,评估期间模型一共被投入约 4000 道开放问题,平均每个入选结果消耗大约三小时的 ChatGPT Pro 级思考算力。折算下来,一份手稿的生成成本比很多人一个月的订阅费还低。生成端已经便宜到可以流水线作业,问题全留在了读的那一端。
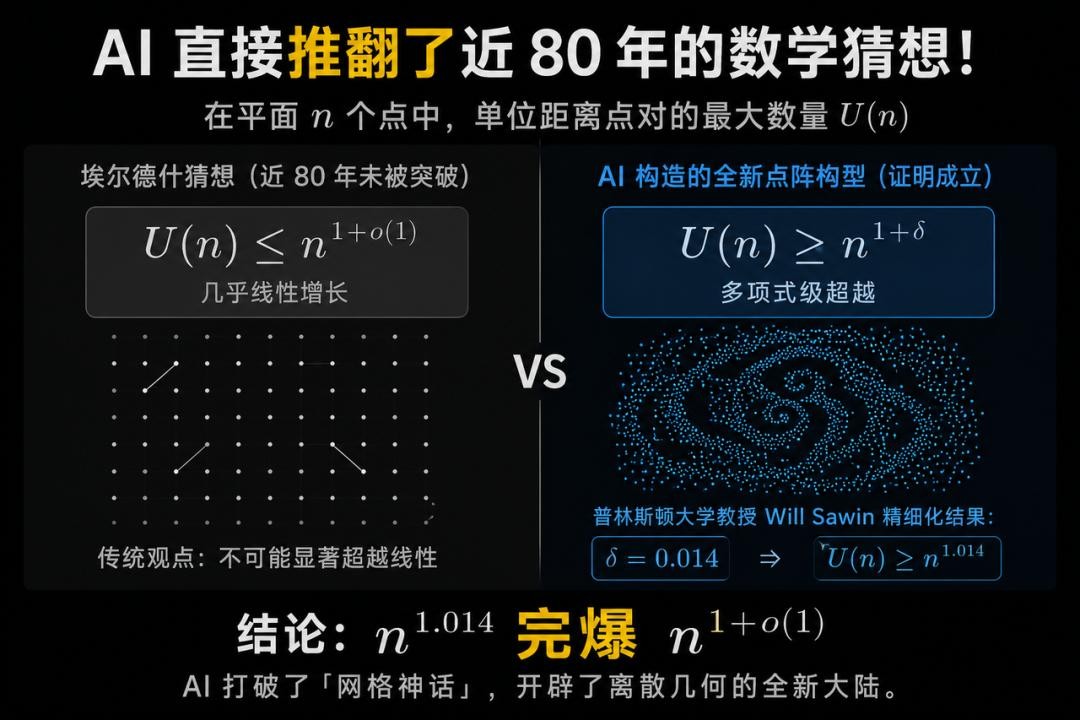
分量上也不是凑数的练习题。离散几何里悬置几十年的埃尔德什单位距离猜想被给出反例,曼彻斯特大学的数学家 Thomas Bloom 直接称之为「迄今为止人工智能在数学领域最令人瞩目的成就」;π 的无理性指数、稀释自旋玻璃的 Mézard–Parisi 公式、三维相对论 Vlasov–Maxwell 系统这些硬骨头也都在清单里。官方放出了 10 份模型推理过程的节选摘要,能看到它试错、换工具、推翻自己思路的全过程。
另外有社区爱好者把目录和 Proof Atlas 排名的前 500 个开放问题做了交叉比对,数出大约 90 个「宣称完整解决」的条目——这个数字来自非官方统计,具体以仓库目录为准。不过即便打个对折,也足够吓人了。
Lean 形式化:给证明请一位不近人情的裁判
普通人看到「AI 写了 719 篇数学论文」,第一反应是厉害;数学家的第一反应是「谁检查过」。这就要说到 Lean——一种定理证明语言,把证明的每一步逻辑写成代码,交给计算机逐行核对。它没有审稿人的情商,也从不给人面子:编译通过就是通过,任何一处推导漏洞都会被直接揪出来。
这次公开的手稿里,大约 300 份核心结果完成了 Lean 形式化,占比 42%。OpenAI 承诺会陆续补上更多。剩下的 58% 呢?用仓库自己的话说,未形式化的结果「可能存在问题」。这句话翻译过来就是:一半以上的货,目前只有模型自己担保。
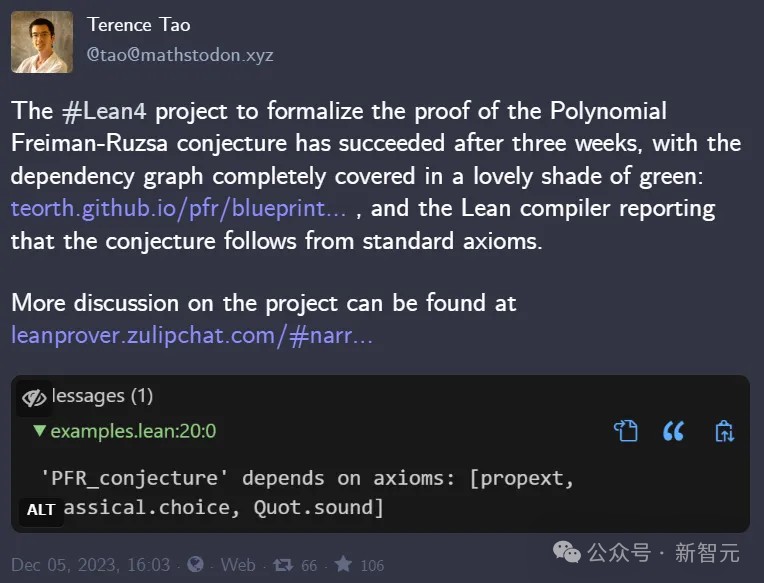
陶哲轩此前主导的 PFR 猜想形式化项目是个很好的参照:三周时间,全球志愿者协作,依赖图全部变绿,Lean 编译器最终确认整个证明只依赖标准公理。那是人类数学家首次完整体验「机器验证一条顶级行业新闻」的流程——可靠,但极其费人工。
而且 Lean 不是万能钥匙。它验证的是「这段逻辑自洽」,不能告诉你结果是否新颖、问题是否重要; Lean 代码通常只覆盖论文的主结果,而非其中每一句话;连用于比对的陈述文本也是 OpenAI 自己撰写的,写得准不准是另一个问题。已有研究者指出,个别成果的自然语言证明和对应的 Lean 代码之间存在对不上的地方。形式化是硬约束,但它救不了陈述本身的质量。
3 份撤稿、14 处修正:真正的新闻在这里
公开第二天,有人发现其中一份证明里有个符号错误。OpenAI 随即撤下 3 份手稿,修订 14 份,并且把每一步更正都记入版本历史,旧版本照样可以查。
表面看这是负责任的表现——确实比藏着掖着强。但换个角度看,这个速度差才叫触目惊心:产出 722 份手稿用了几天,发现并处理一个符号错误用了不到一天,而把剩下 700 多份彻底读完,数学界的共识是要以年计。伦敦帝国理工的 Kevin Buzzard 抱怨得很直白:他领域里的定理一大把,扫一眼真正亮眼的只有六个左右,而且几乎没有一条完成了形式化。「我要么去读可能不对的东西,要么等着别人去读,要么等着别人把它形式化。」
数学界给这类内容起了个词:slop,低质量机器产出。当成品快过验证、产出多过审稿人,堆出来的就是一座需要全行业买单的欠账。审稿不是流水线,一个细分方向上能严格把关前沿论文的人,全世界可能一只手数得过来。
对科研圈意味着什么
The Verge 前后找了三十多位数学家聊,收到的形容词包括「目瞪口呆」「不知所措」「超现实」和「纯粹的疯狂」。光是读完仓库里约 40 页的目录和摘要,就有教授花掉将近一个小时。
火气也是真火气。设在普林斯顿高等研究院的数学与人工智能顾问组此前刚建议过:不要拿专有模型去刷高深的开放问题,发布时应给出模型名称、提示词、算力开销等细节。这次公开只给了平均算力和 10 份摘要,其余建议大多没跟上。有数学团体在声明里把这次发布称为「力量的展示而非学术」,呼吁同行停止配合,连陶哲轩都转发了这份声明。他的批评一针见血:传统数学突破会带来报告、研讨和合作,而这批结果由一群对领域本身不感兴趣、也没法答疑的存在生成,理解的工作被整个推给了共同体。
冷静的声音同样存在。认知科学家 Gary Marcus 指出,这个模型走的是神经符号路线,用符号验证兜底数学论证,但「这不意味着 AGI,数学上的东西没法直接泛化到开放的真实世界」。也有人认为公开总比私藏好,堵是堵不住的。OpenAI 的姿态倒是放得低,宣布将资助一系列研讨会和工作坊,帮社区消化这批成果,还在探索把后续仓库交给社区托管。
更长期的影响在于价值链条的挪动。当「产出」变得廉价,「验证」就成了稀缺资源:Lean 形式化、可复现的验证脚本、审稿流程的改造,这些原本冷门的活计一夜之间站到了舞台中央。陶哲轩去年就提醒过,将来稀缺的不是好答案,而是好问题。现在这句话正在应验。
网友怎么看
- 「平均三个小时算力出一篇数学论文,我博士五年写了三页,先去哭一会儿。」
- 「42% 形式化还敢全量公开,这个透明度我给好评,至少撤稿记录都留着,比某些期刊强。」
- 「有没有一种可能,剩下那 58% 里还埋着一堆符号错误没被翻出来?」
- 「数学家抵制得有道理啊,你生成一秒钟,人家验证一辈子,这不是把同行当免费审稿工人吗。」
- 「就想问一句,单位距离猜想那个反例,什么时候有人能逐行看懂并且确认它成立?」
以上评论仅代表网友个人观点,不代表官方立场。
写到最后
这批手稿的价值,其实不在「AI 又解决了多少难题」——719 份里大多数还没被读懂,撤稿和修正也只是刚刚开始。真正的信号是行业的分工正在改写:生成端交出了工业级的产能,验证端还停留在手工作坊时代。OpenAI 自己都在仓库里写明,未形式化的部分可能有错,欢迎全世界的数学家来挑刺。
所以与其争论这是不是 AGI 的又一次登顶,不如盯着那 42% 和那 3 份撤稿看:前者是机器能自证的边界,后者是机器犯错后仍需人类兜底的证据。等验证的速度追上产出的速度,再谈革命不迟。在那之前,数学家们的日程表上,恐怕又多了一座待清算的山。
