10 月 12 日,Z.ai(智谱)正式发布法律领域专用模型 GLM-Legal。这款模型建立在自家的 GLM-5.3-Flash 底座之上,专攻合同审查、证据分析与合规研究这类律所和法务团队的日常硬活。官方给出的成绩单相当亮眼:在 Harvey LAB 法律智能体基准上拿下 19.2% 的全通过率,比底座模型足足高出 12.5 个百分点;在 LegalBench 和中文法律评测 PLawBench 上,它也追平了参数量远超自己的前沿闭源模型。
更让人在意的是成本。第三方评测数据显示,GLM-Legal 跑完一次 Harvey 基准任务只要约 0.15 美元,而对照组里的 Gemini 4 Argon 大约要花 10.55 美元,差出约 70 倍。用轻量底座打出前沿效果,再把账单砍到零头,这套打法如果经得起真实场景的检验,法律 AI 的使用门槛可能会被明显拉低。
合同、证据、合规,三件硬活它都想接
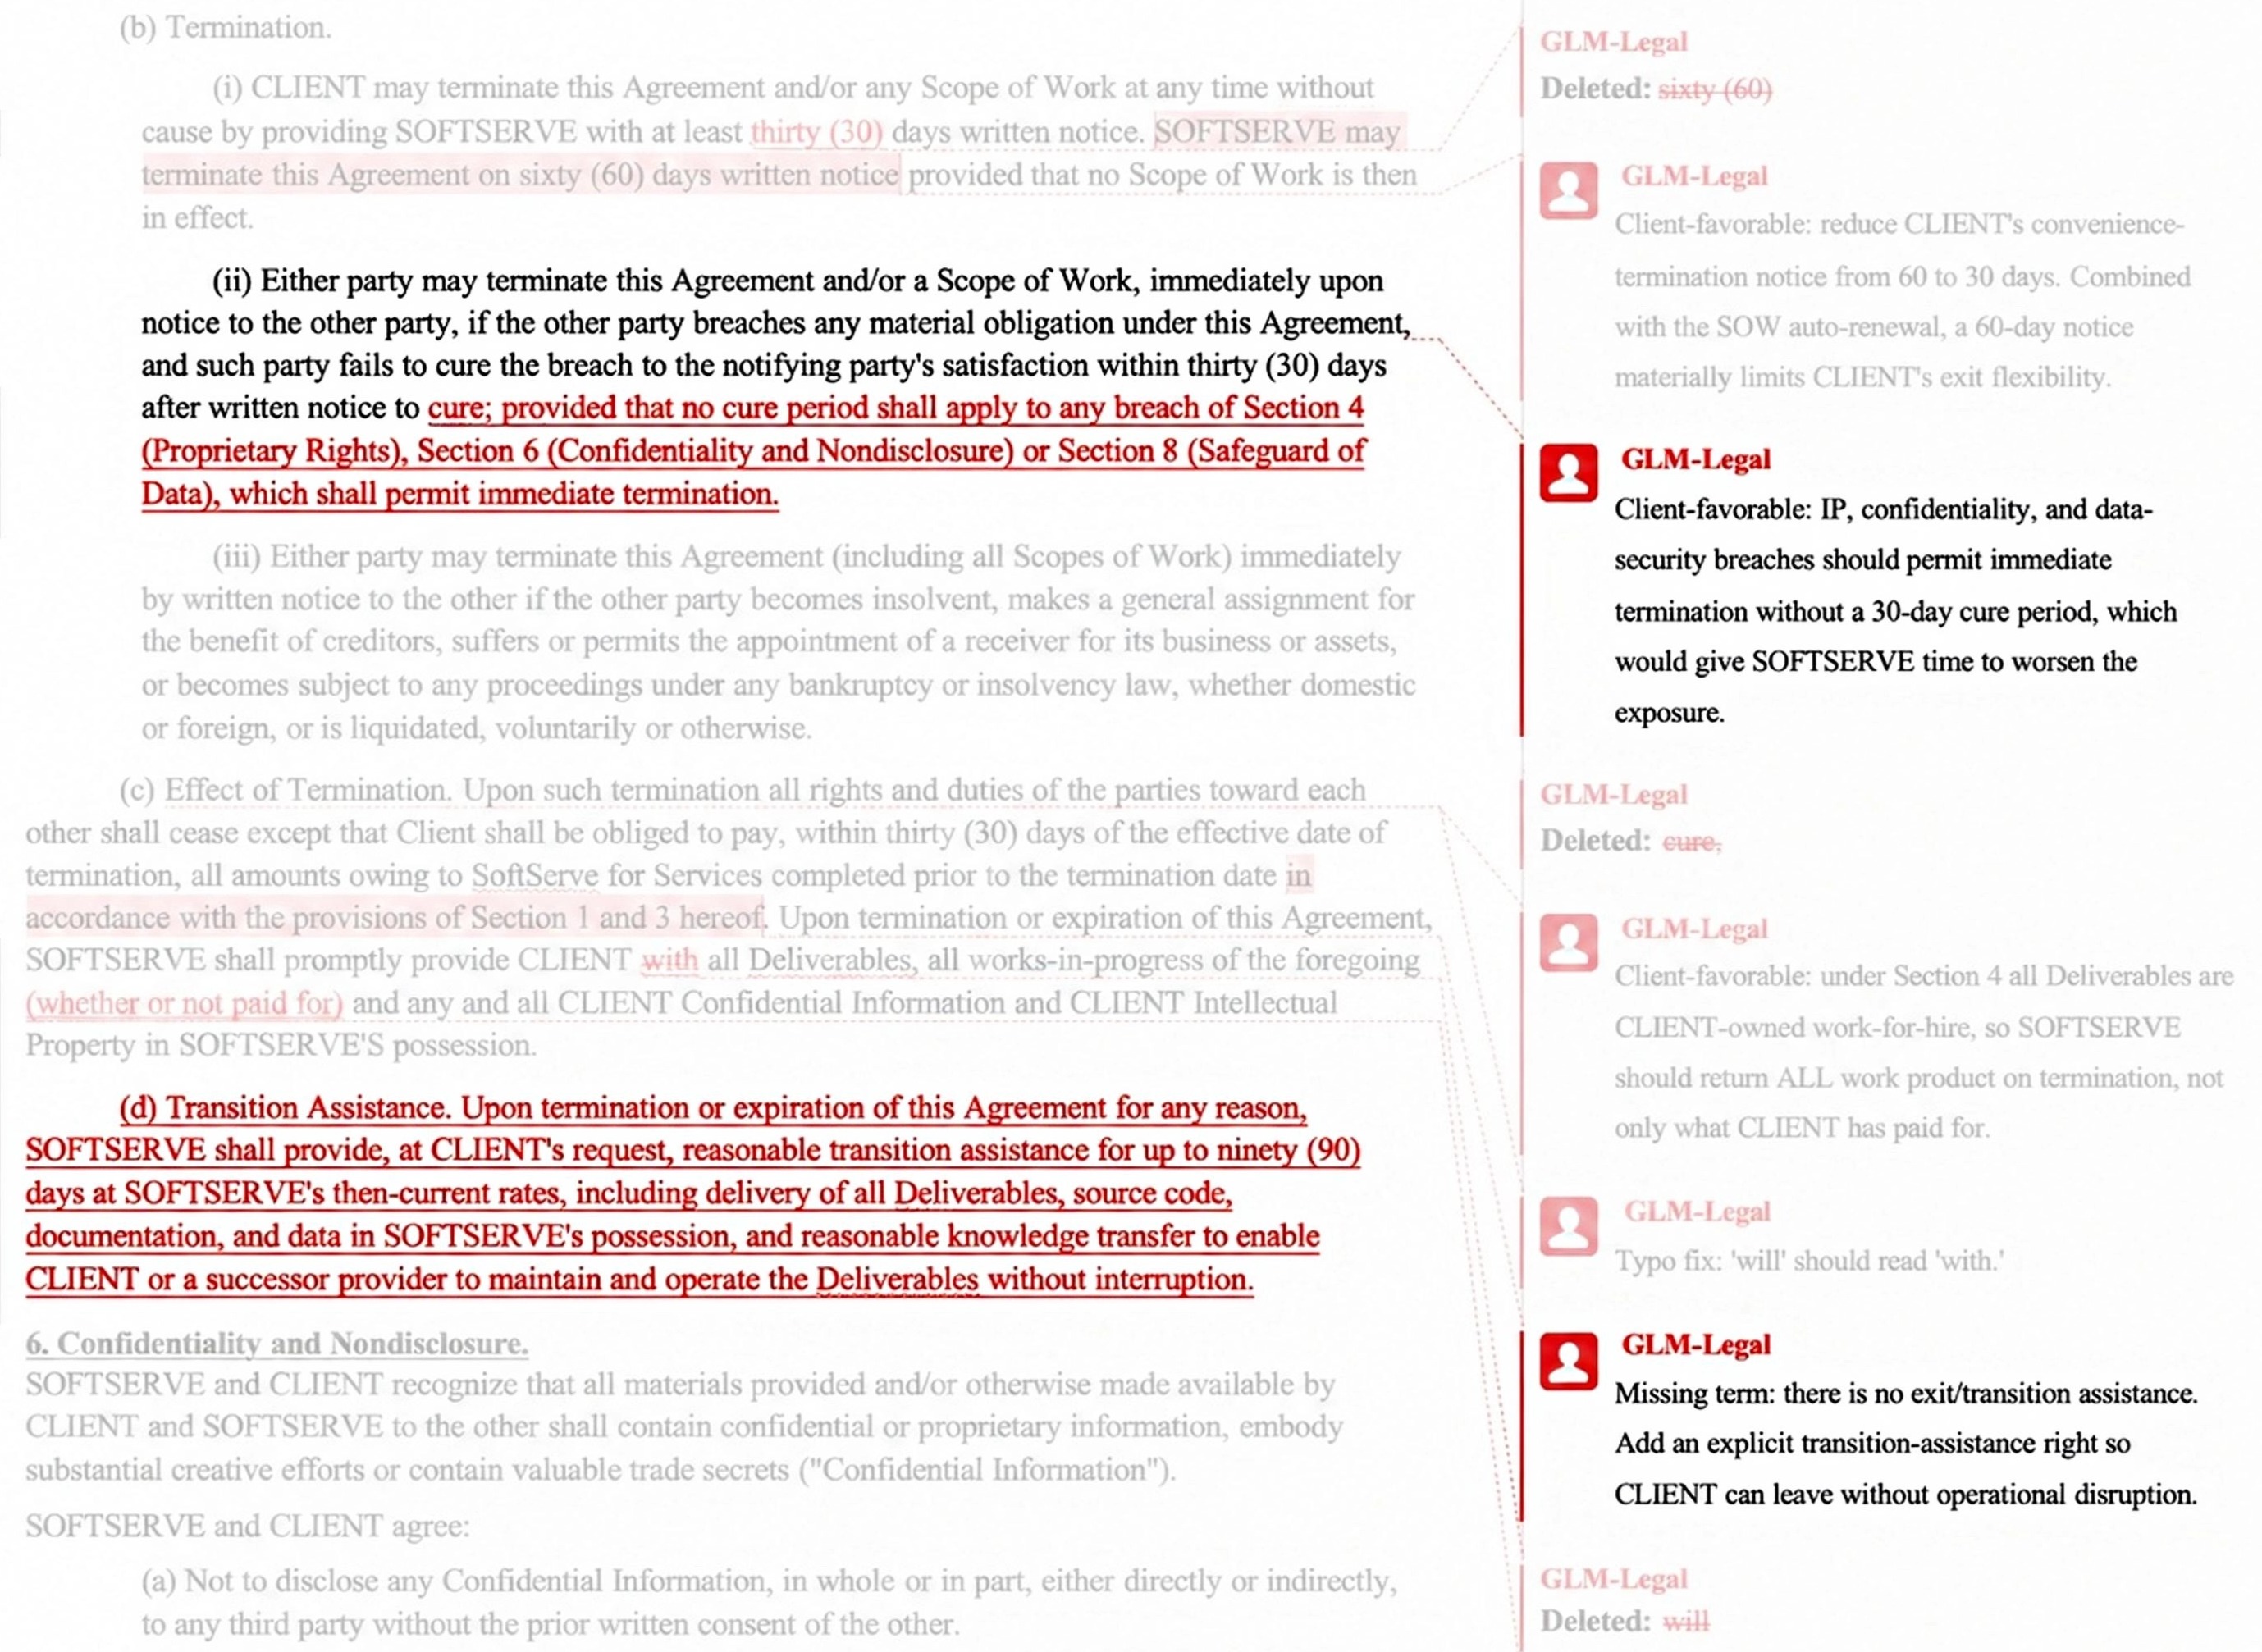
合同审查是最先放出的演示场景。GLM-Legal 不是简单圈出「这里可能有风险」,而是直接给出改法:在一份软件服务合同的演示里,它建议把客户方无理由解约的通知期从 60 天压到 30 天,删掉知识产权、保密和数据安全违约情形下的补救期,让客户可以立即终止合同,同时要求对方在解约时归还全部交付物和未付款的在制工作,并补充最长 90 天的过渡协助条款,覆盖源代码、文档、数据和知识转移。这些修改建议可以由 AutoClaw 直接落成 Word 文档里的修订痕迹和批注,而不是停留在聊天窗口里。
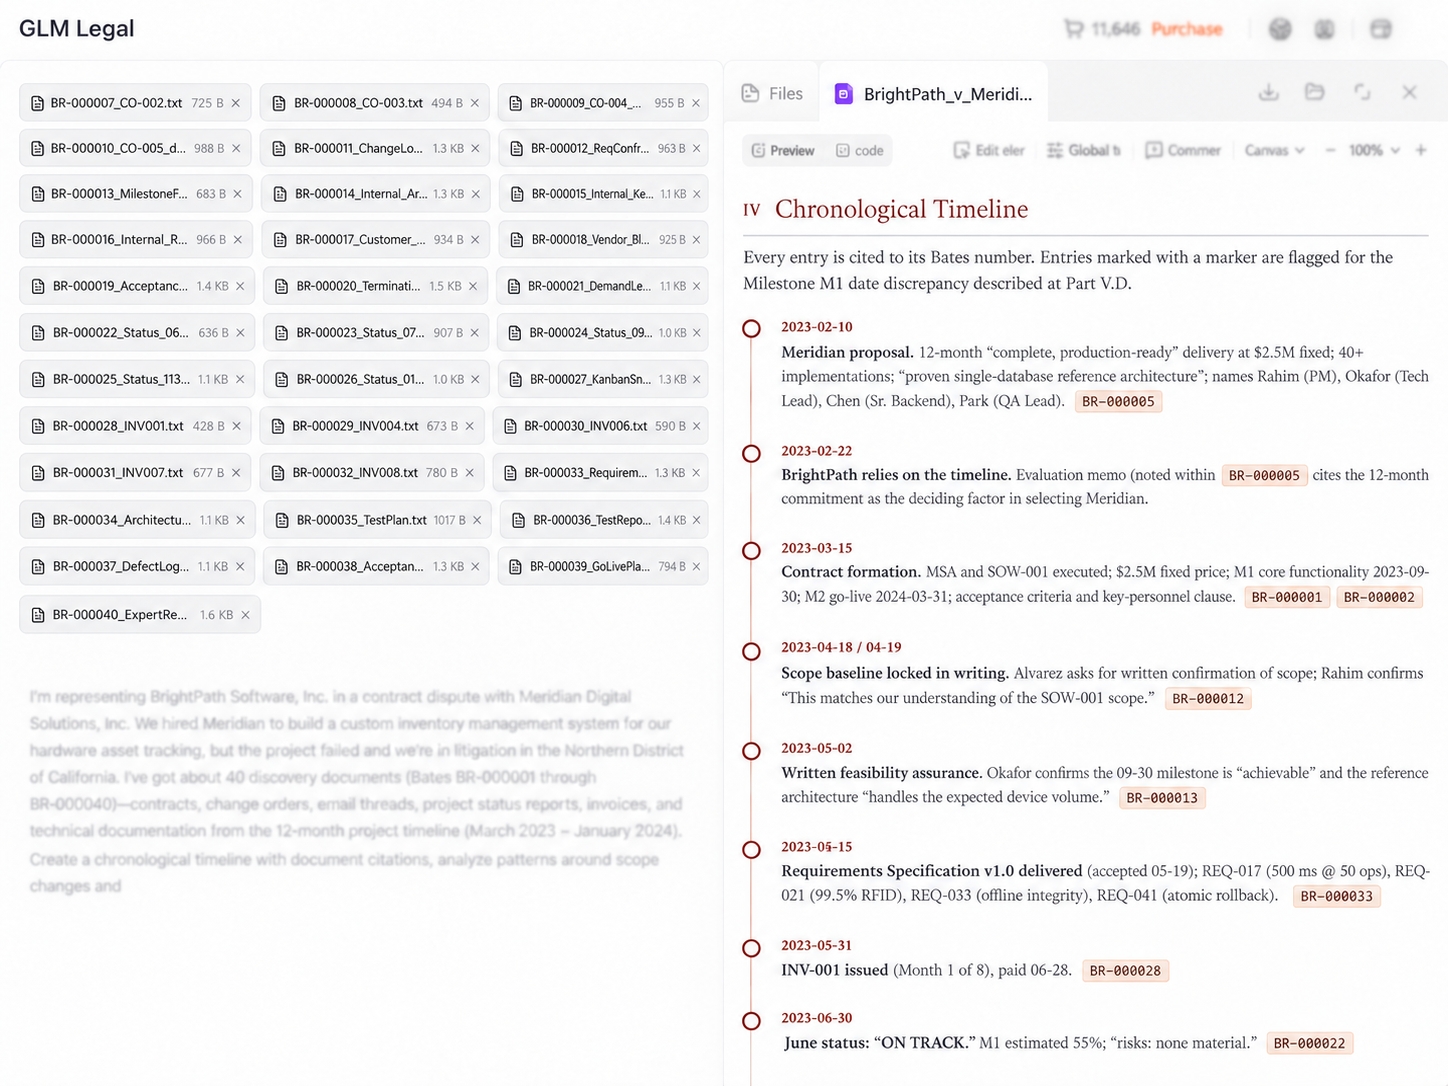
证据分析的场景更能看出它的斤两。在一个软件项目纠纷的演示里,模型要读 40 份案件文档,把对外报告和内部记录摆在一起对照:9 月 30 日发给客户的报告声称项目进度 60%、一切正常,但 9 月 8 日的内部警告承认里程碑「没法如实达标」,内部快照记录的实际完成度只有约 41%,中间还夹着一条要求压制风险、继续开票的内部指示。模型把这些矛盾串成一条带出处的时间线,引用主服务协议里「付款不视为放弃权利」「保证条款在付款后仍然存续」的条款,为隐瞒类主张搭好论证骨架,同时明确提示哪些构成要件还要继续核实——事实观察和法律推断分得清清楚楚。
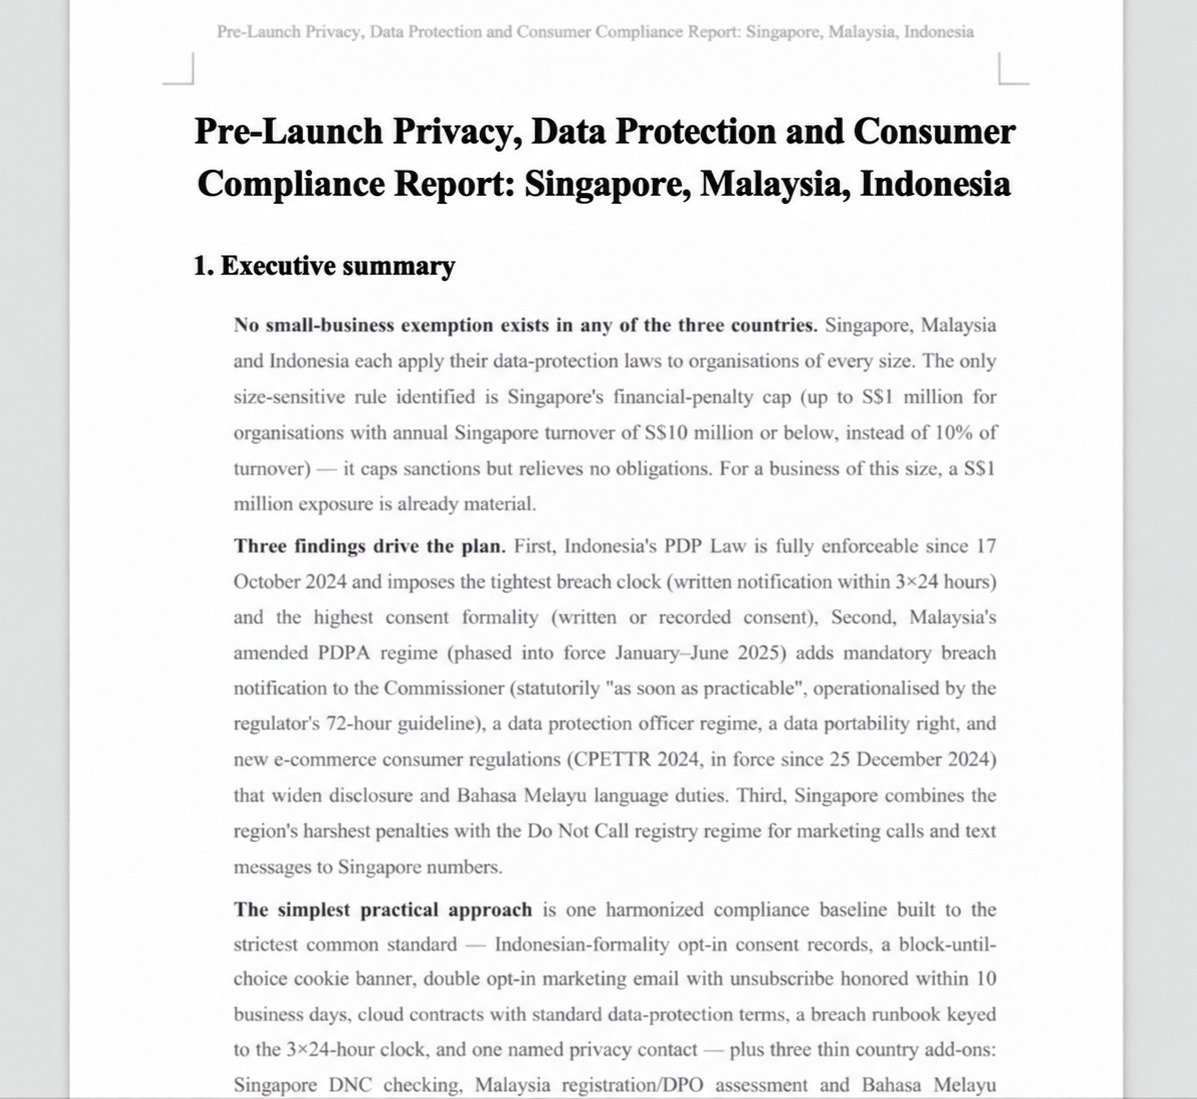
合规研究方面,官方演示是一份面向新加坡、马来西亚和印尼三地的网站上线前隐私合规报告,覆盖数据保护、消费者保护和营销合规等主题,直接给出了可执行的操作建议。中文法律场景也没有缺席,PLawBench 评测包含中文法律咨询、案例分析和文书起草,GLM-Legal 在这套细粒度评分下与前沿系统打成平手。
底座不重,成绩不轻:19.2% 是怎么来的
先看底座。GLM-5.3-Flash 是一个 3200 亿参数的混合专家模型,激活参数约 180 亿,上下文窗口 100 万 token,属于主打性价比的轻量选手。GLM-Legal 在它之上做法律领域的专项训练,模型本身的参数量官方暂未公布。
再说那个 19.2%。Harvey LAB 的评分方式相当苛刻,采用的是「全通过」标准:一道任务里,识别问题点、引用法条、论证站得住、输出格式合规,每个环节都得做对才算通过,错任何一环就是 0 分。在这种规则下,GLM-5.3-Flash 底座自己只有 6.7%,全尺寸的 GLM 5.3 也只有 8.3%,专项训练直接把成绩拉到 19.2%。这个基准覆盖 24 个执业领域的真实律所工作流,考的是端到端交付能力,不是单点问答。
官方称 Harvey LAB 与 LegalBench 的成绩由第三方评测机构 Vals 独立复核,其公布的数字是 19.17%,与官方口径基本一致;LegalBench 上 GLM-Legal 拿到 86.2%,与顶级闭源模型处于同一水平线,法律研究基准则录得 41.83%。不过有几点需要泼点冷水:19.2% 不能读成「法律准确率」,Vals 的细分数据显示 GLM-Legal 的单项标准达成率约 92.5%,但完整通过的任务只有约 19.2%——很多输出满足了大部分要求,却在某个细节上翻了车。另外,官方对比图里 GLM-Legal 领先 Kimi K3、Claude Fable 5、GPT-6 Astra 等模型,但第三方指出榜单上仍有排名更高的闭源模型,各家评测设置也存在差异,具体名次以官方与榜单为准。
法律垂域模型为什么难做:它把模型和「脚手架」一起训了
法律大概是对 AI 最不友好的领域之一。事实、法条、推理和最终交付物之间必须环环相扣,中间断一环,产出的东西就没法用。这也是为什么通用大模型聊法律头头是道,真让它出一份能交给客户的文书就容易露怯——一份合规报告要覆盖所有关键问题和边缘情形,引用经得起查证,格式严格贴合委托要求,下游团队拿来就能用。
Z.ai 的思路是把训练拆成两段。中训练阶段大幅扩充高质量法律语料,让模型在密集的专业语境里吃透法律概念、成文规则和解释框架,把「事实—规则—结论」的演绎链条焊牢。后训练阶段更有意思:在数万个仿真法律环境里做强化学习,而且模型和 Harness——也就是运行时编排框架,负责管理任务上下文、接入工具集、回传执行反馈——是一起迭代进化的。训练中暴露的边缘案例会指向 Harness 的架构瓶颈,Harness 的改进又反过来逼模型适应真实的执行约束,学会检索相关上下文、根据中间执行信号调整节奏。
生产环境的反馈也被直接接进了训练循环。法律从业者按「关键问题有没有全覆盖、论证是否站得住、引用是否可靠、交付物能否直接用」这些硬标准评价产出,这些评价被转成工程损失信号,回流到任务环境、评测规则和 Harness 设计里,进入下一轮训练。说白了,竞争单位已经不是单个模型,而是模型加领域数据加工作流运行时加从业者反馈的组合体,这套方法论对其他高要求垂直领域同样有参考价值。
想用上它还得申请:API 灰度开放,AutoClaw 在路上
GLM-Legal 目前以 beta 形式开放 API,需要提交申请,面向律所、法律科技公司、企业法务团队和独立从业者,申请时要说明机构背景和预期用途。AutoClaw 是 Z.ai 的桌面原生智能体平台,官方表示 GLM-Legal 很快会接入其中,前面提到的合同审查、证据分析、跨境合规三个演示就是按 AutoClaw 的使用方式设计的:模型负责分析,平台负责把结果变成修订痕迹、批注和可核查的报告。
几个大家关心的点官方暂时没有给答案:定价方案没有公布,正式发布日期没有公布,权重是否放出也没有明确说法——有报道称 GLM-Legal 是开放权重阵营在 Harvey 榜单上的最好成绩,但权重开放与否各方口径不一,以官方为准。想尝鲜的团队目前只能先走申请通道,等待灰度放量。
网友怎么看
- 「轻量底座加专项训练能打出这个成绩,说明垂域这条路线真能走通,比无脑堆参数有意思多了。」
- 「0.15 美元一次的任务成本是真香,不过全通过率才 19.2%,关键合同还是得人盯着,先当个不知疲倦的初级助理用。」
- 「对比图里挑着对手比这操作不太厚道,榜单上明明还有更高的,建议大家都去翻第三方排行榜再看宣传图。」
- 「什么时候开放权重?律所的数据敏感性摆在那,不能私有化部署的话,落地肯定要打折扣。」
以上评论仅代表网友个人观点,不代表官方立场。
写在最后
GLM-Legal 的意义不在刷榜,而在它验证了一条路:不用最大的底座,靠领域语料、强化学习和模型与运行时框架的协同进化,也能在专业场景里做出能打的东西。19.2% 的全通过率意味着它十次里还有八次交不出完整作业,离独当一面还很远,但作为法律团队的初稿引擎和核查助手,已经够格进试用清单了。
真正的考验在接入之后:律所和法务团队拿真实案件一跑,成色如何很快会见分晓。权重放不放、定价怎么定、AutoClaw 何时全面接入,这几个问题的答案,会决定它是一篇博客里的漂亮数字,还是法律行业工作流里的一件趁手工具。
