一次四款,英伟达把 Cosmos 3 世界模型摆上了开源货架
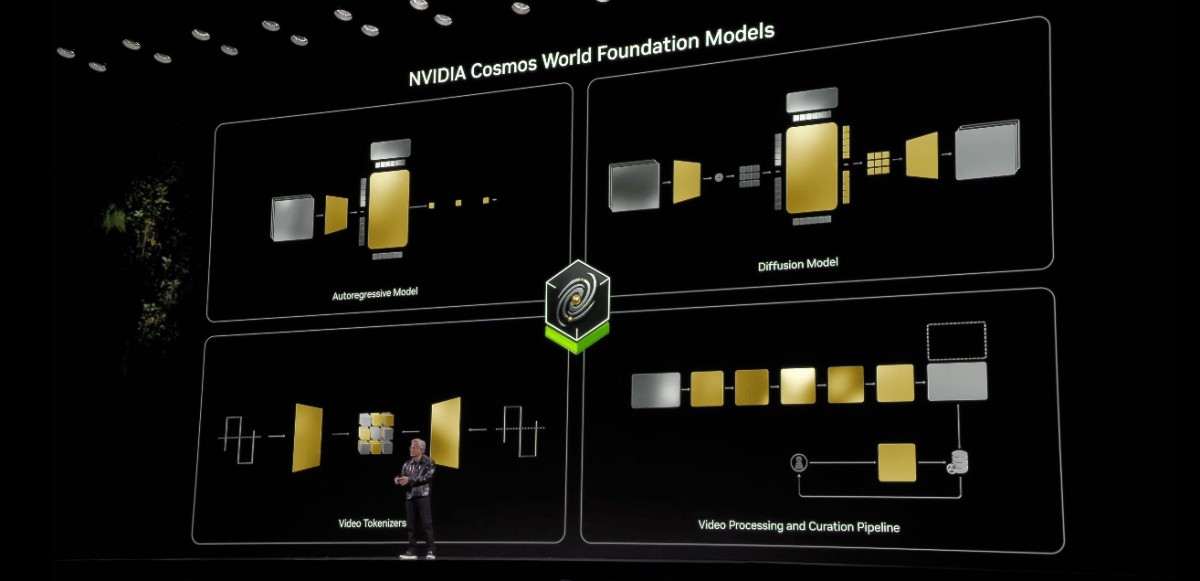
11 月 5 日,英伟达在 Hugging Face 上一次性放出四款 Cosmos 3 开放权重模型:Cosmos3-Nano-Transfer-Auto、Cosmos3-Nano-Sim-Auto、Cosmos3-Nano-Sim-Transfer 和 Cosmos3-Nano-Sim-Bimanual。四款全部基于 Cosmos 3 Nano 后训练而来,每个都有 160 亿可训练参数,挂在 OpenMDW1.1 许可下——商用和非商用都在允许范围里,想拿去做产品也不用先过法务那一关。
这次发布其实分了两步。11 月 2 日,英伟达先在技术博客里给足了铺垫:Cosmos 框架的适用范围从 Cosmos 3 本身扩展到 Alpamayo、GR00T、Qwen、pi0.5 等兼容模型,还加入了 DPO、GRPO、PPO 三条强化学习管线,以及用来部署的 Cosmos NIM 容器。11 月 5 日四个 checkpoint 上线,当天官方还开了 Cosmos Labs 直播,当场演示这些模型怎么用。Cosmos 是英伟达面向物理 AI 的世界基础模型平台,训练、优化、推理的全流程工具都塞在里面,这次等于把货架直接搬到了开源社区门口。
驾驶这条线:11 路相机加 LiDAR 同步生成,合成数据自己造
前两款模型对准自动驾驶。Transfer-Auto 干的是离线合成驾驶数据的活:一次能生成最多 11 个相机视角(包括鱼眼)的同步视频,外加 LiDAR 点云。路面布局、车流行为靠每路相机的世界场景图(World Scenario Map)控制,画面外观用文本提示调。输入输出都支持 30 fps,单段最多 400 帧,分辨率 480p 或 720p,想要更长的序列就靠自回归分块接着拼。
Sim-Auto 是 Transfer-Auto 的因果蒸馏流式版本,把每一小块同步视频和点云压缩到几步去噪就出结果。配上仿真运行时和场景图渲染器,驾驶策略的每个动作都能实时喂回场景,跑长程交互式 rollout,做闭环评测。以前这类多传感器同步生成能力基本锁在少数几个封闭体系里,现在你租几张卡就能自己跑。
为什么非要「同步」?自动驾驶模型吃的数据里,相机画面和 LiDAR 点云得逐帧对齐,真车采集时标定误差、传感器时延都会带来错位,回头清洗数据能磨掉团队半条命。生成式路线直接在源头保证对齐,路况想重来就重来,这在以前是想都不敢想的奢侈事。
机器人这条线:仿真器控制信号一键变照片级视频
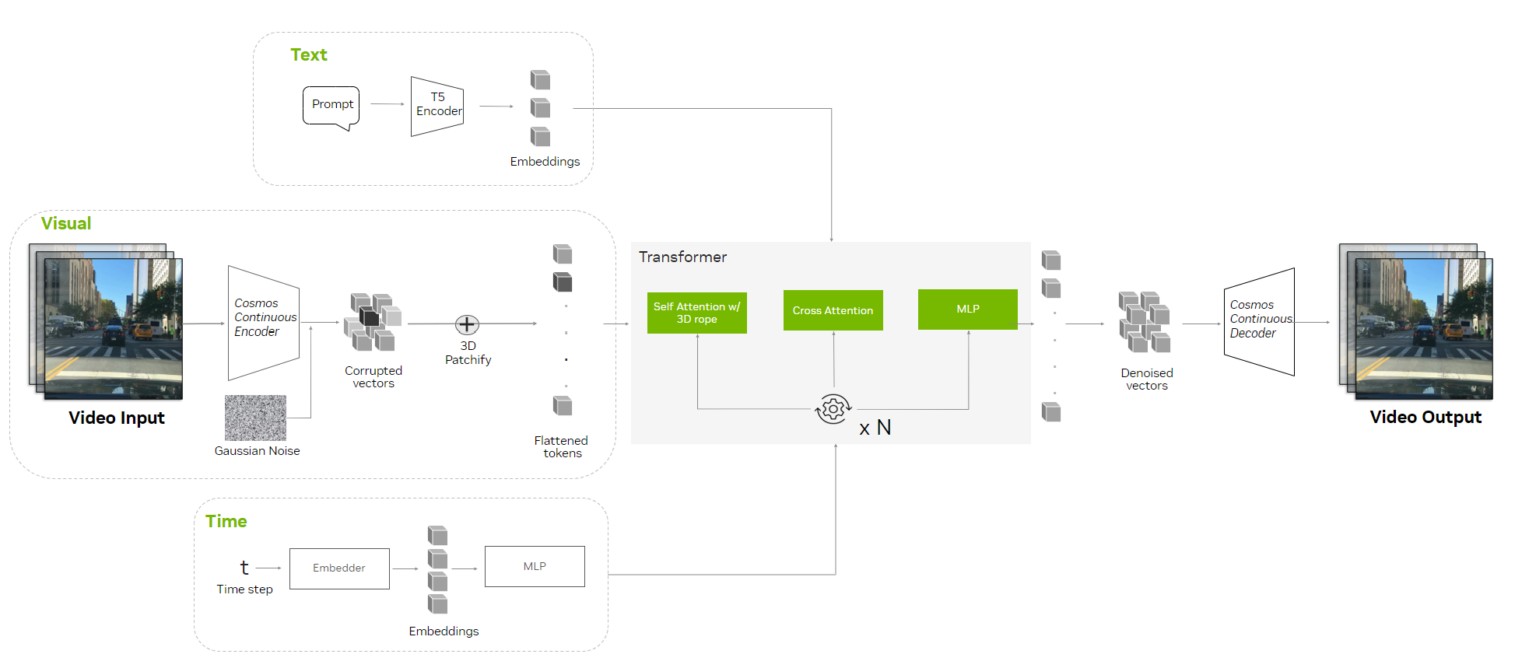
另外两款对准机器人。Sim-Transfer 干的事情很直观:把物理仿真器的控制信号加一段文本提示,直接变成照片级的 RGB 视频。深度、分割、边缘、模糊四种空间控制把物理状态牢牢锁在仿真器里,外观细节交给文本描述。策略可以直接消费生成的帧,不用再忍受传统仿真画面那股「塑料感」。
Sim-Bimanual 则从双臂机器人或相机的动作序列预测下一帧视频,支持 YAM 和 AgiBot 两种本体,既能让策略接管,也能让人用摇杆手柄操作。一套控制序列可以在视角切换和物体操作之间自由切,混合动作示例用了 59 个控制值,训练时补零到 64。技术报告的演示数据里,单张 GB300 跑 480p 能到 48.1 fps,延迟 166 ms——这个数字对应的硬件配置不低,看看就好。
架构上,四款模型共用一个 Mixture-of-Transformers 骨干,用注意力机制把文本处理网络和视觉生成网络连起来。训练走四段式配方:双向适配、教师强制、一致性蒸馏(每个分块四步去噪)、自强制——最后一段让模型在自己生成的历史帧上继续练,拖慢误差累积的速度。后训练配方随推理权重一起放出,你可以照着把模型适配到自己的传感器布局和机器人本体上。官方博客还提到手术仿真方向的 Cosmos3-H-Embodied-Nano,以及做实时闭环的蒸馏版 Cosmos3-H-Dreams,可见这条路他们打算一直铺下去。
同期的 VFlash:不再逐 token,轨迹和 3D 运动并行出
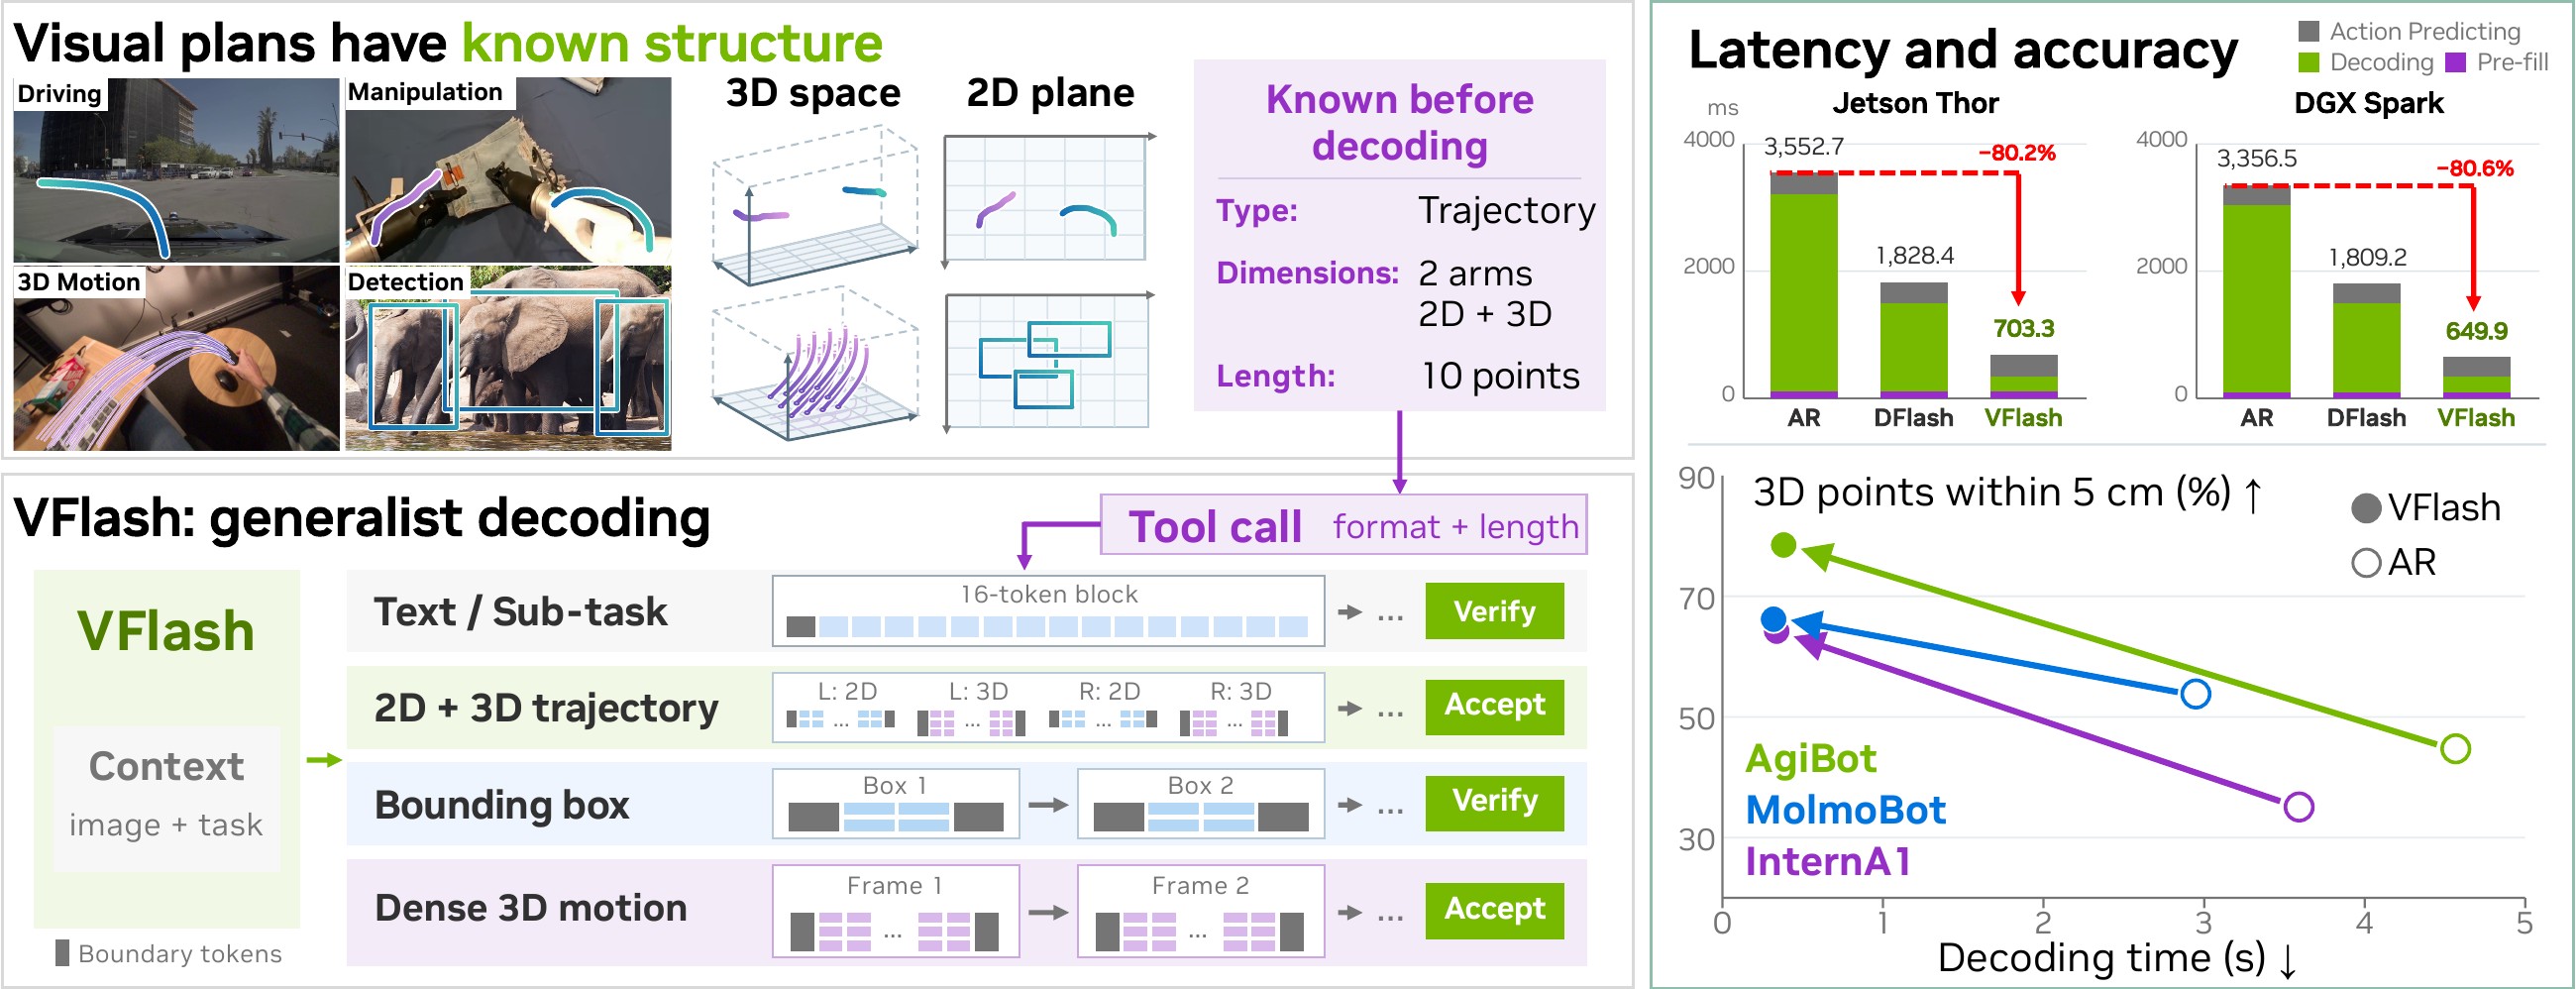
跟 Cosmos 3 同期亮相的还有英伟达的视觉模型 VFlash。它的特别之处在于生成方式:机器人轨迹、3D 运动预测这类几何输出是并行生成的,而不是像常规视觉语言模型那样一个 token 接一个 token 地往外蹦。官方技术页的对比图显示,在 Jetson Thor 这类硬件上,解码延迟较自回归方式降了约八成,3D 点预测精度也更高。
对机器人来说,这个差别很实际。策略每一步都要等模型出结果,推理慢一拍,动作就跟不上。把「生成」从串行改成并行,等于把实时闭环控制的大门推开了一条缝。它和 Cosmos 3 一快一慢凑成一套组合:一个负责造世界,一个负责快速出动作。
从官方技术页的图解看,VFlash 的输出覆盖面不小:给一张场景图加任务描述,它能并行给出文本子任务、二维和三维轨迹、边界框、稠密三维运动,每种输出走各自的校验通道。换句话说,它不是只会画轨迹的单面手,更像是给机器人准备的通用几何输出解码器。
谁能吃到红利:门槛降了,活儿也换了
直接受益的是具身智能团队。做操作、导航、人形机器人的公司,最头疼的就是缺大量多样的标注交互数据——真机采集贵,手搭仿真场景脆。现在一个免费的基础模型摆在面前,仿真 rollout 的生成从「找供应商谈采购」变成了「自己租 GPU 跑任务」,权重可以跟训练配置一起做版本管理,环境分布想怎么改就怎么改。
行业层面的影响更微妙。如果免费基础模型就能产出可用的 rollout 数据,护城河就从数据生成挪到了评测、数据清洗和策略微调——生成数据的边际成本降得比判断数据有没有用的成本快得多,瓶颈在往后挪。传统仿真厂商的低端市场会感受到价格压力,但高保真物理和经过认证的环境依然有壁垒。照这个节奏,接下来两个季度大概率会冒出一批基于这套权重微调的垂直世界模型。
不过先别急着 All in。目前还没有第三方独立测过这批权重的视觉质量,英伟达也没放出评测代码和误差区间,演示数字都对应特定硬件配置。运行门槛也不低:系统要 Linux,配 NVIDIA GPU,走 Docker 和 Container Toolkit,显存 BF16 下要 58 GiB,FP8 下 44 GiB,FP8 加上权重卸载也要 31 GiB。Hugging Face 官方博客自己也承认,这些模型到底能在多大程度上忠实支撑策略学习与评测,还得慢慢量。
网友评论
- 「11 路相机加 LiDAR 同步生成太实用了,以前采一套多传感器数据预算直接爆掉,这下能自己造了。」
- 「开口就是 58GB 显存起步,我这张 4090 看了一眼默默划走,开源是开源了,跟我没关系。」
- 「权重和训练配方一起放这点良心,就等有人复现,看看合成数据到底能不能真拿来训车。」
- 「sim-to-real 那道坎还在吧?仿真里跑得再漂亮,上了真车不认账的例子还少吗。」
总结
这次英伟达的开源不是发一个模型做做样子,而是把驾驶合成数据和机器人双臂仿真两条产品线一起端上桌:四款 16B 开放权重、商用友好的 OpenMDW1.1 许可、随权重放出的后训练配方,再加上并行生成的 VFlash,物理 AI 工具箱的完成度肉眼可见地高了一截。真正的胜负手不在发布当天,而在接下来几个月——社区拿这些权重能不能训出可用的策略、sim-to-real 的账最终怎么算,以官方后续评测和社区复现结果为准。对关注物理 AI 的开发者来说,眼下最划算的动作是把它跑起来,用自己的场景压一压,比看任何演示都实在。
