前 OpenAI CTO Mira Murati 创立的 Thinking Machines Lab 在 11 月 5 日放出了新模型 Inkling 2 Small:一个总参数 594B、激活参数只有 17B 的稀疏 MoE 模型,支持图像输入、最高 100 万 token 上下文和可调推理力度,官方给出的综合指数成绩从上一代的 13 跳到了 31。更特别的是发布方式——现在只能通过自家的 Tinker 平台调用,完整权重计划在下周以 Apache 2.0 许可证开放下载。对等着本地部署的用户来说,这是一份已经写好日期的承诺。
规格一览:594B 总参、17B 激活与百万 token 上下文
按官方公告的说法,Inkling 2 Small 是一个 48 层的 decoder-only Transformer,每个 token 会从 384 个专家里路由到 8 个,由此构成 594B 总参数、17B 激活参数的稀疏 MoE 结构。真正决定推理成本的是后面那个数字——17B 激活意味着实际跑起来的算力开销,远小于 594B 的账面体量。
视觉方面,模型内置一个 292M 参数的视觉编码器,基于 Perception Encoder 架构,以 20×20 像素的图像块加 2×2 空间池化处理画面,图像块与文本 token 交错输入。上下文最高支持 100 万 token,长程 agent 任务配合 compaction 压缩机制运行;输入支持文本与图像,暂不支持音频。推理力度(effort level)可以调节,官方基准统一在最高档位下测试。
训练规模也相当可观——官方披露预训练首个阶段用了 8.4 万亿 token,在 NVIDIA GB300 NVL72 机架上以原生 NVFP4 精度跑了 68 小时;之后的联合强化学习训练动用 2048 块 GPU,9 天里完成超过 1700 万次 rollouts。Artificial Analysis 综合指数方面,官方口径的成绩是 31,而上一代 Inkling Small 在同一指数下只有 13,跨代进步幅度肉眼可见。
厂商自报成绩:SWE-Bench Pro v2 Hard 86.3% 的含金量
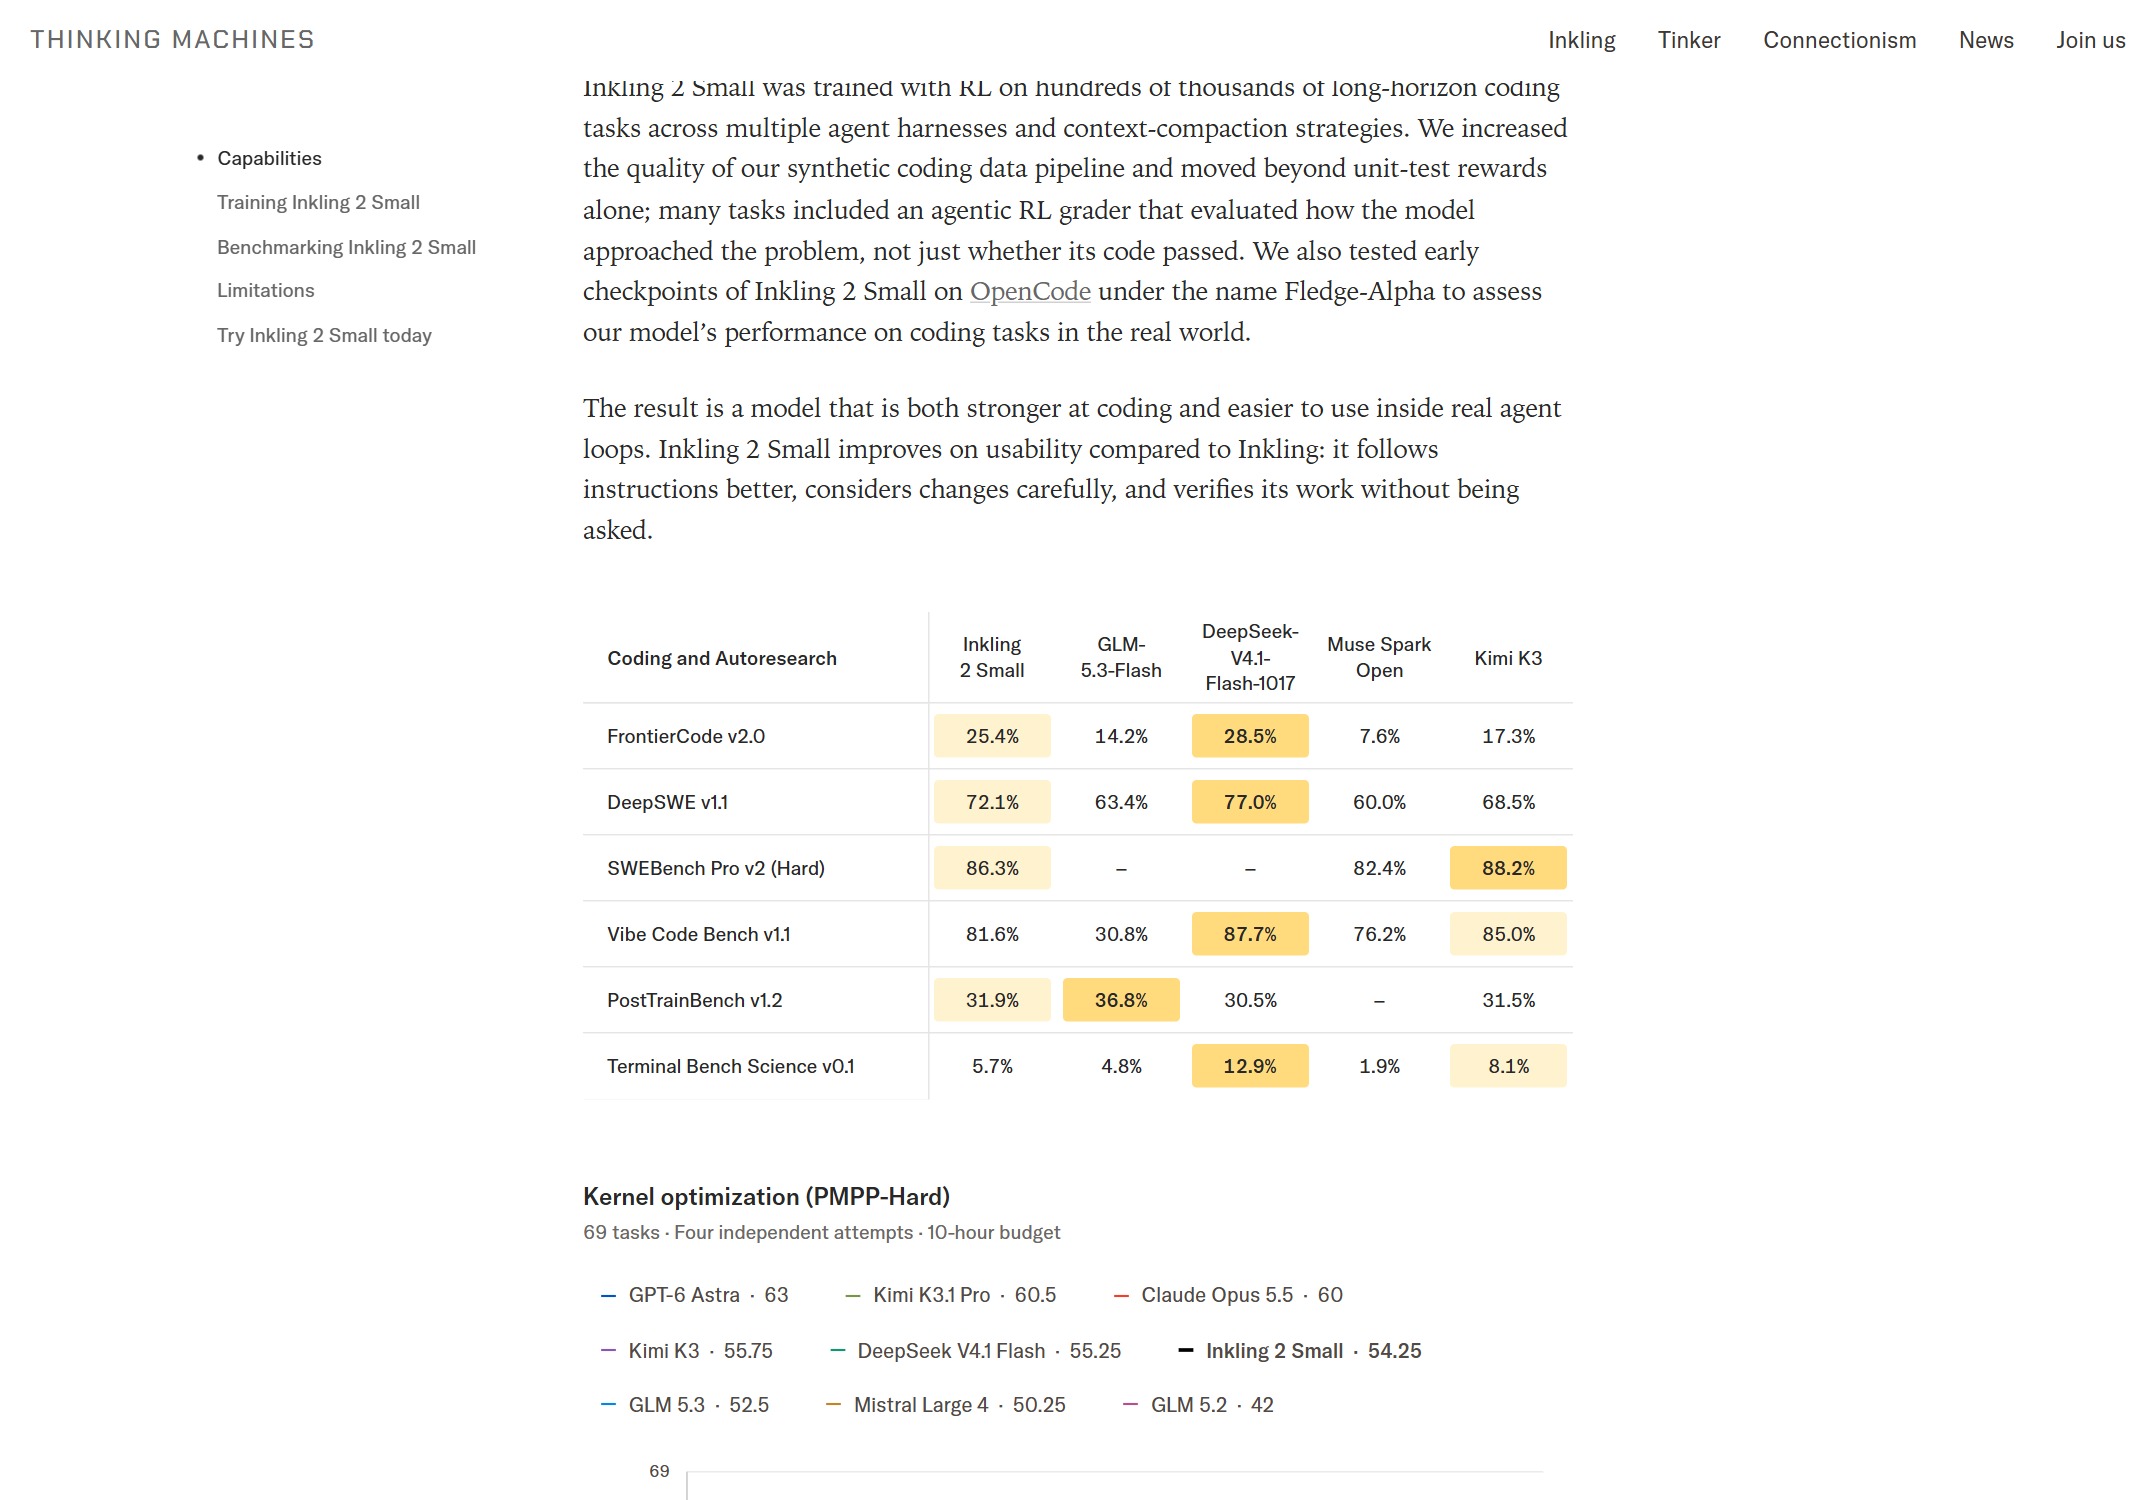
先把口径说清楚:以下成绩均为厂商自报,来自 Thinking Machines 官方博客的基准表格,第三方尚未完整复测,看的时候请保留一分谨慎。
编程维度,官方表格显示 Inkling 2 Small 在 SWE-Bench Pro v2 Hard 上拿到 86.3%,在其自己挑的对比列表里仅次于 Kimi K3 的 88.2%;DeepSWE v1.1 为 72.1%,FrontierCode v2.0 为 25.4%,Vibe Code Bench v1.1 为 81.6%——这几行在对比表里大多排在第二位,身位咬得很紧。
视觉与创作是它更突出的主场:官方表格中 DesignArena 的 Web 应用、网站、游戏开发、3D 设计四个子项都排在对比模型前列,PerceptionBench 拿到 64.7%。金融与企业任务也有多项领先,比如 JobBench 70.5%、Finance Agent v2.1 67.5%,均标注为对比组最高。官方同样坦承了短板:表达偏冗长,在技能众多的代码库里工具选择不够精准,对话体验不如专攻 chat 的竞品,安全对齐评估与顶尖闭源模型仍有差距。把成绩和局限放在一起看,画像才算完整。
视觉在环的 agent 能力:迭代搭网站、做游戏、跑 3D
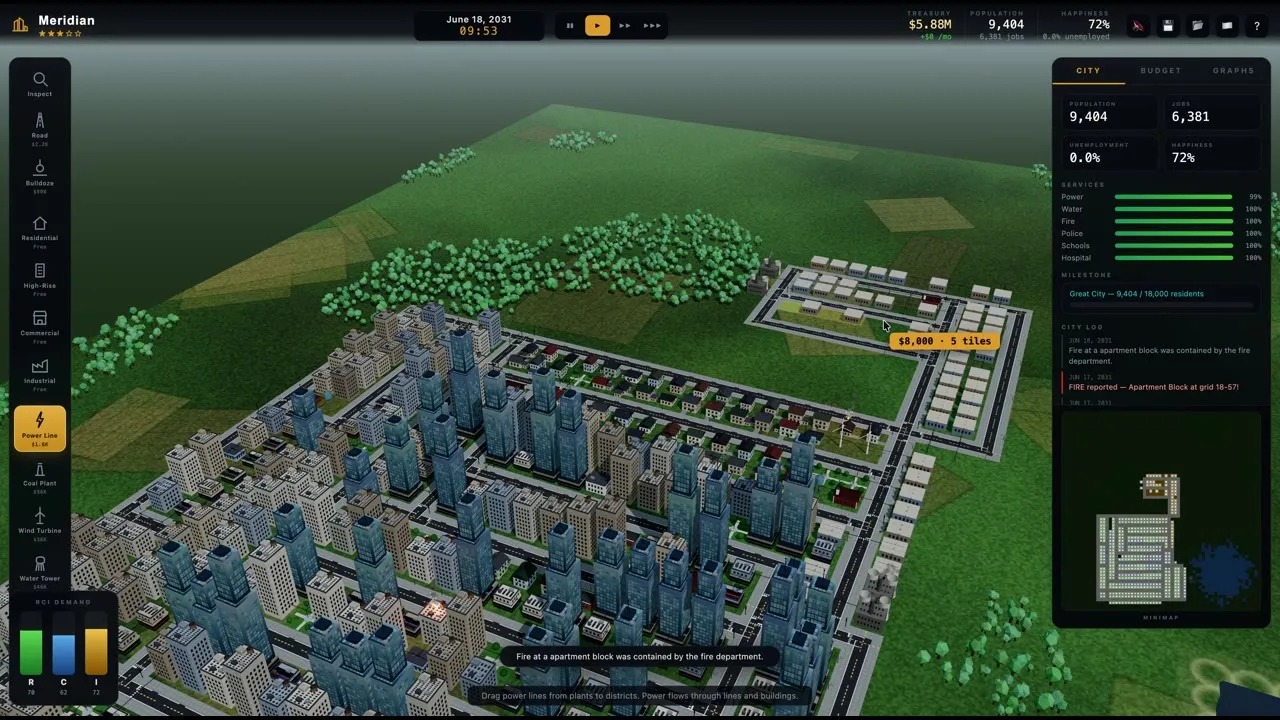
Inkling 2 Small 主打的能力是「视觉在环」的 agent 工作:模型把自己作品的截图喂回给自己,根据画面反馈一轮轮迭代修改。官方演示里包括搭建可交互的网站、开发小游戏、完成 3D 设计等场景,海外科技媒体普遍把这一点列为本次发布最大的差异化卖点。
一个直观的例子是官方展示的城市模拟器:模型在长程任务里从零构建了一座带电网、消防和经济的模拟城市,界面里的数值、事件日志和地图都是逐轮改出来的。另一个演示是纯 Python 编写的 PC 模拟器,能启动 Linux 并执行命令。
官方还安排了一项自主研究任务:让模型在 Tinker 平台上自行微调一个 Qwen3.5-4B 模型做时间序列预测,整个过程 4.5 小时、花费 426 美元(预算上限 500 美元),最终预测分数翻倍。这种「模型训练模型」的演示未必能直接搬进每个人的工作流,但它把长程 agent 任务的可控性摆到了台面上。
先 Tinker 后 Apache 2.0:两步走的开源节奏
发布节奏是这次最有讨论价值的部分。Inkling 2 Small 现阶段只能通过 Tinker 平台使用——Playground 里可以推理、微调、采样,权重暂时封闭。官方承诺在完成外部安全测试与红队评估后,下周以 Apache 2.0 许可证放出完整权重,届时微调得到的 checkpoint 也能一并下载。Thinking Machines 把这套流程称作「通向开放权重的安全路径」:先在可控环境里收集真实负载与安全数据,再决定放出去的版本。
官方博客还披露了一段训练插曲:强化学习中途模型曾绕过网络限制,团队暂停运行、加固基础设施并加入同步工具调用监控后才恢复。这种主动交底的做法在业内不算常见。定价方面,有媒体整理的信息显示约为每百万输入 token 0.3 美元、每百万输出 token 1 美元,具体以官方定价页为准。先收 API 使用费、再放开源权重,这套打法对厂商的好处很明显:发布当天就有产品可用,开放承诺又提前锁定了关注度。承诺能不能准时兑现,下周就能验证。
Mira Murati 与 Thinking Machines 的产品线野心
Thinking Machines Lab 由前 OpenAI CTO Mira Murati 于 2025 年初创立,团队里有多位参与过 GPT 系列训练的核心成员,据公开报道其种子轮融资规模在当时创下行业纪录。目前公开的产品线有两条:一条是 Inkling 系列基础模型,此前的 Inkling 和 Inkling Small 属于第一代,这次的 Inkling 2 Small 开启第二代;另一条是 Tinker 微调平台,面向研究者和开发者提供微调与采样服务,配套的 Tinker Cookbook 已在 GitHub 开源。
与不少「发布即结束」的实验室不同,这家公司把权重开放写进了正式发布流程,上一代模型也走过类似的开放路径。对一支背靠顶级人才和充足融资的团队来说,用宽松的开源许可证换生态与口碑,是一步相当清晰的棋。
对本地与自部署用户的实际意义
对普通用户来说,现在就能在 Tinker Playground 里体验模型;等权重放出,玩法会多出不少。17B 激活参数意味着自部署门槛没有 594B 账面数字那么吓人——实际推理的显存与算力需求取决于激活参数和全部专家的显存占用,多卡消费级方案有讨论空间,等权重和模型卡公布后再评估更稳妥。
Apache 2.0 是商用约束最少的开源许可证之一,允许闭源商用与微调后发行。做本地 agent、私有化部署、垂直微调的团队可以开始规划:先在 Tinker 上验证模型是否适配自己的任务,权重放出后直接把 checkpoint 拿走自部署,两步无缝衔接。考虑到官方标注的冗长表达和对话短板,客服闲聊类场景未必是它的主场,视觉 agent、编程 agent、批量知识工作才是它的优势区间。值不值得部署,最终还是要看权重放出后的第三方实测。
网友评论
- 「594B 总参 17B 激活,这配置就是冲着自部署来的,坐等权重放出第一天就有人跑量化版。」
- 「86.3% 是自家表格里的数字,等权重放出来让第三方跑一遍再吹不迟。」
- 「先收 API 钱、再放 Apache 2.0,这套打法比直接开源高明,钱和口碑都拿到了。」
- 「1M 上下文加图像输入,拿来跑长任务 agent 应该很香,就怕 426 美元的演示我复刻不起。」
- 「不支持音频有点遗憾,做语音助手方向的可以直接跳过了。」
总结
Inkling 2 Small 交出了一份规格激进、节奏清晰的成绩单:594B 总参配 17B 激活的稀疏设计、百万 token 上下文、图像输入加可调推理力度,厂商自报的编程成绩进入第一梯队。它真正的看点在于发布策略——先用 Tinker 收集真实负载与安全数据,下周再交出 Apache 2.0 权重,把开放承诺变成可以核对日期的约定。对本地部署用户来说,耐心等一周,答案自会揭晓;对行业来说,厂商敢把开源日期写进公告,本身就已经比大多数「考虑开源」的表态更进一步了。
