10 月 24 日发布时许下的承诺,这个月真的交了出来。11 月 5 日凌晨,月之暗面在 Hugging Face 平台放出了 Kimi K3.1 Pro 的完整模型权重,英伟达 AI 官方账号第一时间公开发文祝贺。对普通开发者和企业来说,这意味着从「只能调 API」到「可以自己下载、部署、微调」的转变。这份 2.8 万亿参数的权重包成色如何、值不值得折腾,我们按成绩、规格、门槛三块拆开来看。
权重如约放出,开源榜一夜易主
权重开放同日,Arena 旗下 Agent Arena 智能体排行榜的数据也对外披露:Kimi K3.1 Pro(Max)排在开放权重模型第一位,在全部参评模型中位列第 13,工作、编程和聊天三个类别均居开放模型第一。这份榜单基于全球用户超过 1.75 万次真实、长周期的智能体任务会话,K3.1 Pro 的净改进率达到 +5.1%,比上一代 K3(Max)的 +0.9% 高出 4.2 个百分点。
和常见的成对盲测不同,Agent Arena 不要求用户给两个回答投票,而是直接从真实用户的智能体会话里提取信号:任务有没有被明确确认、收到的是表扬还是投诉、用户下了多少纠正指令、Shell 命令报了多少错,再通过官方称为「因果追踪」的随机化推断方法,估算各模型相对平均水平的净改进率。实际用下来什么样,比实验室跑分更接近真实体验,这也是这份榜单最近被频繁引用的原因。
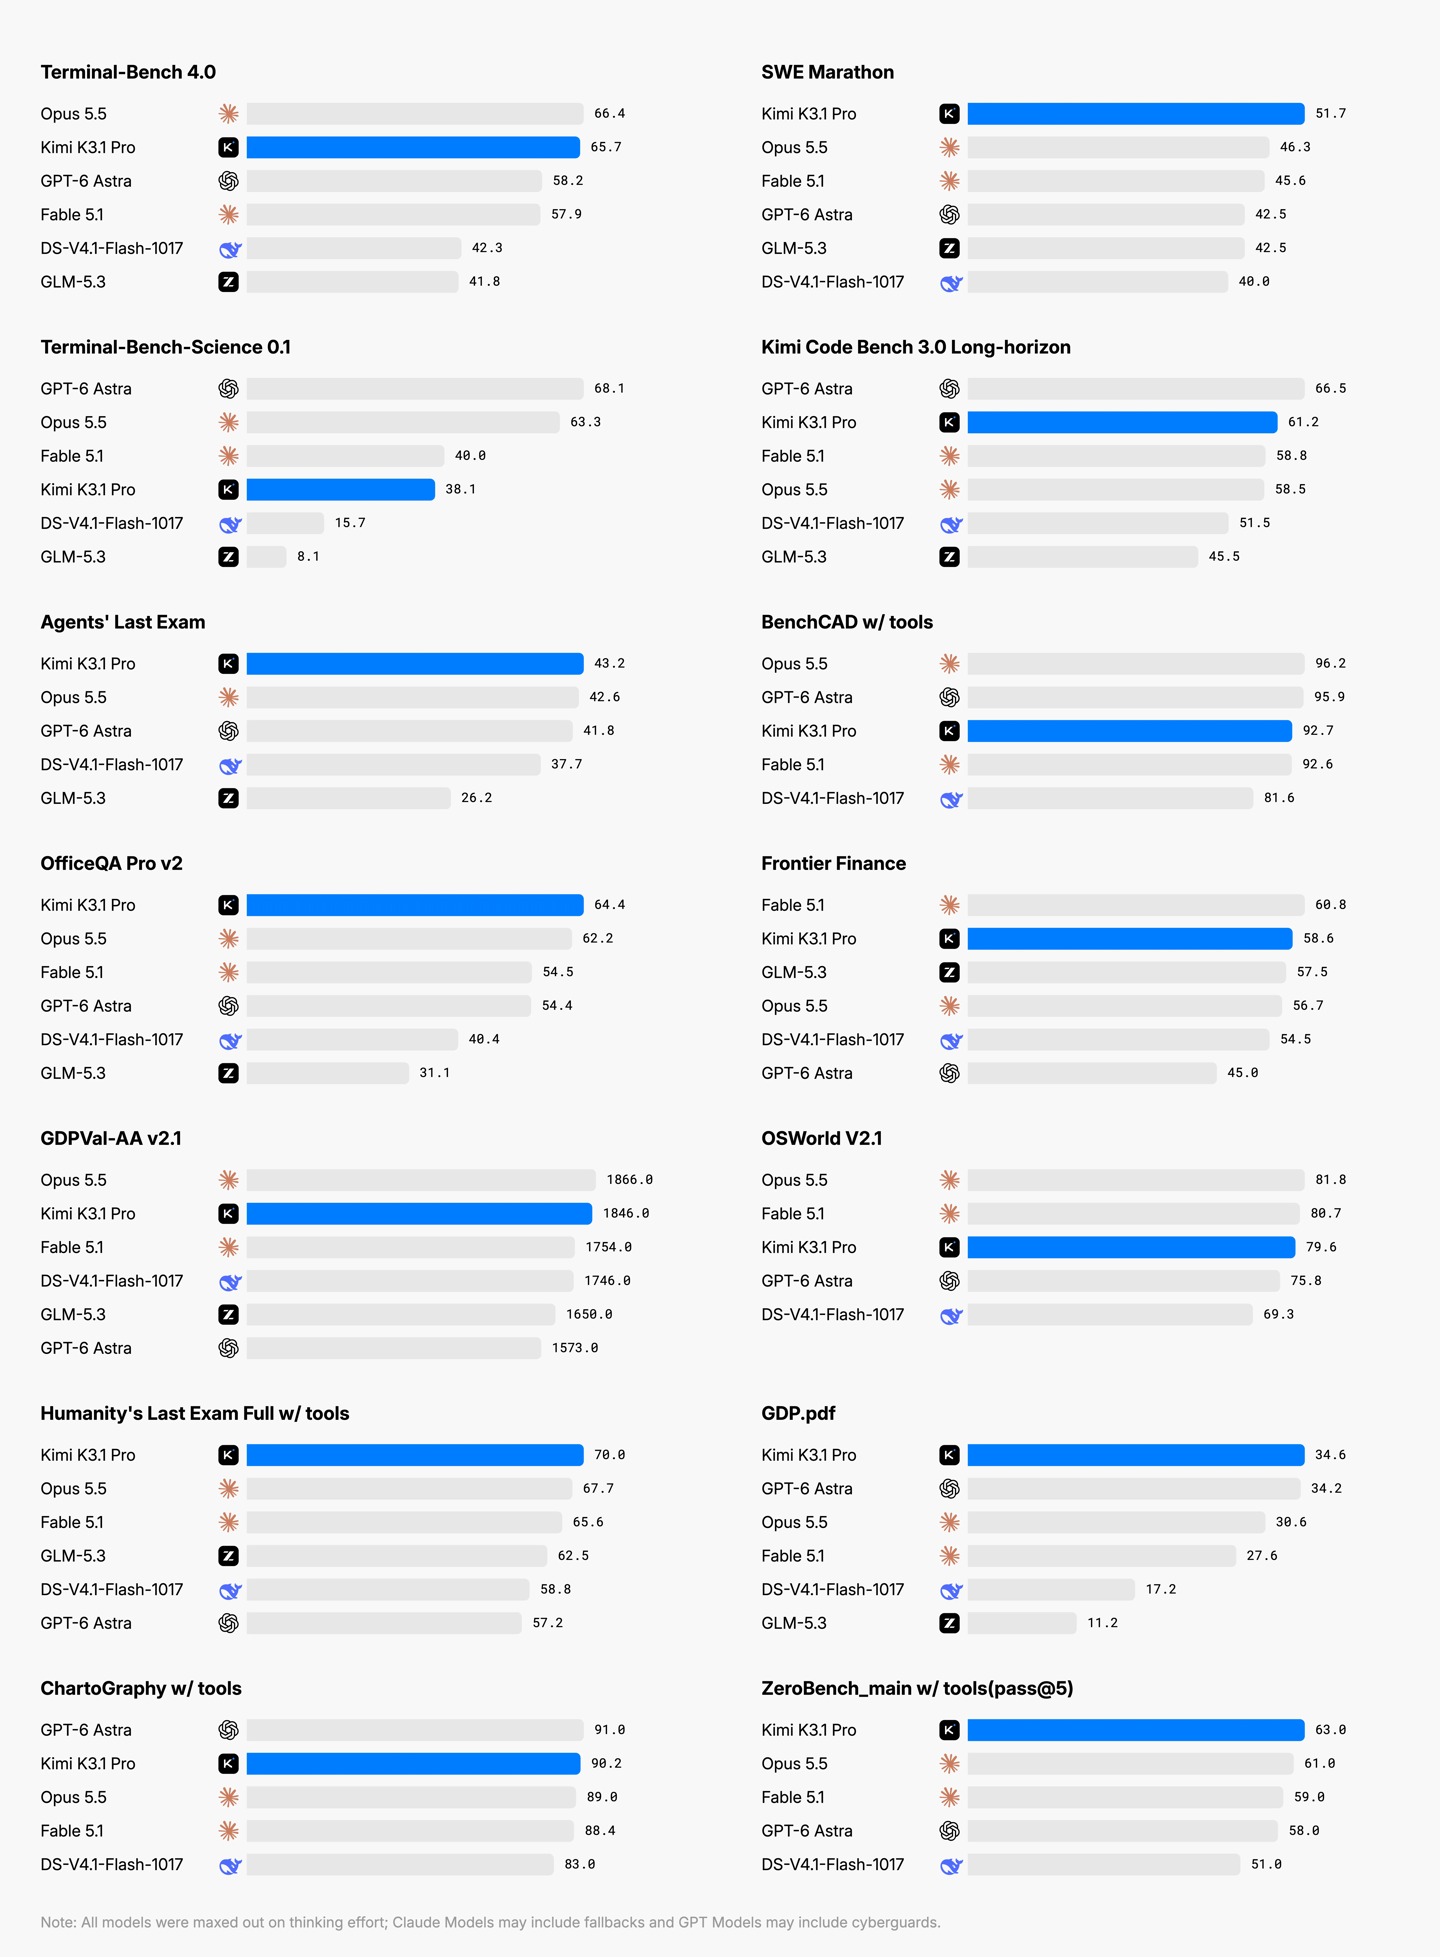
跑分不虚:编程智能体测试逼近最强闭源
在终端智能体基准 Terminal-Bench 4.0 上,K3.1 Pro 拿到 65.7%,高于 GPT-6 Astra 的 58.2%,与 Claude Opus 5.5 的 66.4% 相差不到 1 个百分点。对普通用户来说,这一个百分点的差距基本感知不到,但价格差距相当明显:在 Kimi 开放平台,K3.1 Pro 输入每百万 token 13 元、缓存命中 1.3 元、输出 68 元,整体定价约为 GPT-6 Astra 的五分之一。
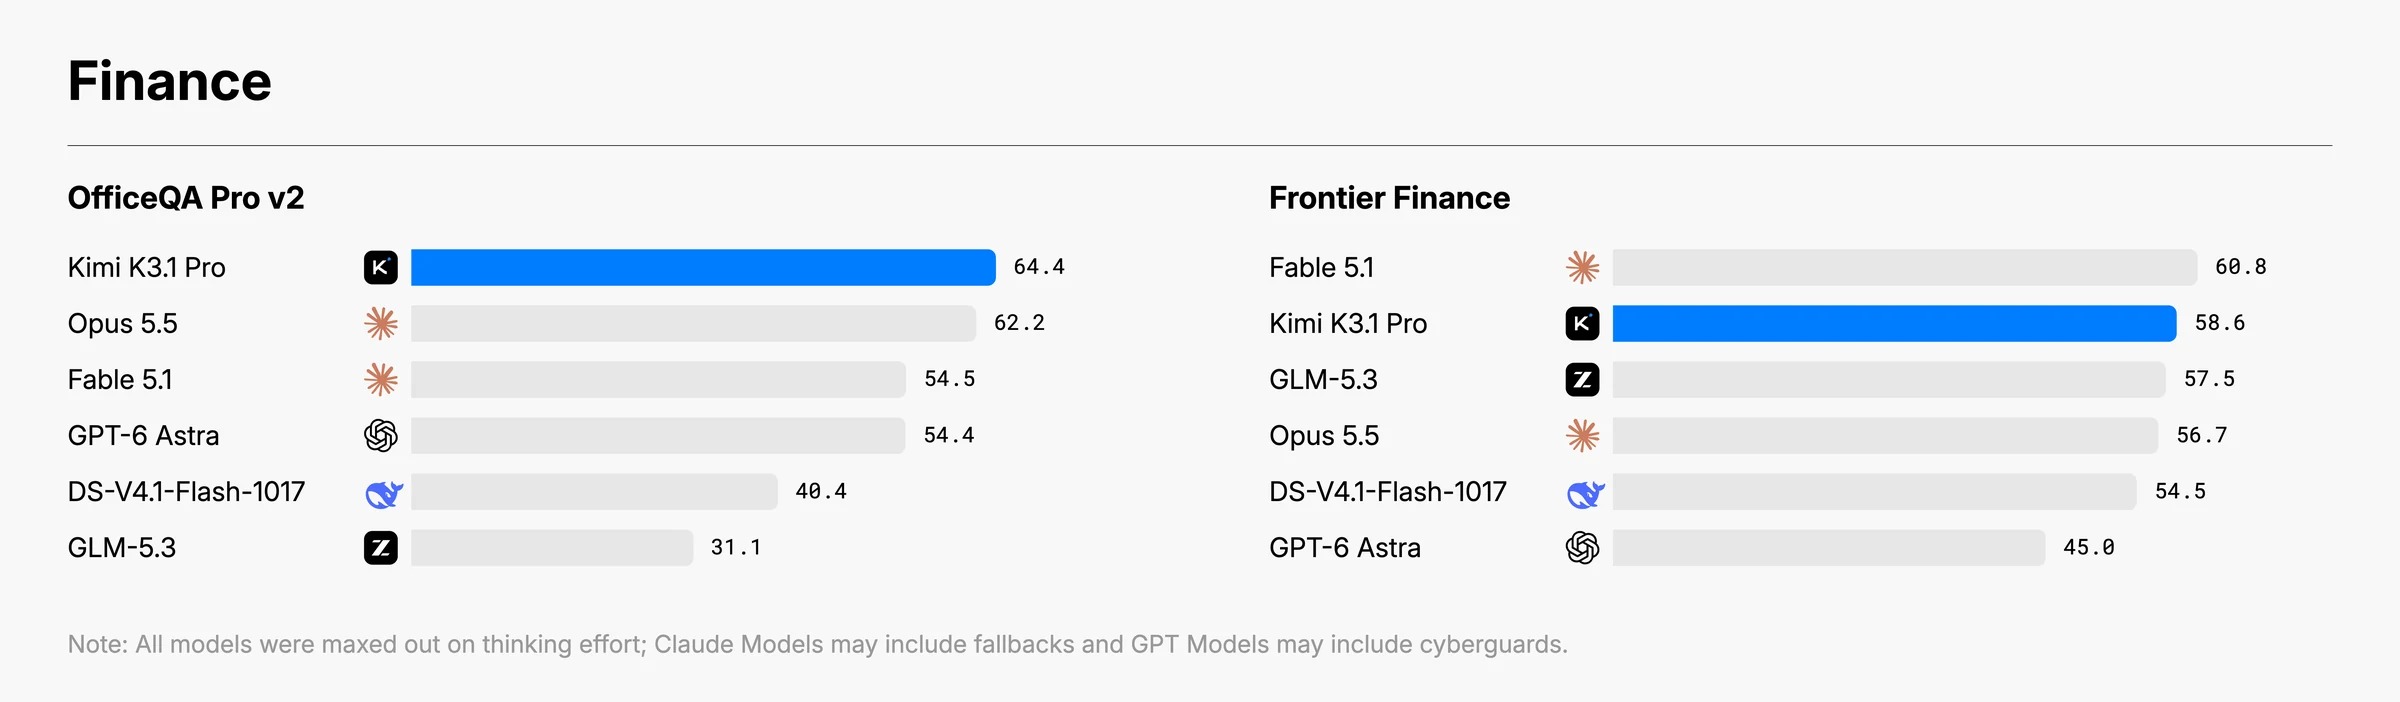
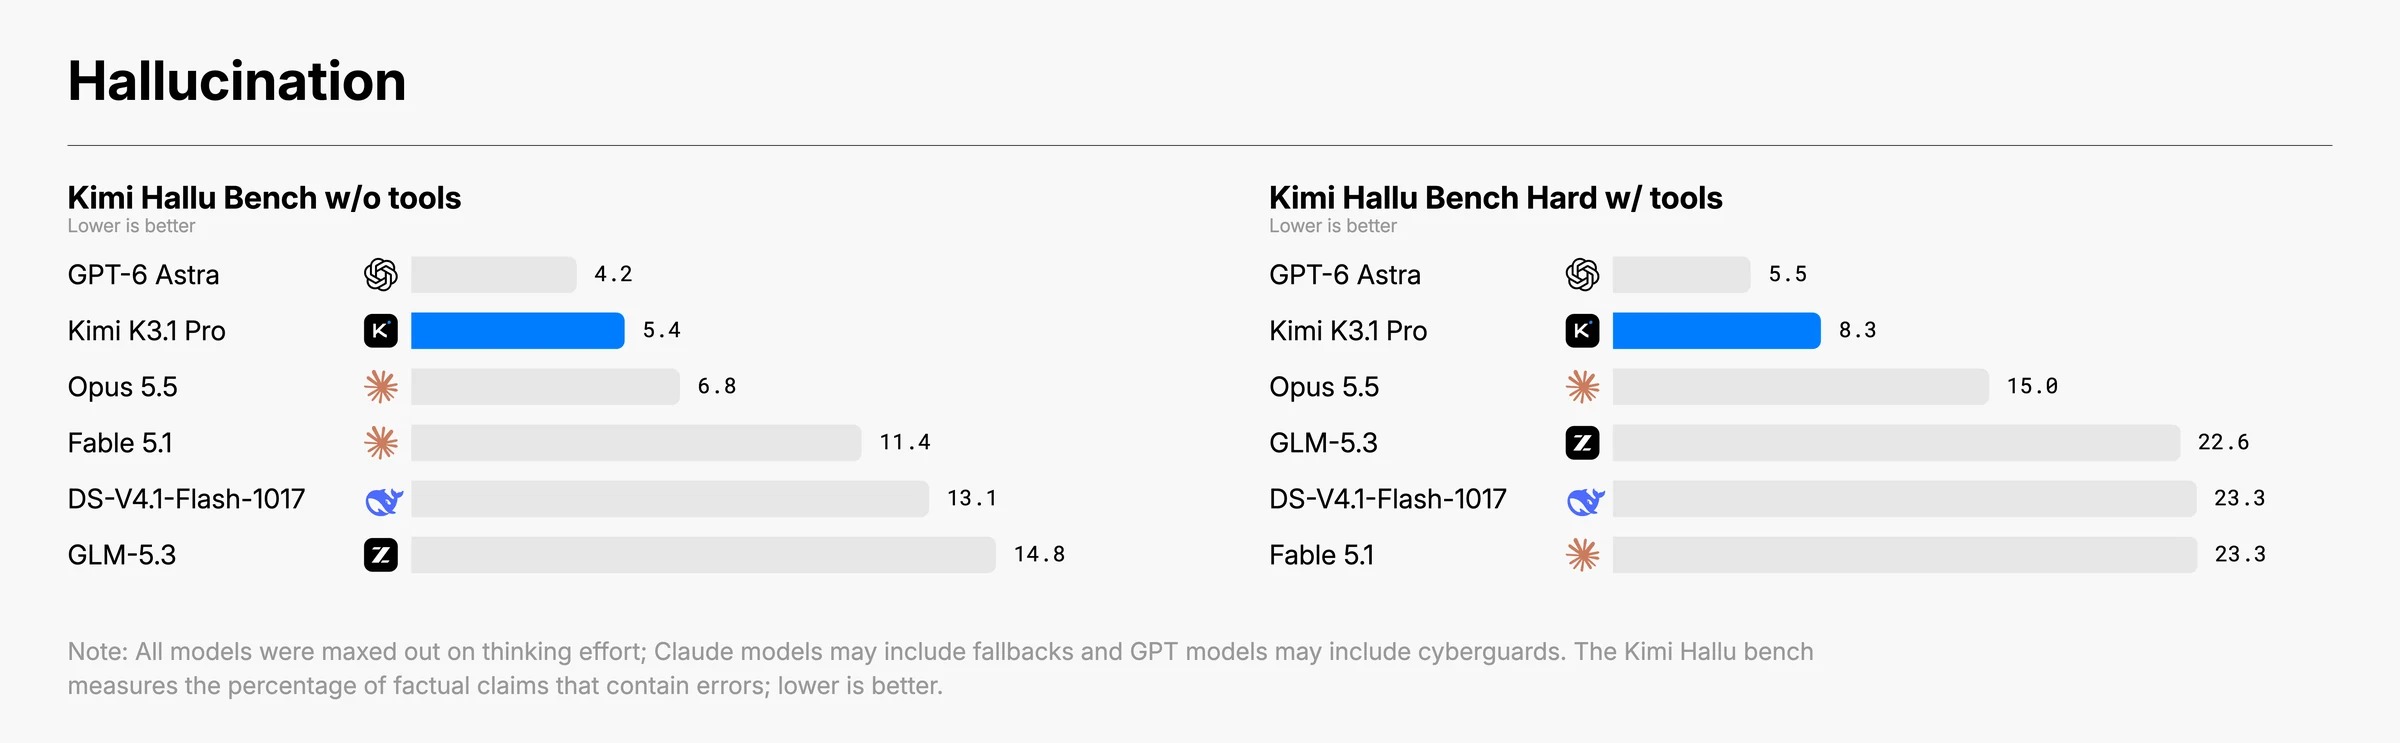
从官方随权重发布的模型卡看,六款模型横向对标的成绩单里,长板集中在编程和文档处理:编程智能体测试 SWE Marathon v1.1 得分 51.7,六款参评模型第一;金融文档测试 OfficeQA Pro v2 得分 64.4,同样领先;检索测试 BrowseComp 拿到 92.1。幻觉控制的进步也写在数据里,Kimi HalluBench Hard 加压测试错误率 8.3%,上一代 K3 是 23.4%。
规格一览:2.8 万亿参数怎么用得起来
- 架构:混合专家(MoE)设计,总参数 2.8 万亿,共 896 个专家,单次推理仅激活 16 个,另设 2 个共享专家,激活参数约 1040 亿,占总规模约 3.7%
- 上下文:约 100 万 token,93 层网络中 69 层采用 KDA(KimiDeltaAttention),24 层替换为门控稀疏注意力层,专门压低长上下文建模开销
- 多模态:原生支持视觉理解,视觉编码器 MoonViT-V2 参数量 4.01 亿
- 出身:不是从零训练的新基座,而是以 K3 为底座、覆盖数百个下游领域的大规模联合强化学习后训练版本,权重格式与推理工具链和 K3 兼容
- 量化:权重 MXFP4、激活 MXFP8,量化感知训练在训练阶段就完成校准
这套设计的思路不难理解:总参数决定脑子里装了多少东西,激活参数决定每次推理烧多少算力,注意力层的改造则专治百万 token 长文本的缓存开销。已经跑通过 K3 的团队迁移成本不高,这也是月之暗面敢继续放大参数规模的底气。
长板与短板:金融很强,科研仍弱,攻防被裁剪
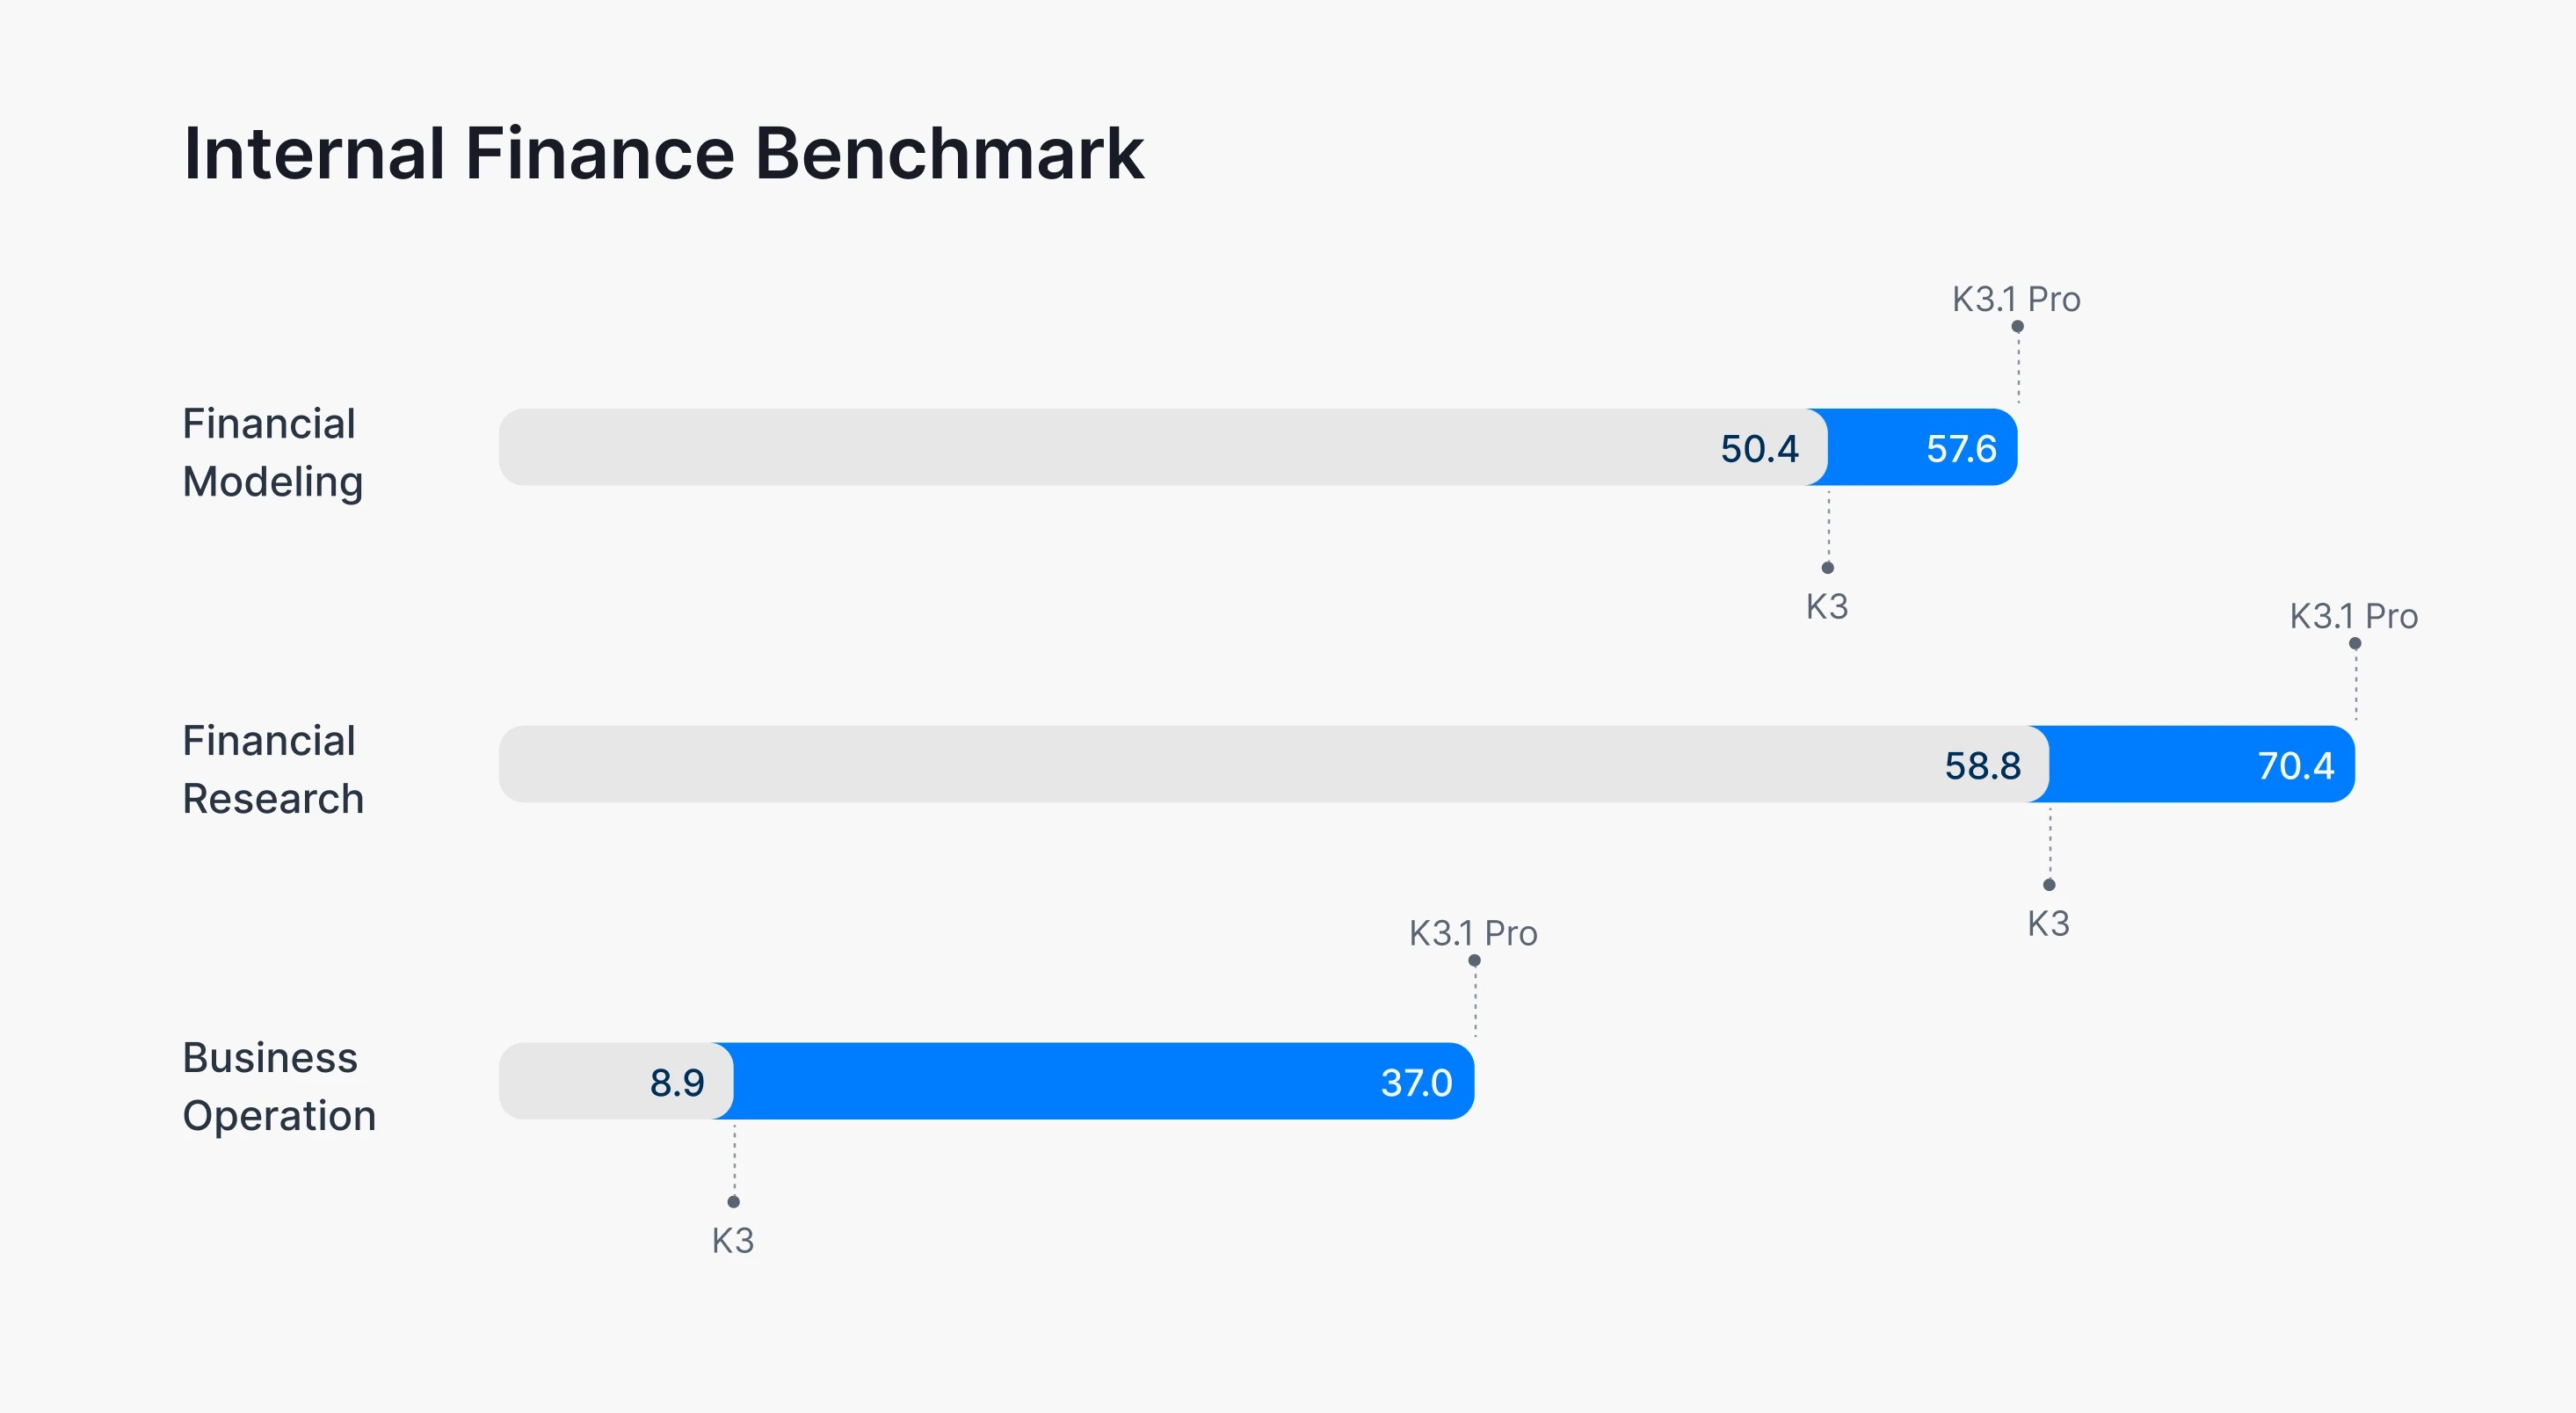
金融方向是这次着重强调的能力:从检索资料、跨文档核对数据,到搭建财务模型、开展标的筛选与盈利分析,官方称可以端到端完整交付。内部金融基准上,财务建模从 K3 的 50.4 提到 57.6,金融研究从 58.8 提到 70.4,提升幅度肉眼可见。第三方评测机构 Artificial Analysis 在 10 月 24 日给出的智能指数为 55 分,位列全球第四、开放权重模型第一。
短板同样摆在明面上:科研向的 Terminal-Bench Science 0.1 只拿到 38.1 分,同一测试里 GPT-6 Astra 是 68.1;高难推理测试 HLE-Diamond 得分 39.4,属于明显的失分区。另外,开放权重版本主动移除了网络攻防相关的训练数据,官方解释是强化学习规模扩大后漏洞挖掘能力涨得太快,出于安全考虑直接在数据源头删减,通用编程能力保留,内部测试解题率从 90.5% 降到 81.0%。
开源不等于能跑:1.56TB 权重与 12 张加速卡
「可下载」和「可本地运行」之间隔着一道硬门槛。2.8 万亿参数如果按 16 位精度存储,权重文件约 5.6TB;这次发布的版本采用 MXFP4 量化后压缩到约 1.56TB,主体以 safetensors 分片形式存放在 Hugging Face 仓库。按单卡 141GB 显存估算,仅加载权重就至少需要 12 张加速卡,推理还要预留 KV 缓存和中间计算空间,普通工作站和 8 卡服务器基本无缘。官方推荐 vLLM、SGLang、TokenSpeed 三套推理框架,实际有条件私有化部署的,主要是云厂商、推理服务商和大型机构,中小团队的主流入口仍然是 API。
生态与商用:许可证、托管服务和算力适配
许可证沿用 K3 时期那套厂商自拟协议:使用、修改、微调、再分发、销售都开放,红线划在规模化转售——企业及关联方提供模型推理或微调接口服务、连续 12 个月 MaaS 收入超 2000 万美元,商用前必须和月之暗面单独签约;基于模型开发的商用产品月活破 1 亿或月收入超 2000 万美元,需要在界面显著位置标注。纯内部使用和走官方渠道部署的可以豁免。
生态侧的动作也快:权重开放同一天,昇腾宣布完成 0Day 推理适配,可依托 vLLM Ascend 和 SGLang 框架在 Atlas 系列硬件上开展部署验证。月之暗面还同步推出了 Kimi Hosted Agents 托管智能体服务,把支撑 Agent 运行的 Harness 框架做成云端服务,面向企业内部系统的监控运维、面向用户产品的投研助手与智能客服两类场景,省掉自建运行环境动辄数月的开发周期。
总结
对普通用户来说,K3.1 Pro 权重开放的直接影响有限——家里没几张加速卡的人,日常用 Kimi App 和 API 的体验不会有任何变化。真正值得关注的信号是:开放权重模型和最强闭源模型的差距,已经缩小到肉眼难辨的程度,而部署门槛反过来把开源的意义从「人人能跑」重新定义成「大机构敢押注」。对企业 IT 决策者而言,数据不出域的本地部署选项、明确写到收入数字的许可条款,比榜单名次更有参考价值。开源生态接下来怎么消化这个 1.56TB 的大家伙,值得继续观察。
网友评论
- 「净改进率 +5.1% 这个指标有点意思,终于不是那种自己人投票的榜了,Shell 命令可靠性从负数拉到正的,天天写脚本的人应该最有体感。」
- 「1.56TB,下载都得下一整天,更别说 12 张卡了,看看就好,等社区卷出单卡量化版再来谈本地部署。」
- 「价格是 GPT-6 Astra 的五分之一,性能只差不到一个点,API 党直接赢麻,本地部署那是云厂商的浪漫。」
- 「有个疑问:移除攻防数据这波操作,会不会影响通用代码能力?解题率从 90.5% 掉到 81.0%,这个降幅不小啊。」
