11 月 5 日,百度宣布开源文心 5.5 Flash Base(ERNIE-5.5-Flash-Base),总参数量 280B 的稀疏 MoE 架构,每次前向仅激活 14B 参数,预训练数据规模达到 33.5T tokens。权重以 FP8 与 BF16 两种精度上线,训练上下文 128K,推理与微调阶段可扩展至 1M,vLLM 与 SGLang 两大推理框架同步宣布支持。这也是文心系列在开源方向上动作最大的一次:不是开放 API,而是把预训练终点的完整权重交到开发者手里。
280B 只激活 14B:开放的是预训练终点的 Base 权重
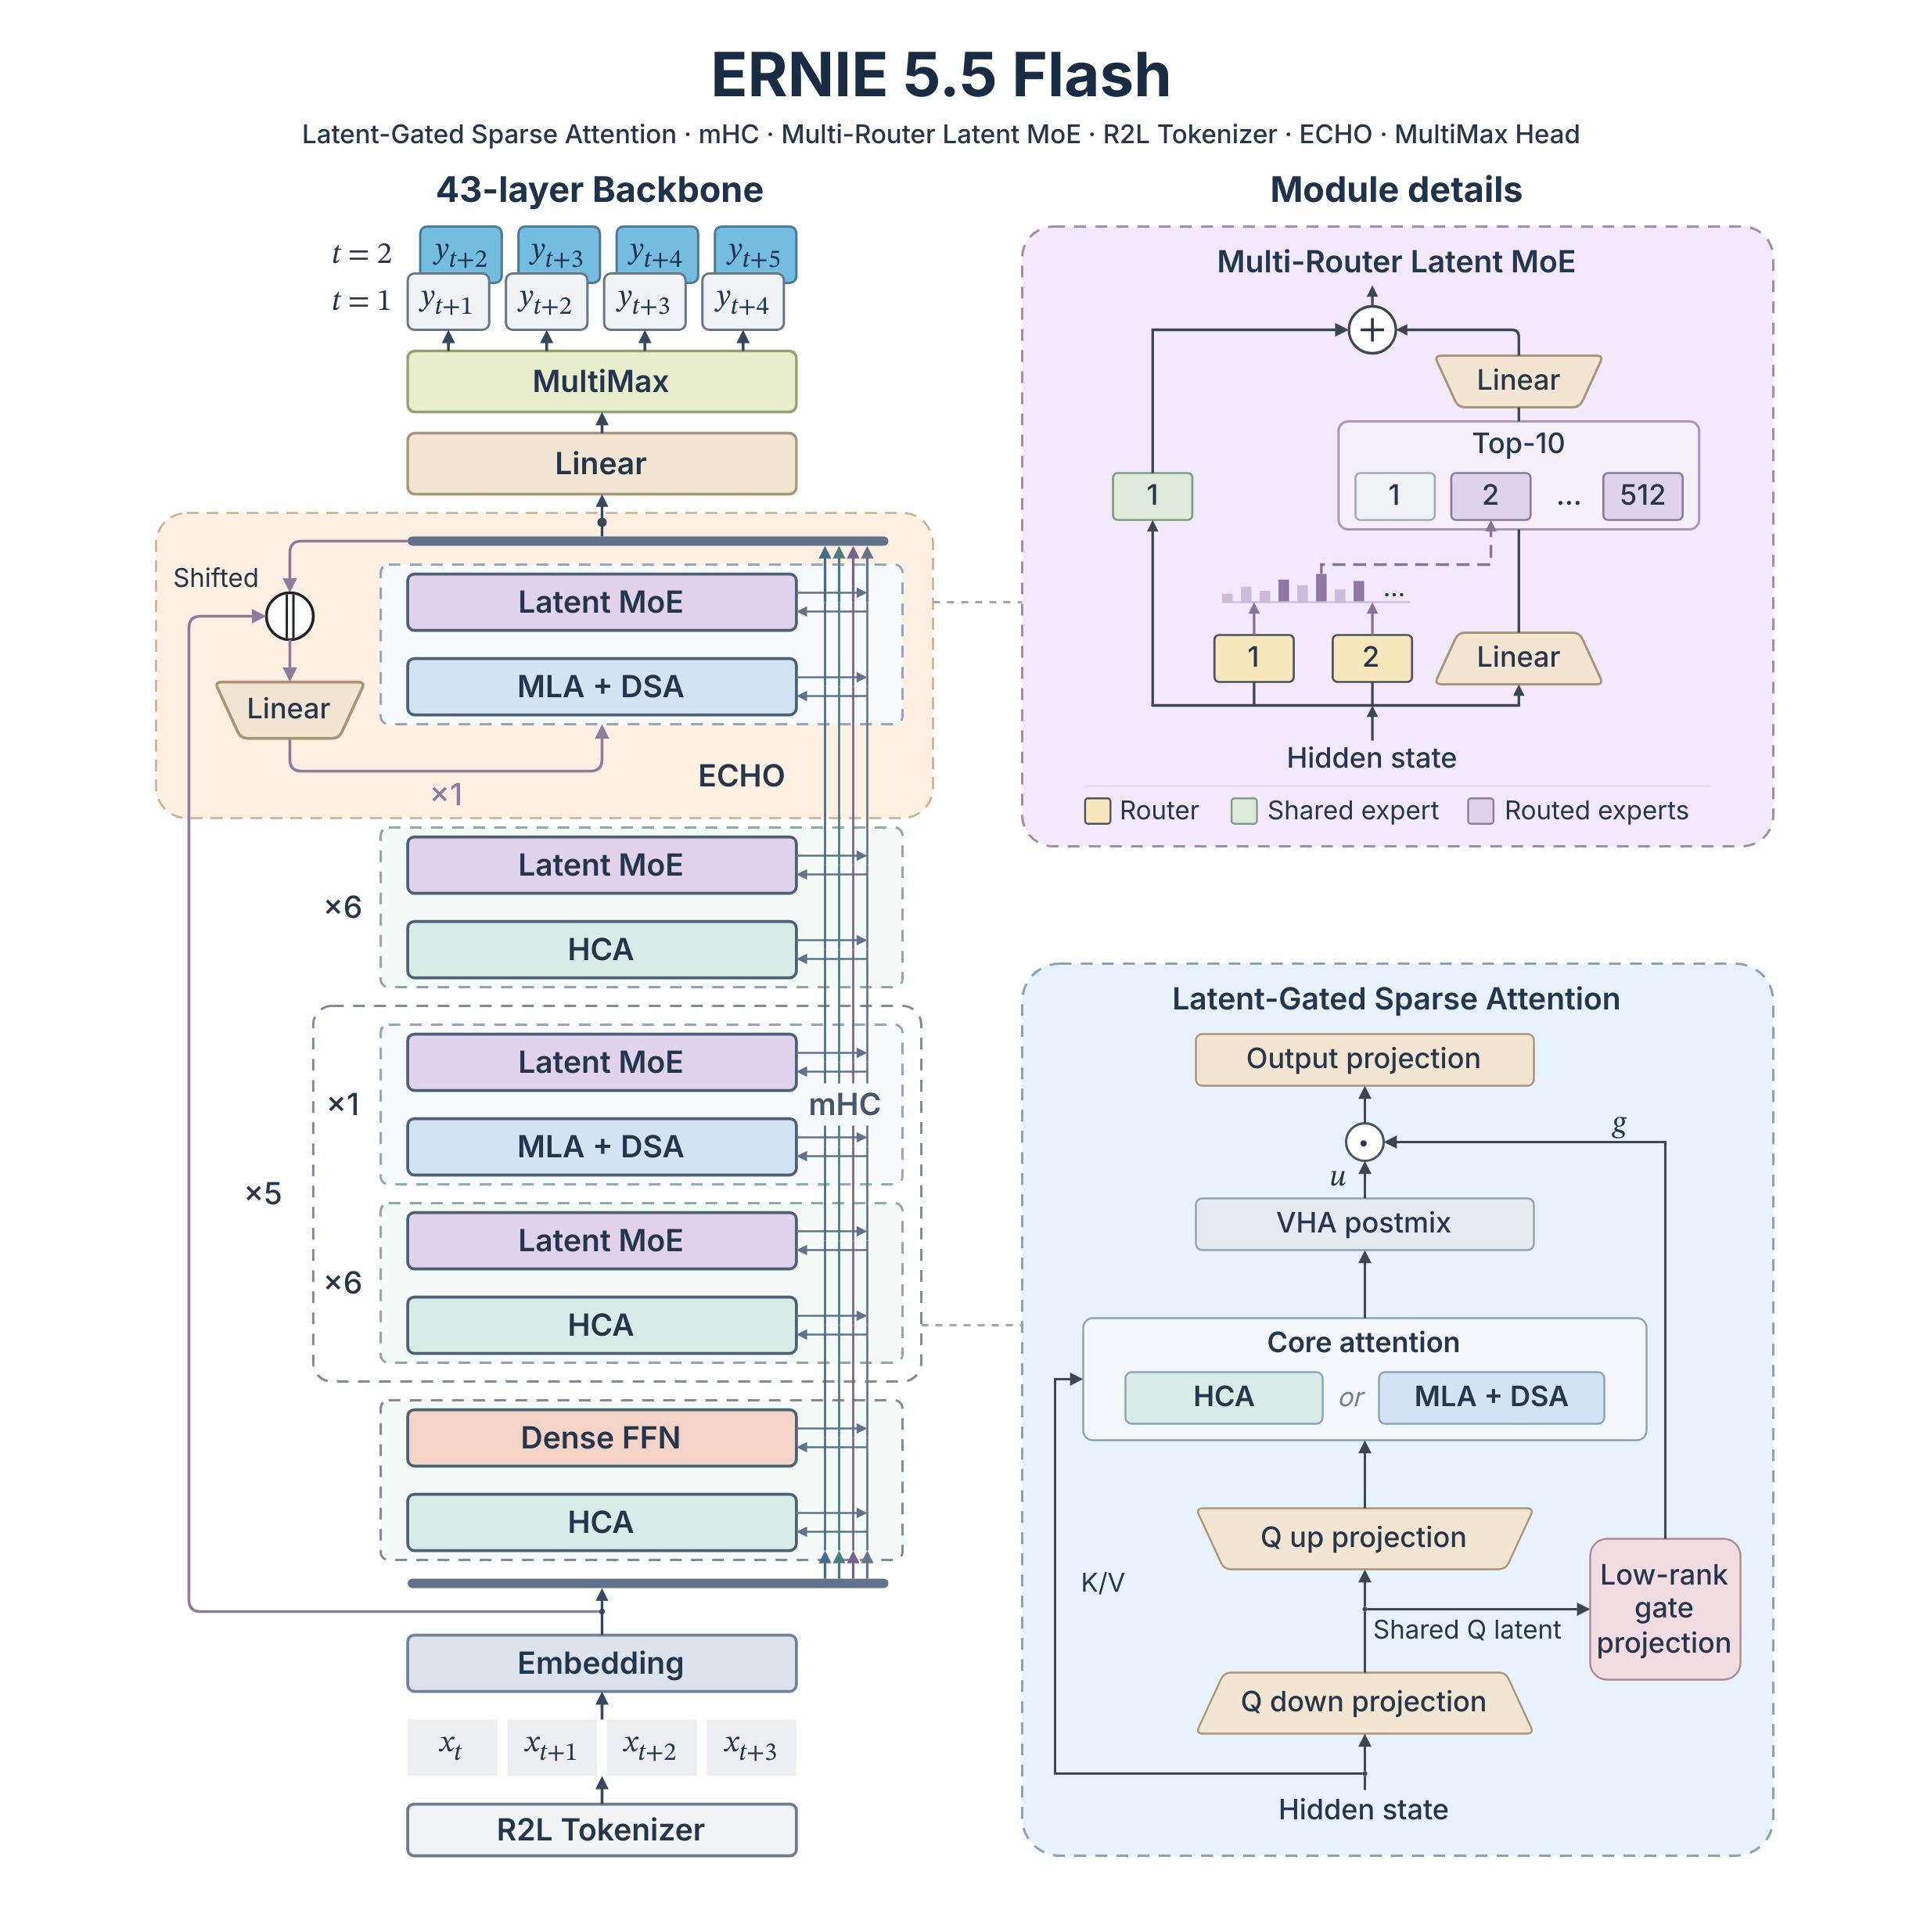
先看规格。ERNIE-5.5-Flash-Base 共 43 层,hidden size 4096,注意力 64 头,采用 MoE 结构:每层 512 个专家中路由选出 10 个,外加 1 个共享专家常驻。280B 是总参数量,实际每次推理只激活约 14B,这个比例让它在同类开源模型里属于「体量大、跑得省」的类型。
名字里的 Base 是关键。官方明确这批权重停在预训练终点,没有经过中训练与后训练,也就是没有对齐、没有指令微调,适合拿来做领域适配和 Agent 行为塑造的起点,而不是直接当聊天模型用。权重采用 FP8 与 BF16 两种精度发布,训练侧使用了 Muon 优化器与 FP8 混合精度。协议方面沿用 ERNIE 开源协议 v1.0,商用需按协议条款执行。
混合稀疏注意力:把 KV cache 花在刀刃上
长上下文的成本大头在注意力。这次文心 5.5 Flash Base 用了一套混合稀疏注意力:43 层里 6 层走 MLA(多头潜在注意力),其余 37 层走 HCA(层级上下文压缩注意力),把历史 KV 按 128:1 的比例压缩进少量记忆槽,KV cache 体积随之大幅下降。再配合 DSA 稀疏注意力机制,推理时只检索与当前 token 相关的部分,为 1M 上下文的实际可用性打底。
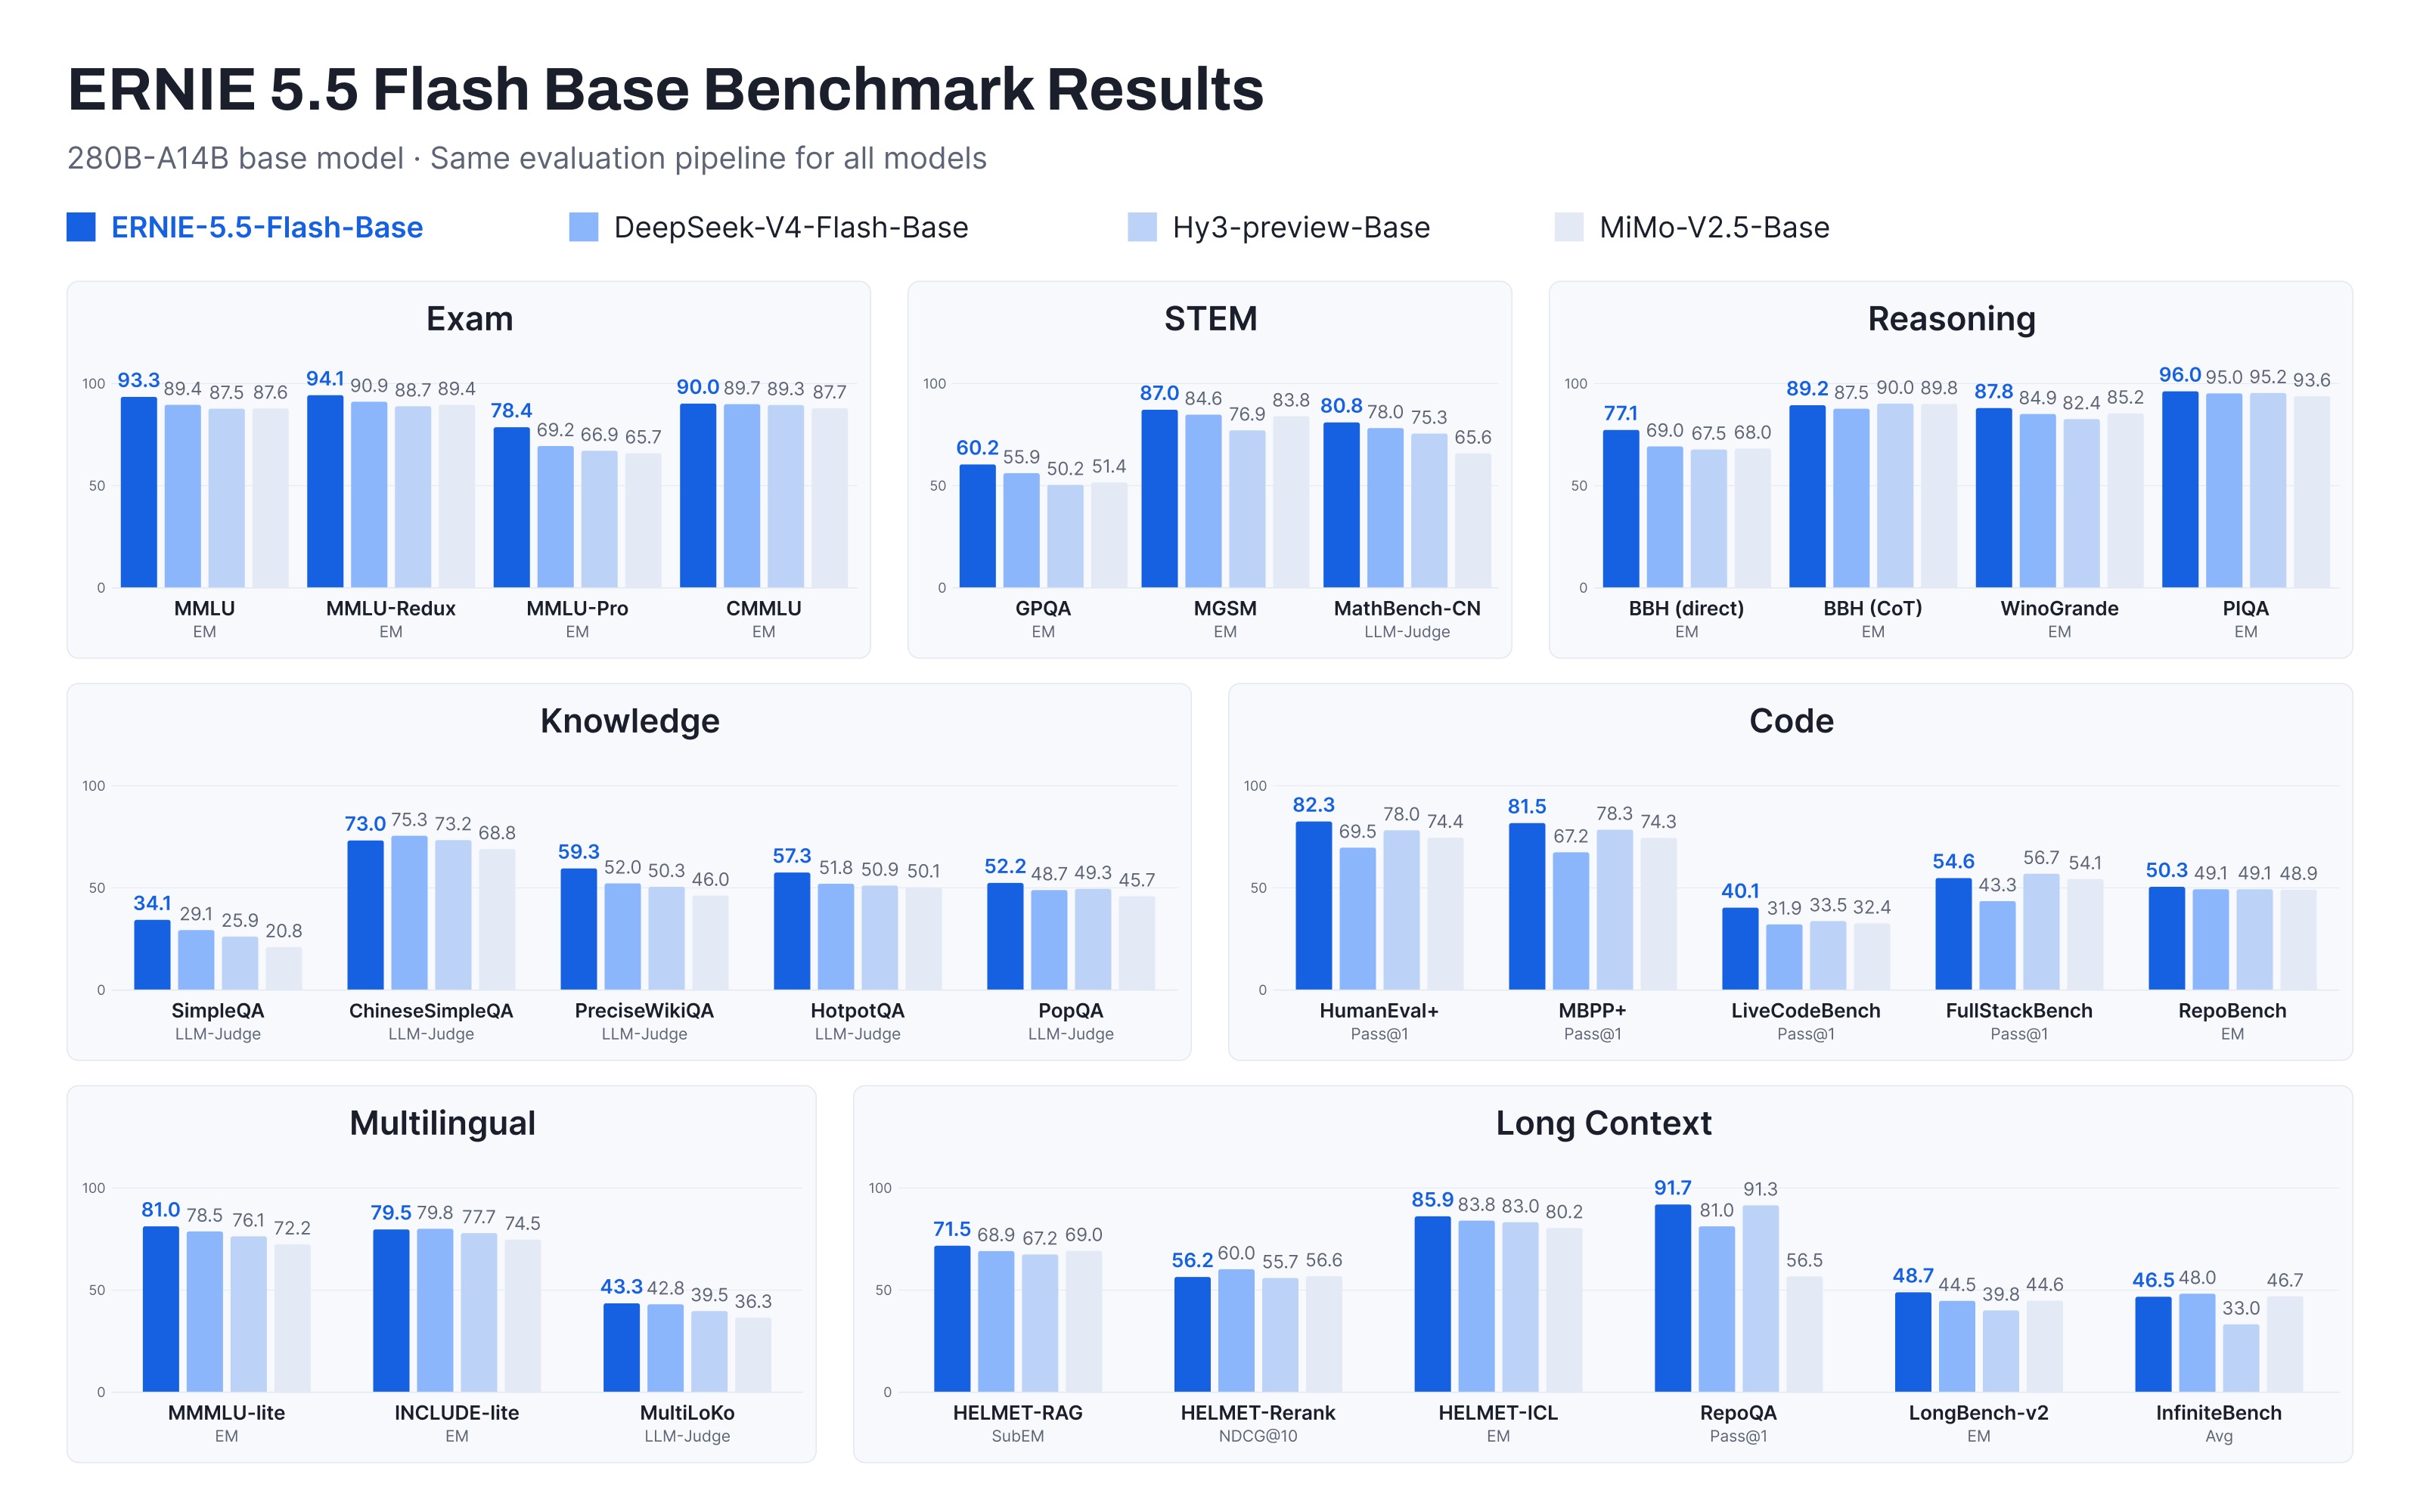
门控侧还引入了低秩结构,门控参数量砍掉约 75%。这套 VHA 方案有论文支撑,已被 NeurIPS 2026 接收。官方评测里 RepoQA 拿到 91.7,长代码仓库的理解能力是这个架构最直接的受益场景。
Multi-Router MoE 与 ECHO:路由更准,MTP 模块都省了
MoE 好不好用,路由占一半。文心 5.5 用 sigmoid 多路由器替代传统 softmax top-k,路由器在维度 2048 的共享隐空间里工作,专家间通信量减半,GPU 利用率随之提升。训练目标上叠加了 mHC 与 MultiMax 两项技术,用来缓解多专家训练不均衡的老问题。
另一处有意思的取舍是拿掉了 MTP 模块。不少新一代开源模型靠 MTP 做投机解码加速,文心 5.5 改用 ECHO 机制:直接复用主干末层充当 draft,不额外增加独立 draft 模型,参数与显存都省了下来。词表约 200K BPE,数字采用 R2L 切分,代码与数学场景的 token 效率更好。预训练语料里还混入了 commit、issue、PR、CI 日志这类真实工程数据。
同级对比成绩单:代码能力拉开最大差距
官方放出的对比对象是同量级开源 Base 模型:DeepSeek-V4-Flash-Base(284B 总参、激活 13B)、Hy3(295B-A21B)与 MiMo-V2.5(310B-A15B)。代码是差距最明显的一块:HumanEval+ 拿到 82.3,对比组最好成绩 69.5;LiveCodeBench 40.1 对 31.9;FullStackBench 54.6 对 43.3。通用能力上 MMLU 93.3、BBH(CoT)89.2,同样处在第一梯队。
短板也有:ChineseSimpleQA 73.0,略低于对比组 75.3 的成绩。推理框架层面,配合 FlashMask-4 在新一代 SM100 架构 GPU 上前向速度提升约 175%,这一数字来自官方环境测试,实际收益依硬件配置而定。
vLLM、SGLang 生态跟进,1M 上下文部署门槛不低
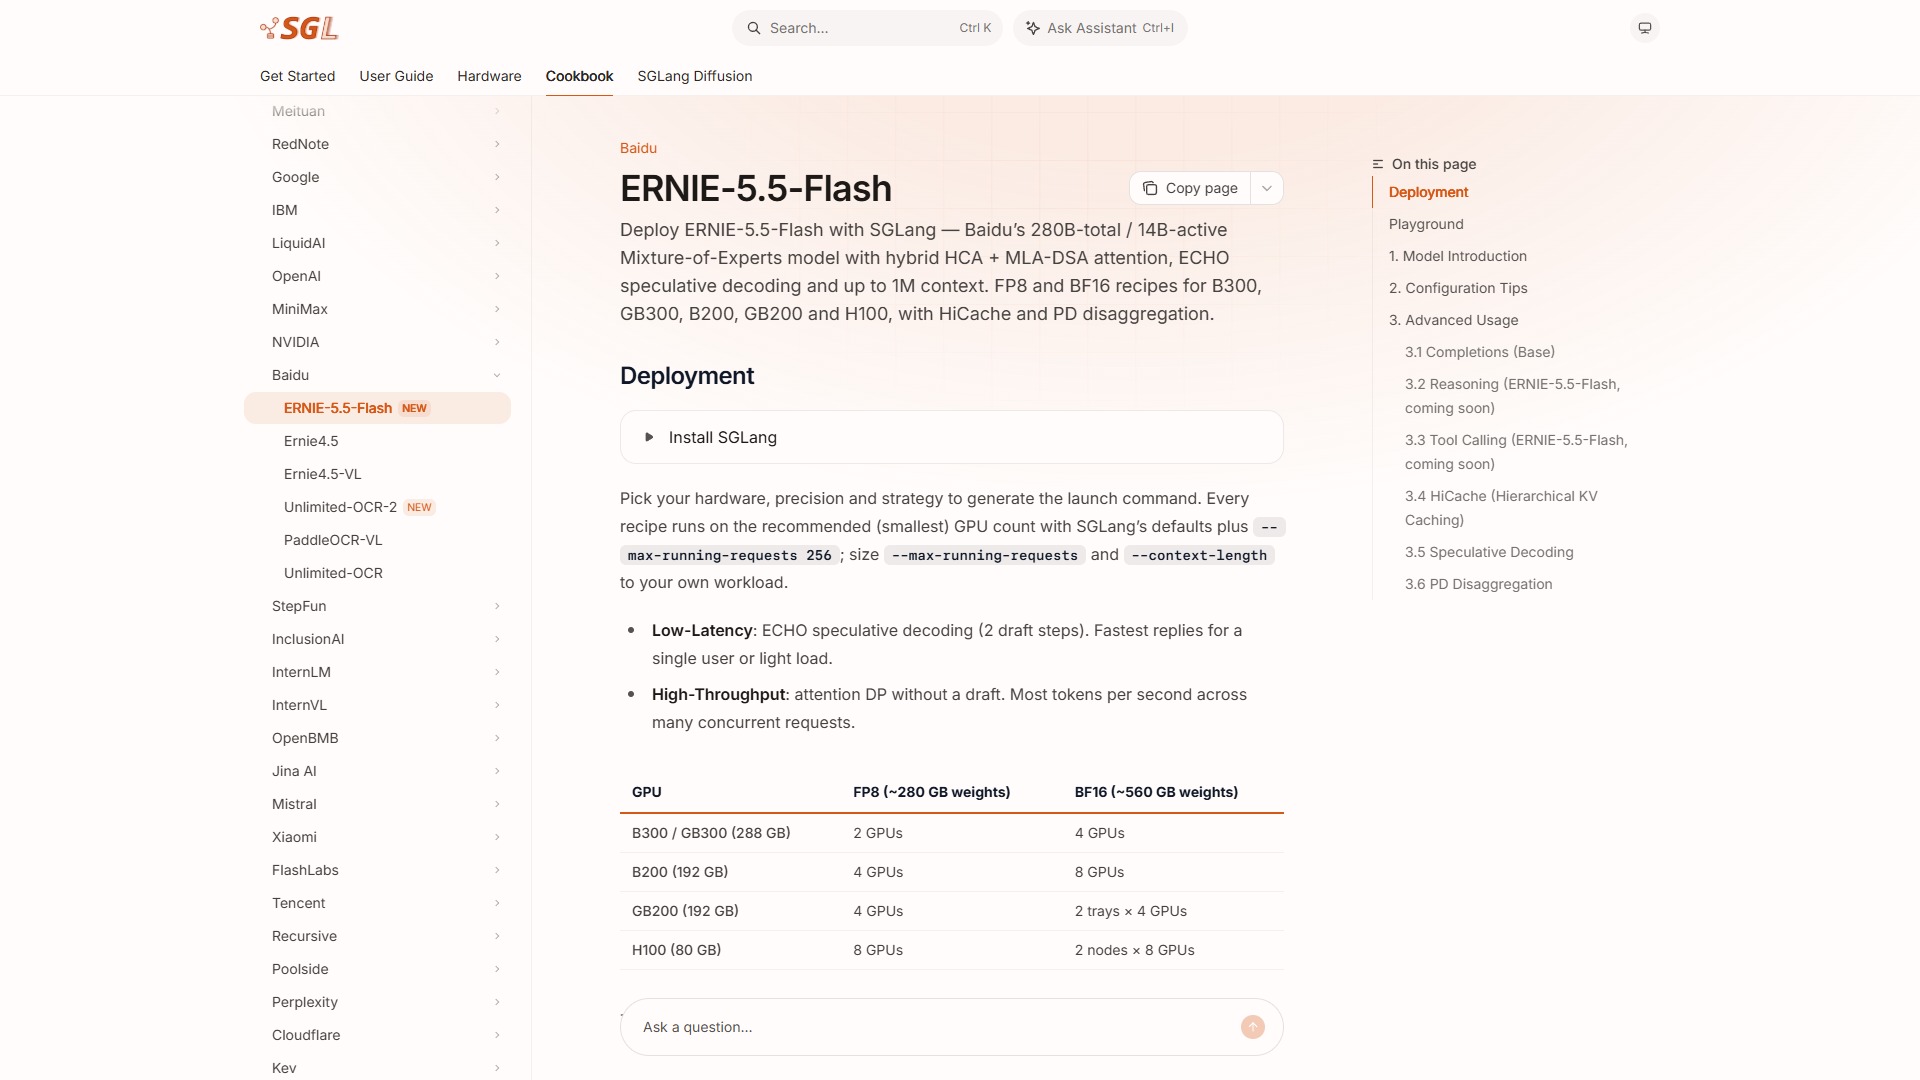
对开发者来说,权重开源只是第一步,能不能跑起来更关键。vLLM 与 SGLang 已在发布当天同步支持,SGLang 官方文档给出了部署参考:FP8 精度下 B300 两卡或 H100 八卡可跑;BF16 全量权重约 560GB,需要 H100 两节点十六卡。微调侧提供了 Megatron-Bridge 训练示例,ECHO 投机解码、HiCache 与 PD 分离等特性也在适配清单里。
几个实用细节:加载 tokenizer 时建议保持 add_special_tokens=True,避免 BOS token 缺失影响输出质量;FP8 版本是当前性价比最高的部署选择;量化版与后训练出的聊天版本官方尚未放出,有需求的团队可能要再等一等。
网友评论
- 「280B 开源只激活 14B,这个规格给得挺实在,比某些挤牙膏的强多了。」
- 「BF16 权重 560GB,先看看硬盘还够不够,这体积真下不起了。」
- 「没有量化版之前,个人玩家基本无缘,坐等社区出 GGUF。」
- 「Base 模型拿来微调是好事,不过多数人不缺 Base,缺的是能直接用的 chat 版。」
总结
文心 5.5 Flash Base 这波开源,规格上把诚意拉满:280B MoE 只激活 14B、1M 上下文、33.5T tokens 预训练,加上 vLLM 与 SGLang 当天跟进,工程侧配套算得上齐全。对打算做领域适配和 Agent 开发的团队,这是一份起点很高的 Base 权重;对普通用户来说,真正的体验变化要等后训练版本落地。代码能力的领先幅度与中文知识的微小短板都摆在明面上,值不值得上手,取决于你的显存够不够。
