蚂蚁百灵把 560B 的 Ling-3.1-flash 放出来了,权重随便下
10 月 15 日,蚂蚁百灵正式开源 Ling-3.1-flash,权重挂在 Hugging Face 和 ModelScope,许可证是 MIT——总参数约 560B、每 Token 激活约 25B 的 MoE 模型,以最宽松的方式交到开发者手里。这个节奏早有铺垫:模型 9 月 30 日发布时走的是两周免费 API 试用,上下文封顶 256K,官方当时就承诺免费期结束后放开完整 1M 上下文并开源权重。10 月 14 日免费期一到,权重同步上线,说到做到。
对蚂蚁来说,这一步的意义不只是「又一家大厂开源」。百灵 9 月 30 日发布 Ling-3.1-flash 时,就把它放进办公、医疗沟通和软件研发等真实场景里跑,这次开源是让团队在自己的任务和算力环境中检验模型能力与推理效率——买不买账,自己跑一遍就知道。开源模型圈最近确实热闹,前有 Z.ai 开源 GLM-Legal 切法律场景,后有 阶跃星辰放出 Step 5 Preview,现在蚂蚁拿 1M 上下文入场,开源阵营的牌面越来越齐。
顺带理一下百灵 flash 家族的节奏:Ling-3.0-flash 7 月发布,多模态的 Ling-3.0-flash-VL 9 月跟进,中间还插了面向金融研究的 Ling-3.0-flash-Fin(总参 124B、激活 5.1B)和医疗场景的 Sante 版本。三个月连发四款,Ling-3.1-flash 是这个家族里首个把权重完整放出来的旗舰文本模型,动作比多数大厂利索。
混合线性注意力加稀疏 MoE,激活只有 25B
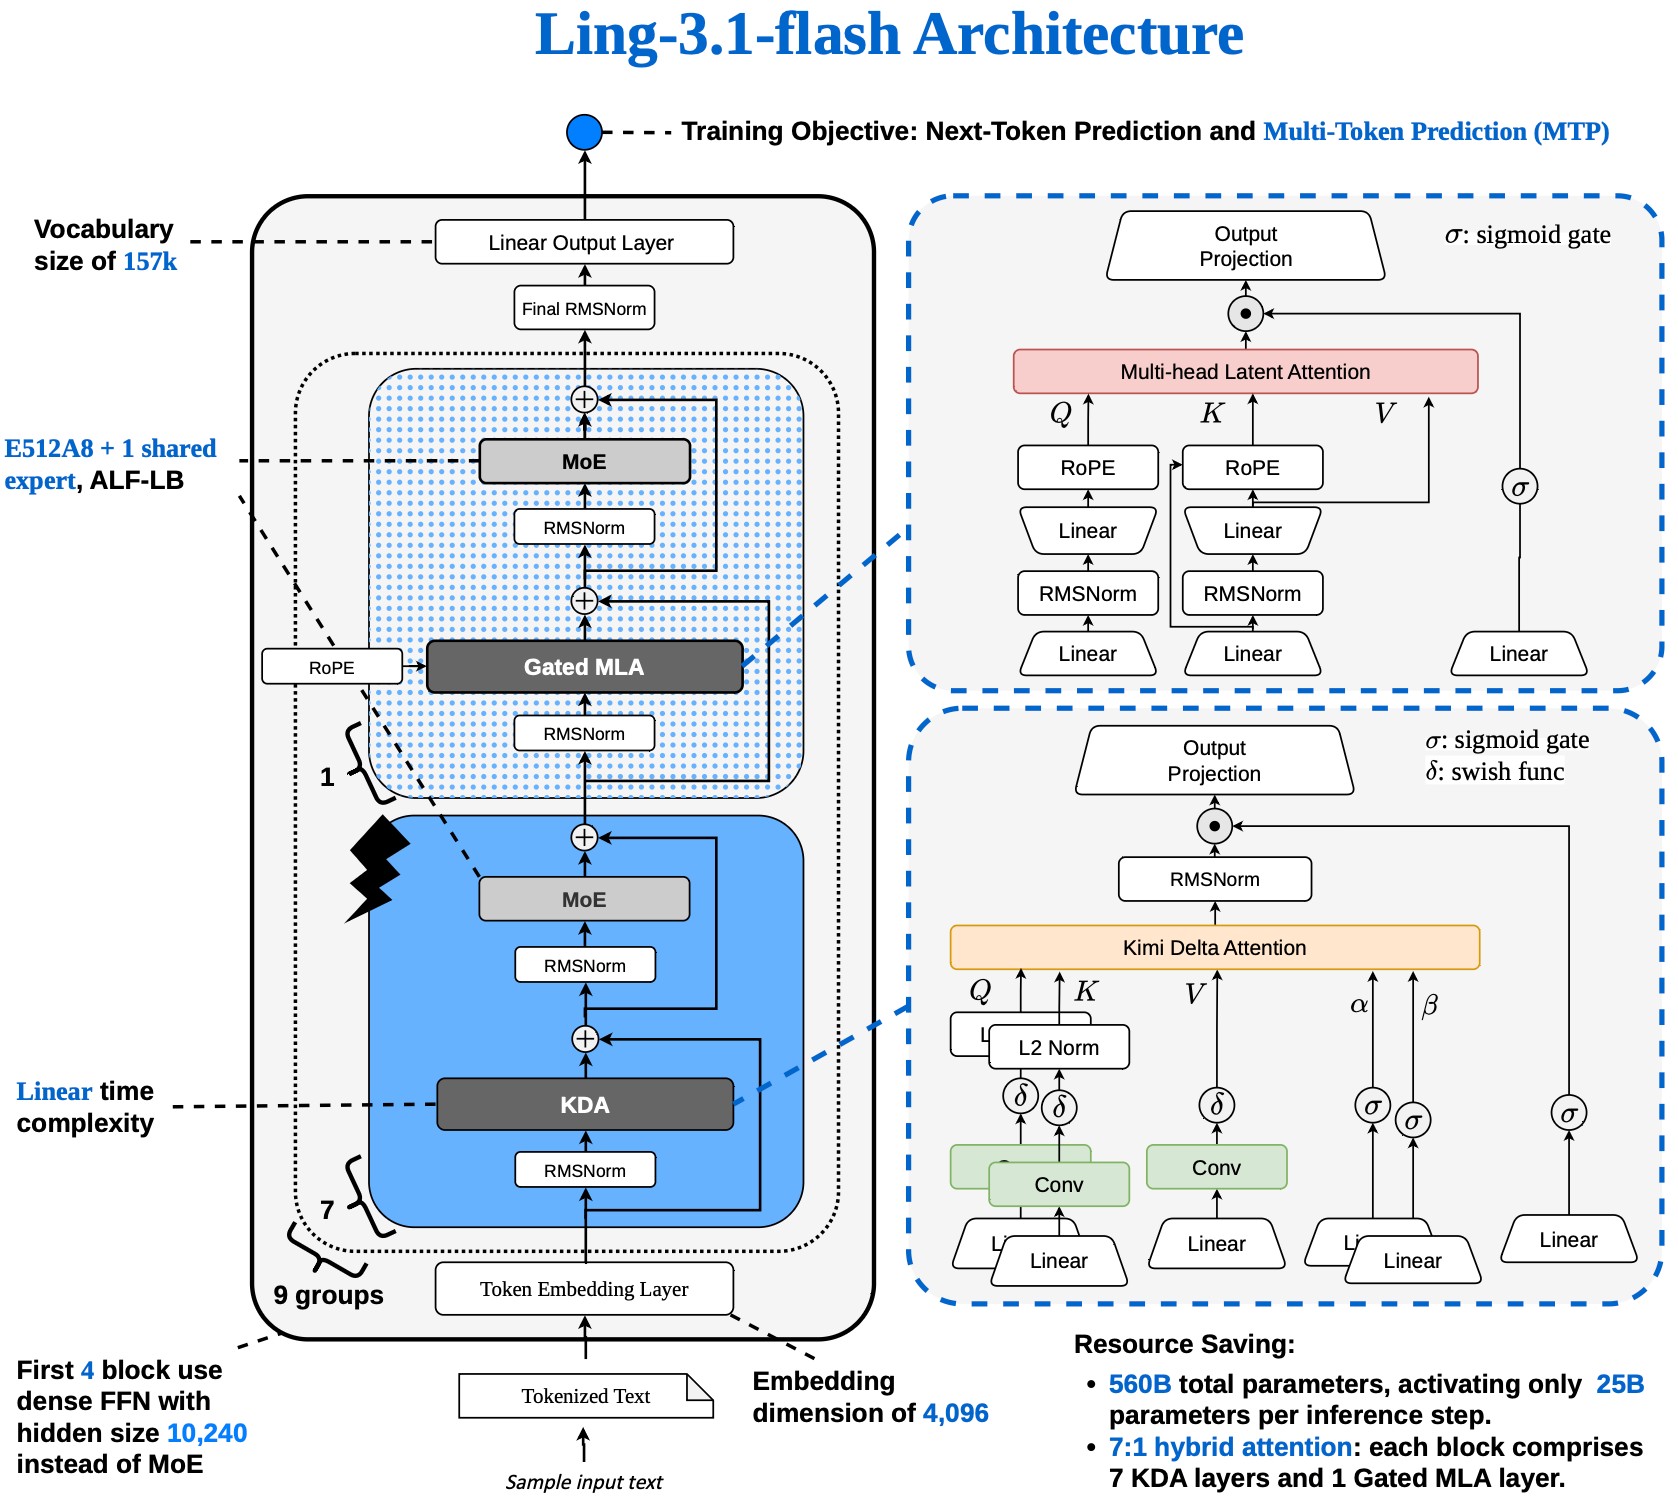
参数细节上,Ling-3.1-flash 是基于 Ling-3.0-flash 的原生混合推理模型,总参数约 560B,每 Token 激活约 25B。架构走混合线性 MoE:63 层 KDA 线性注意力配 9 层 Gated MLA,按 7:1 交替堆叠,另有 4 层 dense 层;专家侧是 512 个 routed expert 加 1 个 shared expert,每 Token 激活 8 个专家。真正参与计算的比例不到总参数的二十分之一,这是它能兼顾规模和推理成本的关键。
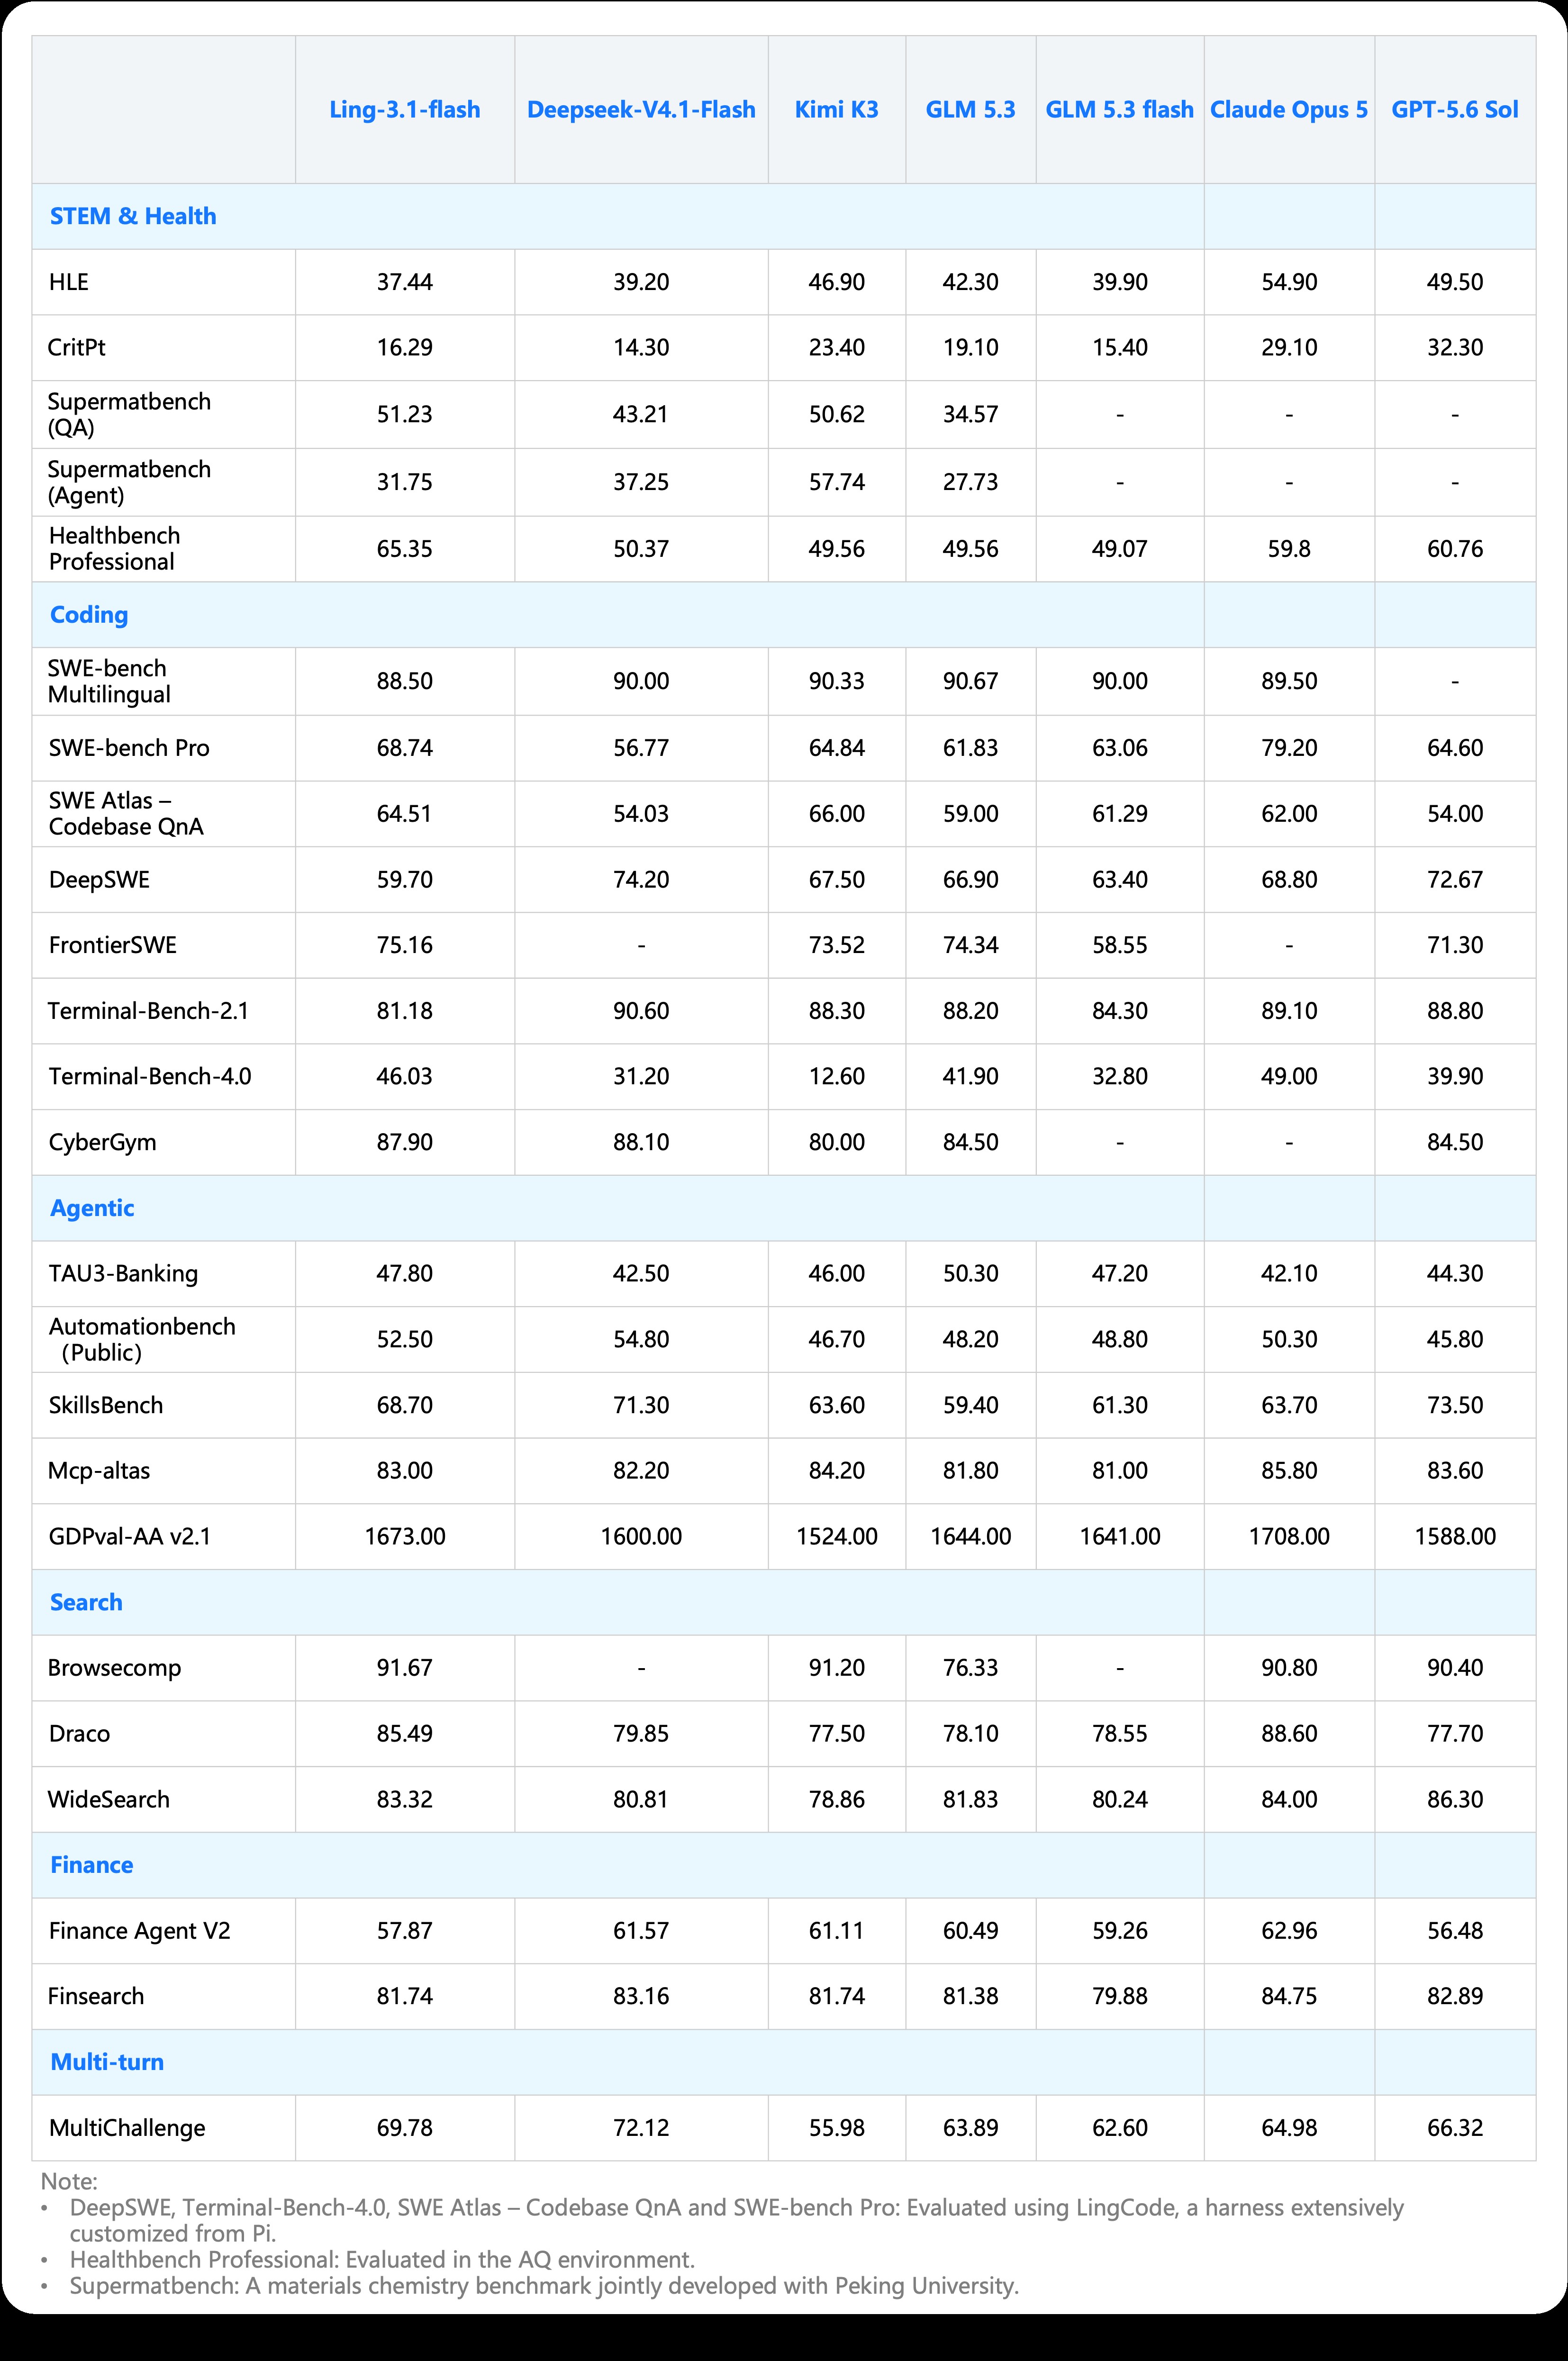
上下文最高 1M Token。官方模型卡同时列出了 Terminal-Bench 4.0、SWE-bench Pro、FrontierSWE、GDPVal-AA V2.1、MCP-Atlas、SkillsBench 等一串 coding 和 agent 评测,也点名了金融与材料科学方向的能力提升。模型卡上的数字要看,但权重既然开放,复现门槛已经拉到最低。
跑分与真实场景:智能指数 41,办公评测 ELO 1673
第三方评测里,Artificial Analysis 给 Ling-3.1-flash 的智能指数是 41,输出速度约每秒 210 Token,混合价格约每百万 Token 0.19 美元。Design Arena 的 Open Weights 分类榜上,它在数据可视化、React Native 移动应用、3D 设计和游戏开发四个方向都排到第三,SVG 生成和网站制作分别第四、第五。
需要提醒的是,Artificial Analysis 的智能指数是综合口径,单项能力未必反映全貌;内部 Lua 编译器任务属于自家命题,含金量要打折扣看。真正有价值的对照,是开源之后社区在真实负载下跑出的复测数据——权重开放的意义就在这里,跑分争论可以交给时间,修复和调优的空间反而比闭源 API 大得多。
更贴近生产的数字来自官方口径:GDPVal-AA V2.1 办公任务评测 ELO 1673;内部 Lua 原生编译器开发任务跑了约 17 小时、涉及数百次工具调用,独立测试通过率 97.8%;HealthBench Professional 医疗评测中表现相对领先。官方也坦白了短板:一次性灌入大量长文本可能失焦,一次性生成的效果有适配边界,当前版本没有原生视觉理解,要配独立的视觉模型。
能力定位上,官方的描述是把需求理解、任务拆解、信息整合、工具调用和结果校验串成一条链,能跨网页、文档、表格和代码环境干活,产出 Excel、PPT 和代码。蚂蚁还把它接进了内部桌面协作 Agent 客户端「小虎」,等于自家业务先当了三个月小白鼠,这种先内部验证再开源的顺序,比直接发模型卡要可信一些。
1M 上下文到底意味着什么
1M Token 大约是一次性读完上千页文档、一个中型代码仓库或几十万行日志。对企业知识问答、办公助手这类场景,价值很直接——先读完长资料再回答,而不是靠检索拼片段。配合官方提供的长上下文并行推理方案 PCP 与 DCP,以及加强的 JSON Schema 工具调用支持,「长文档进、结构化结果出」的链路是完整的。
如果你想拿来跑长文档:权重是 MIT,成本主要在卡。混合线性注意力本身就是为长序列省算力设计的,KDA 这类线性注意力层的显存开销不随序列长度平方增长,1M 窗口不是营销数字。Agent 场景下它还兼容 Claude Code、Kilo Code、Qwen Code、Hermes Agent、OpenClaw 等主流编码框架,官方另介绍了基于开源 coding agent Pi 打造的 LingCode,专门伺候跑数小时、几百次工具调用还要反复压缩上下文的长任务,未来可能开源。对做自动化办公和数据可视化的团队来说,Design Arena 那几个第三名比综合榜单更有参考价值。
当然,长上下文不是万能药,一次塞进百万 Token 的推理成本多数业务未必扛得住,该做检索的还是得做检索。更现实的用法是分层:日常问答走短上下文加缓存,季度复盘、全库代码审计、长合同审阅这类「必须整本读」的任务再切到 1M 模式。官方定价里缓存读取只要输入价的五分之一,说明团队自己也清楚,重复长上下文的命中会是高频需求,这一层成本账,部署前值得先算。
MIT 许可与部署:292GB 权重,4 卡 Hopper 能跑
许可证是 MIT,商用基本没有法律包袱。部署侧,团队对 routed experts 采用 MXFP4 量化、dense 层保持 block-FP8,权重占用从约 534GB 降到 292GB,对应 Hopper GPU 配置下服务部署从 8 卡降到 4 卡。模型卡推荐 SGLang,参考配置是 8 张 H200 或 4 张 GB300,vLLM 也给了配方。推理性能有两个参考值:平均输入约 25.47K Token 的模拟生产请求中,8 卡 Hopper 的首 Token 时间 604 毫秒、相邻输出 Token 间隔 3.28 毫秒;4 卡 Hopper 吞吐测试约 1.36 QPS,同时满足首 Token P50 小于 3 秒、相邻输出 Token 间隔 P90 小于 70 毫秒的约束。
不想自建集群的,API 价格也摆出来了:Ling Studio 输入 0.5 元、输出 1.5 元、缓存读取 0.1 元,目前限时 2.5 折;OpenRouter 输入 0.075 美元、输出 0.225 美元、缓存读取 0.015 美元。缓存命中率高的重复业务场景,这个价差空间值得算一算。
- 560B 肯定拉不下我的 4090,不过 292GB 的量化权重理论上四卡凑一凑能跑,等社区出更激进的量化再上车。
- 智能指数 41 这个档位,跟 DeepSeek、Qwen 的开源旗舰比可能还有差距,但 1M 上下文加 MIT 这个组合确实少见,先把权重收藏了。
- 混合线性注意力这个方向感觉是对的,KDA 配 Gated MLA,长序列的成本曲线应该比纯注意力好看,蹲一个百万 token 长文档实测。
- 办公评测 ELO 1673 看着不错,蚂蚁自家场景喂出来的模型,中文办公任务说不定真有优势,正好拿来做企业知识库试试水。
总结
Ling-3.1-flash 把「大参数、长上下文、宽松许可」三件事装进了同一个包:560B 总参、25B 激活、1M 窗口、MIT 许可、量化后 292GB 可部署。它未必在每一项跑分上都压过 DeepSeek 或 Qwen 的旗舰,但给需要一个自托管长上下文模型的团队提供了新选项。三个月连发四款 flash 家族模型的节奏,也说明蚂蚁在开源这件事上不是做姿态。权重已在 Hugging Face 和 ModelScope 上架,想验证的,直接下。
