调用第三方模型 API 时,用户拿到的只是一串返回文本,至于背后跑的到底是开发者承诺的那个模型,还是被悄悄换掉的便宜货,长期以来只能靠信任。Anthropic 在官方研究文章中宣布,把可证明推理原型 FlashProve 开源到 GitHub,尝试用密码学手段给每条回答盖上一枚可以独立核验的「印章」——不打开黑箱,也能确认里面跑的是哪台机器。
你调用的模型,真的是你以为的那个吗
模型 API 的机制类似黑箱:请求发过去,返回若干 Token,中间发生了什么外人看不见。用户无法核实回答出自开发者宣称的那个模型,而不是被路由服务出于成本考虑偷偷替换的另一个模型,甚至可能被攻击者篡改过 Token 流。对独立评测机构来说,问题更直接——他们测的是不是厂商实际对外服务的那个版本,过去几乎没有手段确认。
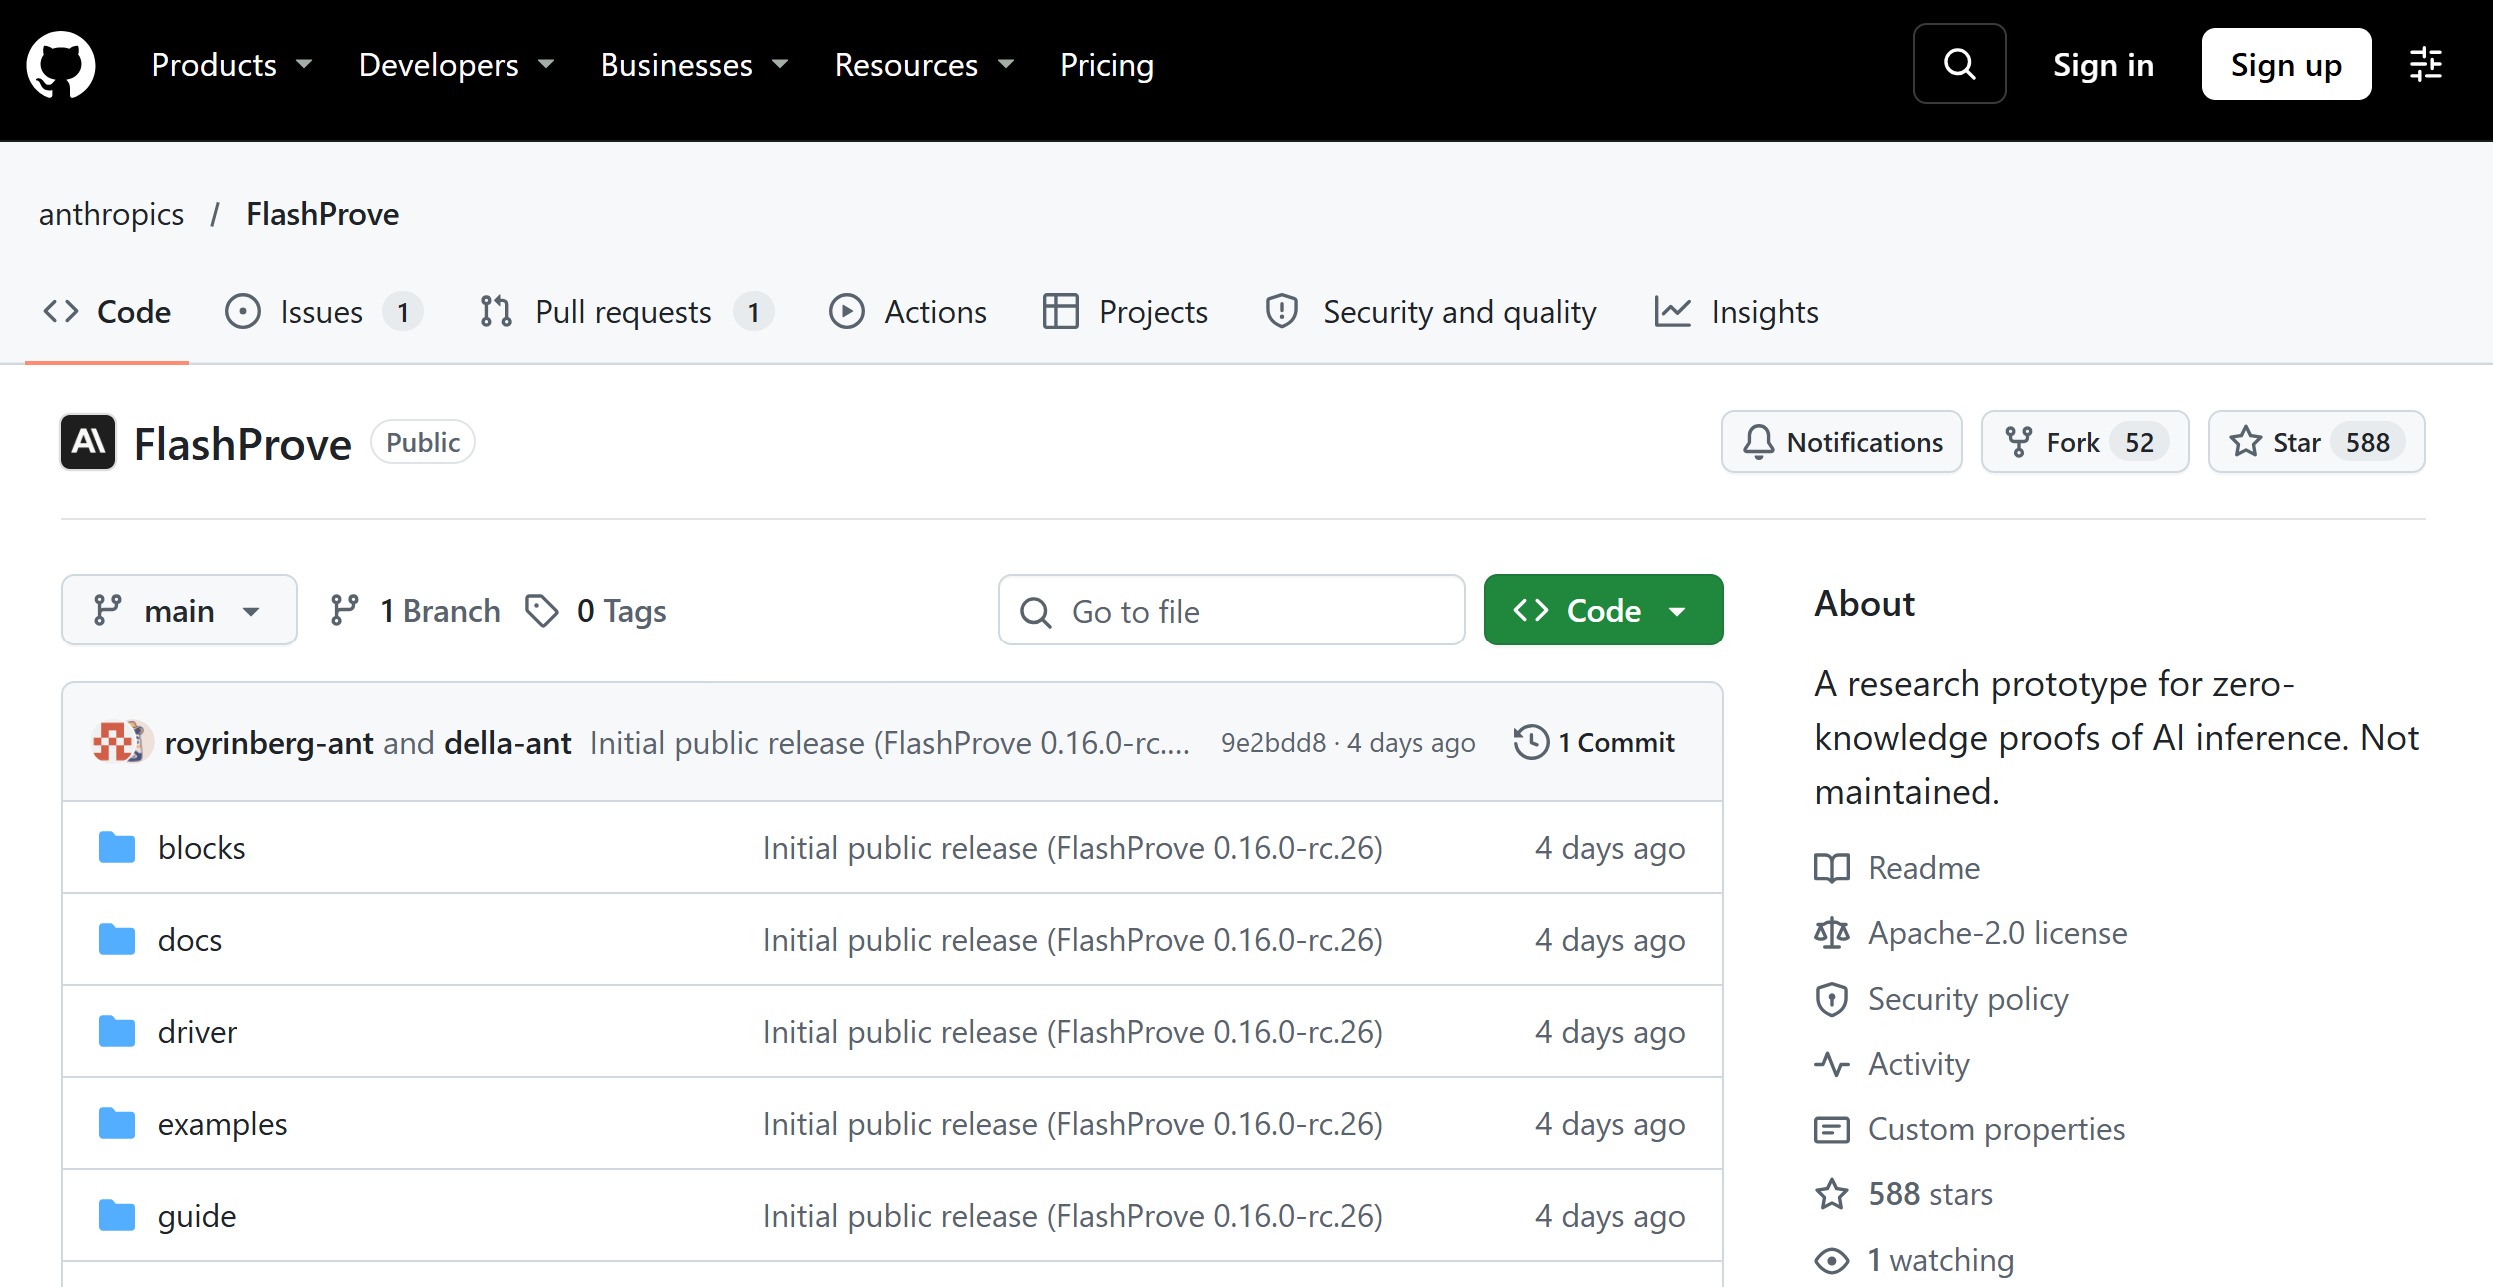
指望用户自己复算一遍也不现实。前沿模型的权重大多保密,即使拿到权重,跑一遍千亿参数模型所需的算力也远超普通用户甚至评测机构的承受范围。所谓可证明推理,目标是让一个没有权重、算力有限的用户,也能核验回答确实出自被指定的模型。FlashProve 就是该方向的研究原型,代码、技术报告、协议规范与形式化证明均以 Apache 2.0 许可发布,背后团队来自 Anthropic、EPFL、MIT、StarkWare 与 Succinct 等机构,仓库明确标注为研究产物,不承诺维护。
一枚不泄密的印章:zkSNARK 到底在证什么
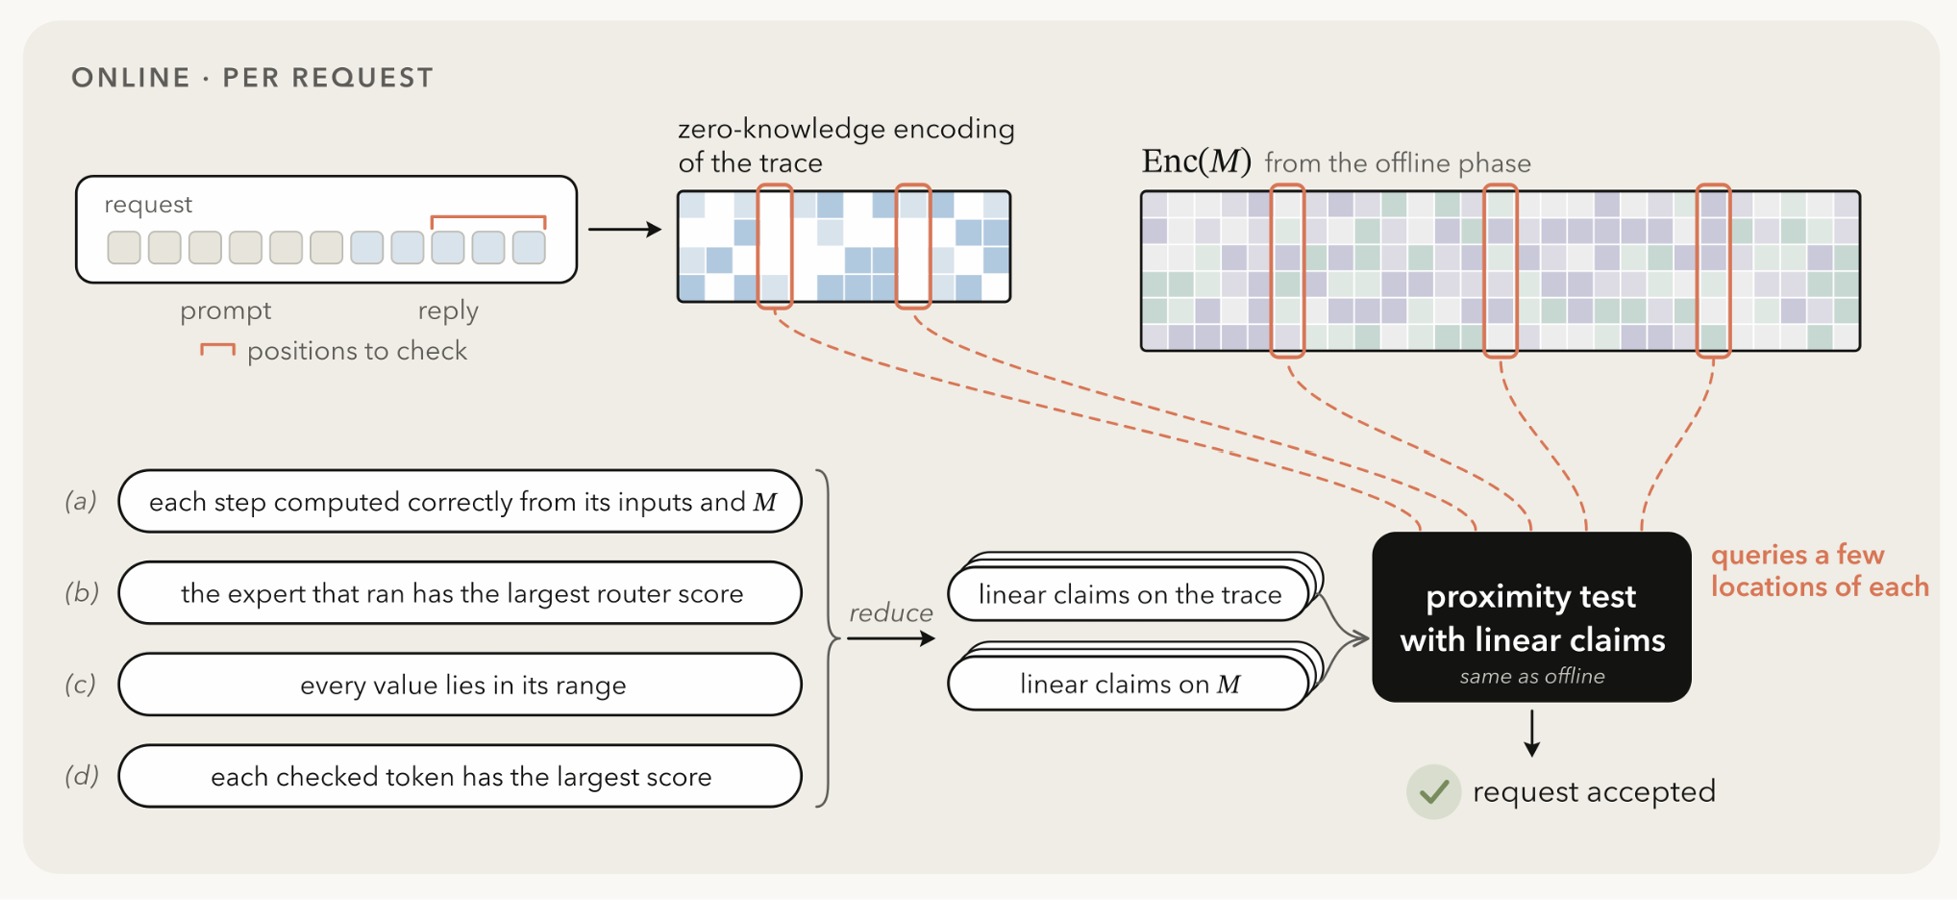
FlashProve 的核心是一种名为 zkSNARK 的零知识证明技术。流程分三步:服务方先对模型权重做编码,发布一个密码学承诺,相当于给这组权重建了一份指纹;之后每条回答都附带一份证明,说明这条回答确实是承诺权重按规则算出的结果;任何人在普通 CPU 上几秒钟就能核验这份证明,全程不需要接触权重。
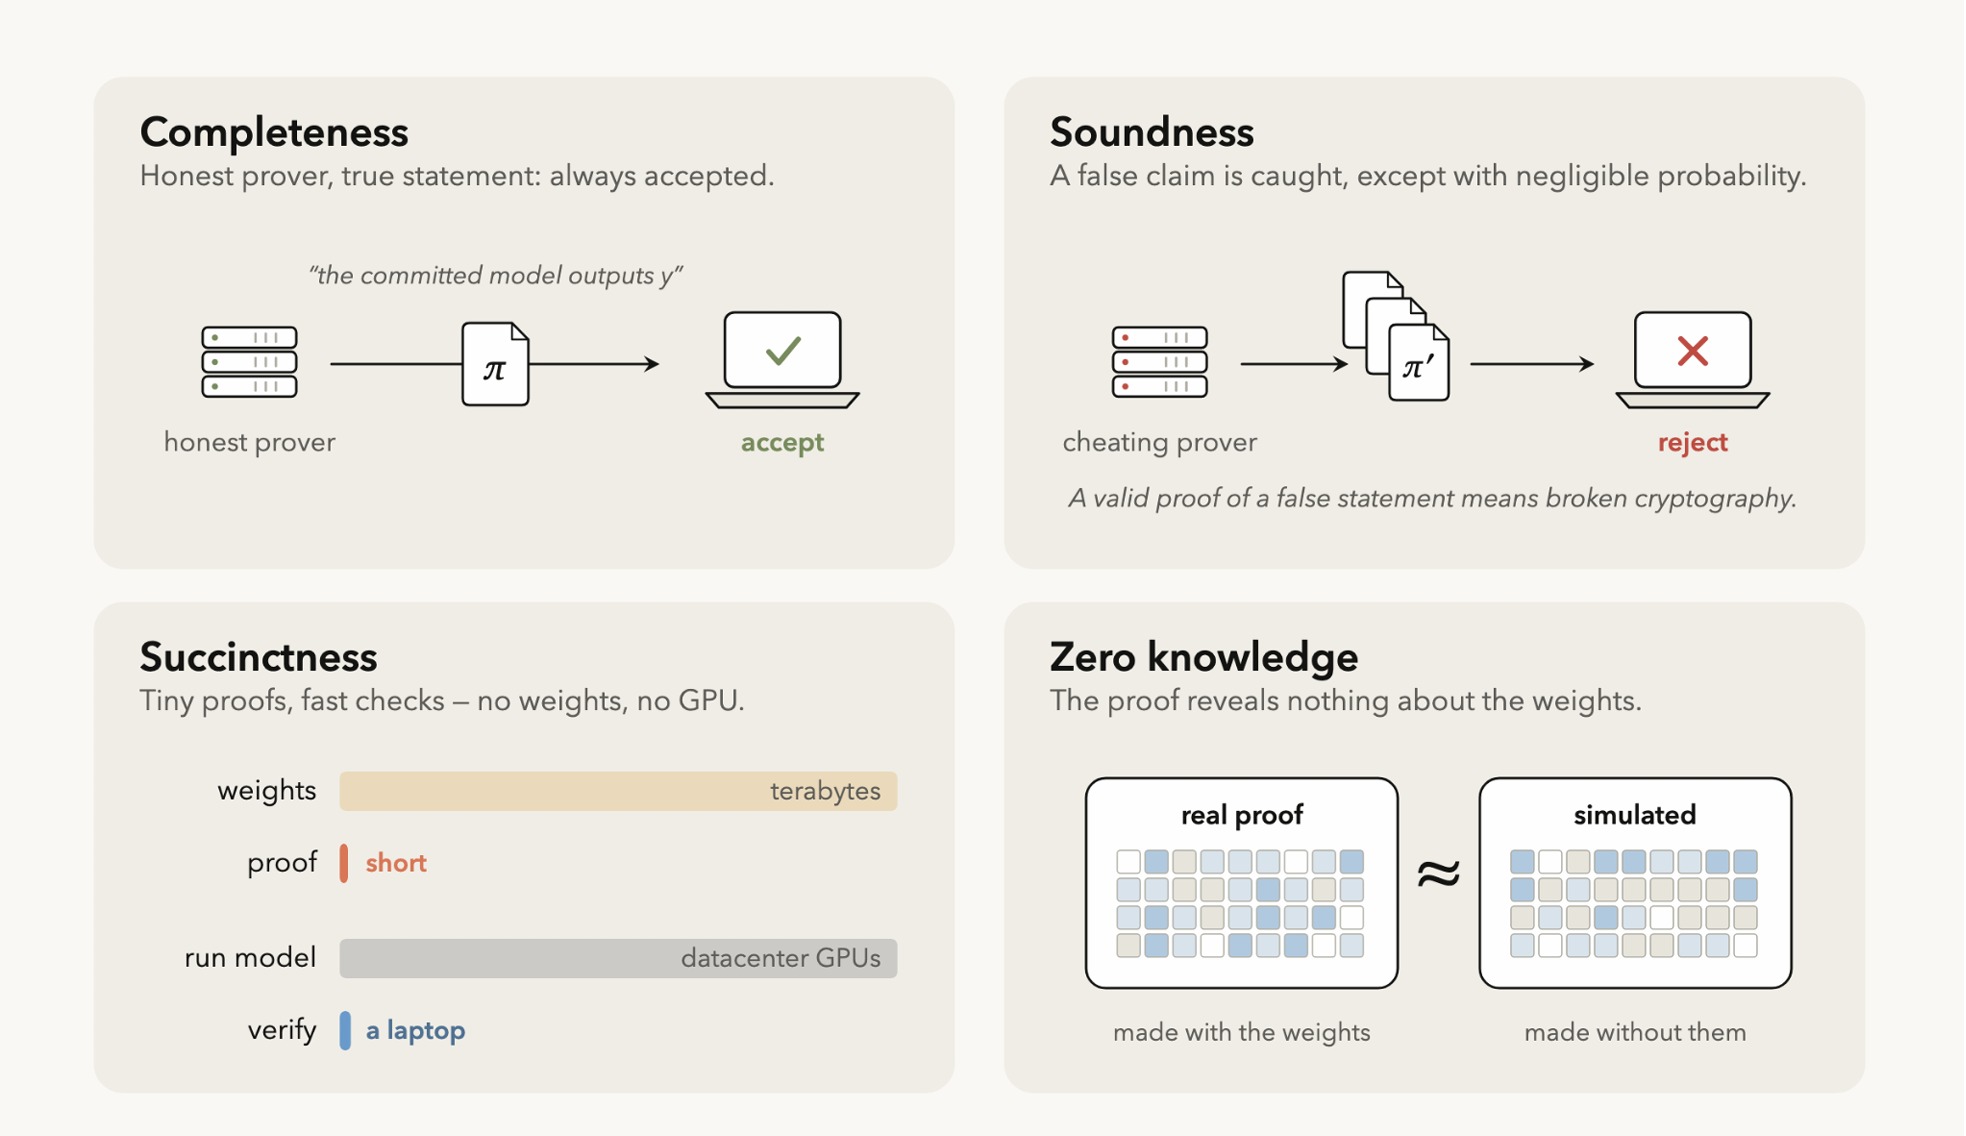
官方文章用四张卡片概括这套证明的性质:完备性保证诚实的服务方一定能生成可用证明;可靠性保证想拿假回答蒙混过关的一方几乎必然被抓,按仓库给出的口径,作弊成功率被压到 q/2^124 加 2^-101 的量级;简洁性让核验开销远低于重新跑一遍模型;零知识性则保证证明本身不泄露权重、中间计算值和专家选择。
这套设计特别契合混合专家模型。以被用于演示的 Llama 4 Maverick 为例,每层从 128 个路由专家中挑 1 个运行,单个 Token 实际激活约 170 亿参数,证明只需记录实际运行的专家并核验路由器没选错,工作量随激活规模而非总参数量增长。模型架构本身并不隐藏,被隐藏的是权重。
三件套:prover 出证明,C++ 管速度,Lean 管底气
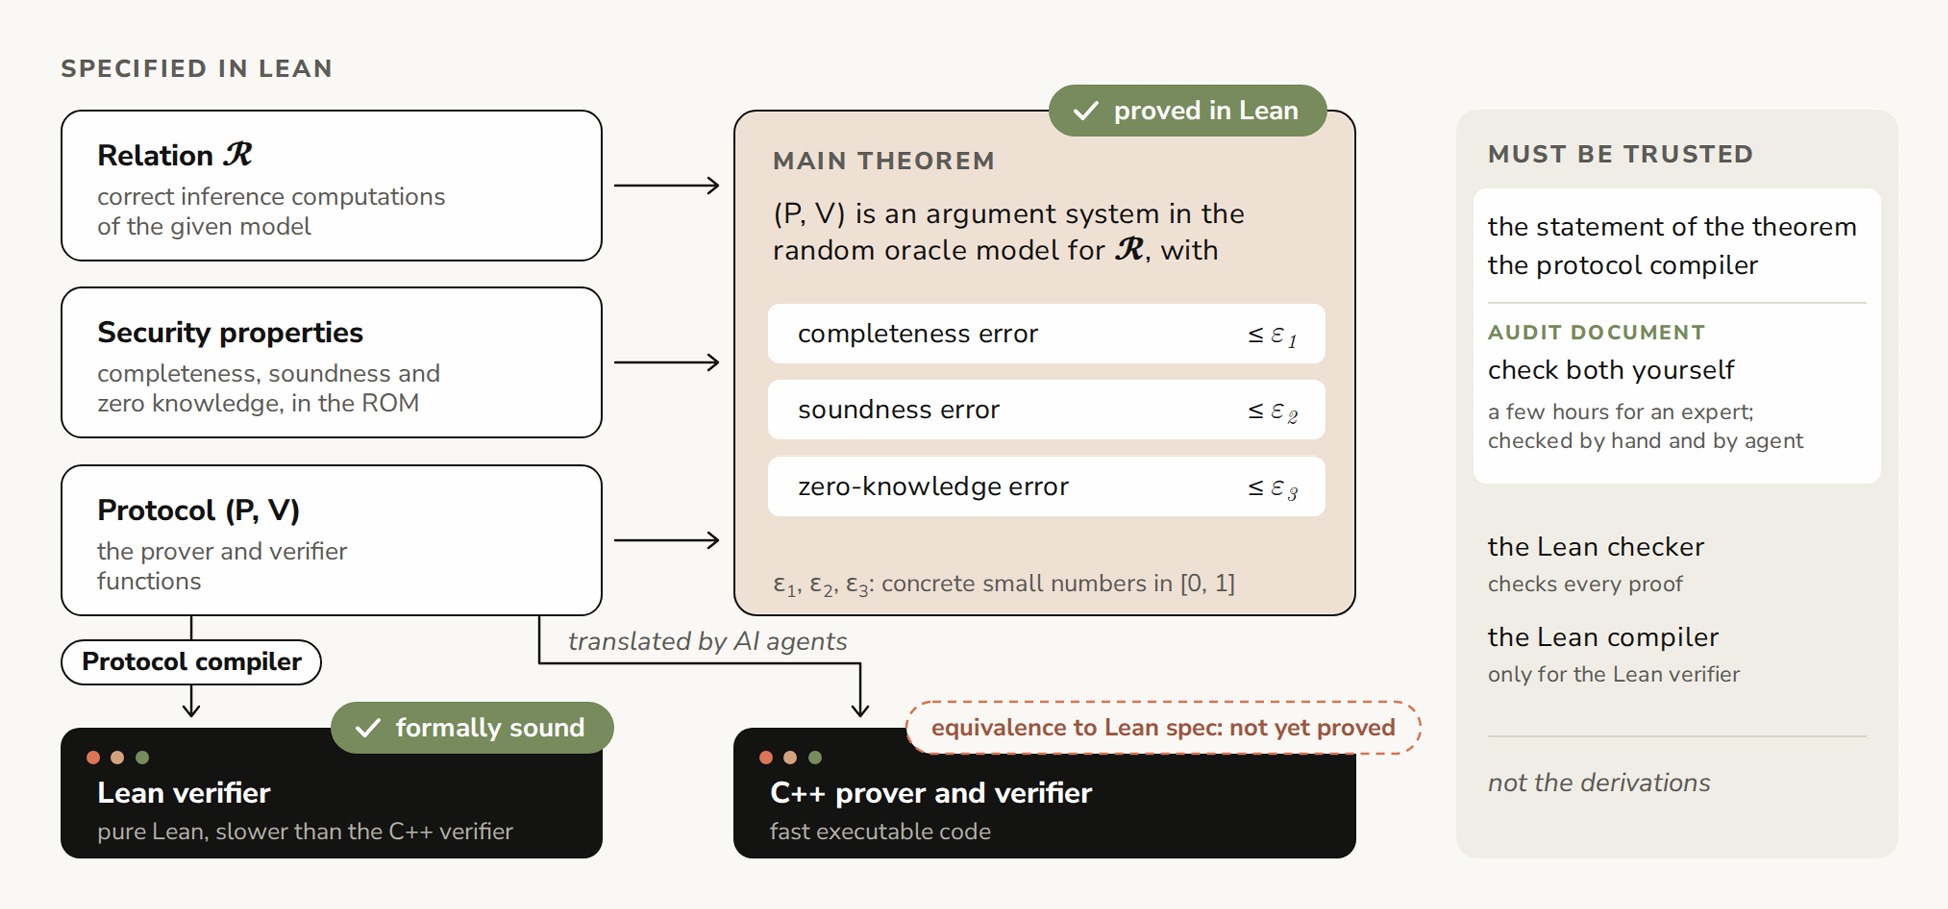
开源仓库里能看到三件核心工具:cp_commit 负责读入权重并生成承诺,cp_prove 在 GPU 上为成批请求生成证明,cp_verify 是一个只靠 CPU 运行的 C++ 验证器,一次核验一份证明。按官方口径,一份全尺寸证明在 24 核 CPU 上核验约需 17 秒,不需要 GPU,也不需要下载权重。
更有意思的是第二个验证器。由于 Claude 深度参与了这套系统的优化,Anthropic 自己也承认大模型在复杂系统里做的决策难以评估,于是把协议的安全命题用形式化验证语言 Lean 4 写成了机器可查的证明,还附带一个交互式可视化工具帮助审计。仓库文档显示,运行 Lean 验证器核验全尺寸证明约需 19 到 39 分钟、9 到 16GB 内存。不过仓库也写得很坦白:这是研究代码,经过测试但未经证明,Lean 保证的对象是协议和 Lean 版验证器,不是那份高性能的 C++ 实现,两者等价性尚未被证明。
仓库地址:anthropics/FlashProve,当前版本号 0.16.0,文档里连一条给编码代理用的复现指令都准备好了。
成本与边界:数十倍 GPU 开销与 1024 Token 的天花板
性能数字先看官方口径:在 4000 亿参数的 MoE 模型 Llama 4 Maverick 上,采用 4bit 量化权重,单张 H100 以 24 个请求为一批生成证明,吞吐约每秒 110 个 Token,每个 1024 Token 请求的证明文件约 19MB。生成证明的 GPU 开销约为用 vLLM 常规推理同一批请求的 70 到 95 倍;有第三方简报单独给出了约 72 倍的均值口径,该数字未经仓库侧复核,仅供参考。
账单还不止 GPU。按仓库文档,全尺寸运行需要约 232GB 权重驻留主机内存、最多约 330GB 内存与 245GB 磁盘,离线准备阶段耗时约 39 分钟,这些准备可以复用。作为对照,此前的开源方案为同一模型生成 1000 个 Token 的前向证明约需 14.3 小时,证明文件达 93.6GB(国内科技媒体口径,双方测试设置并不完全相同)。横向看,差距已经从数量级问题缩小到工程问题。
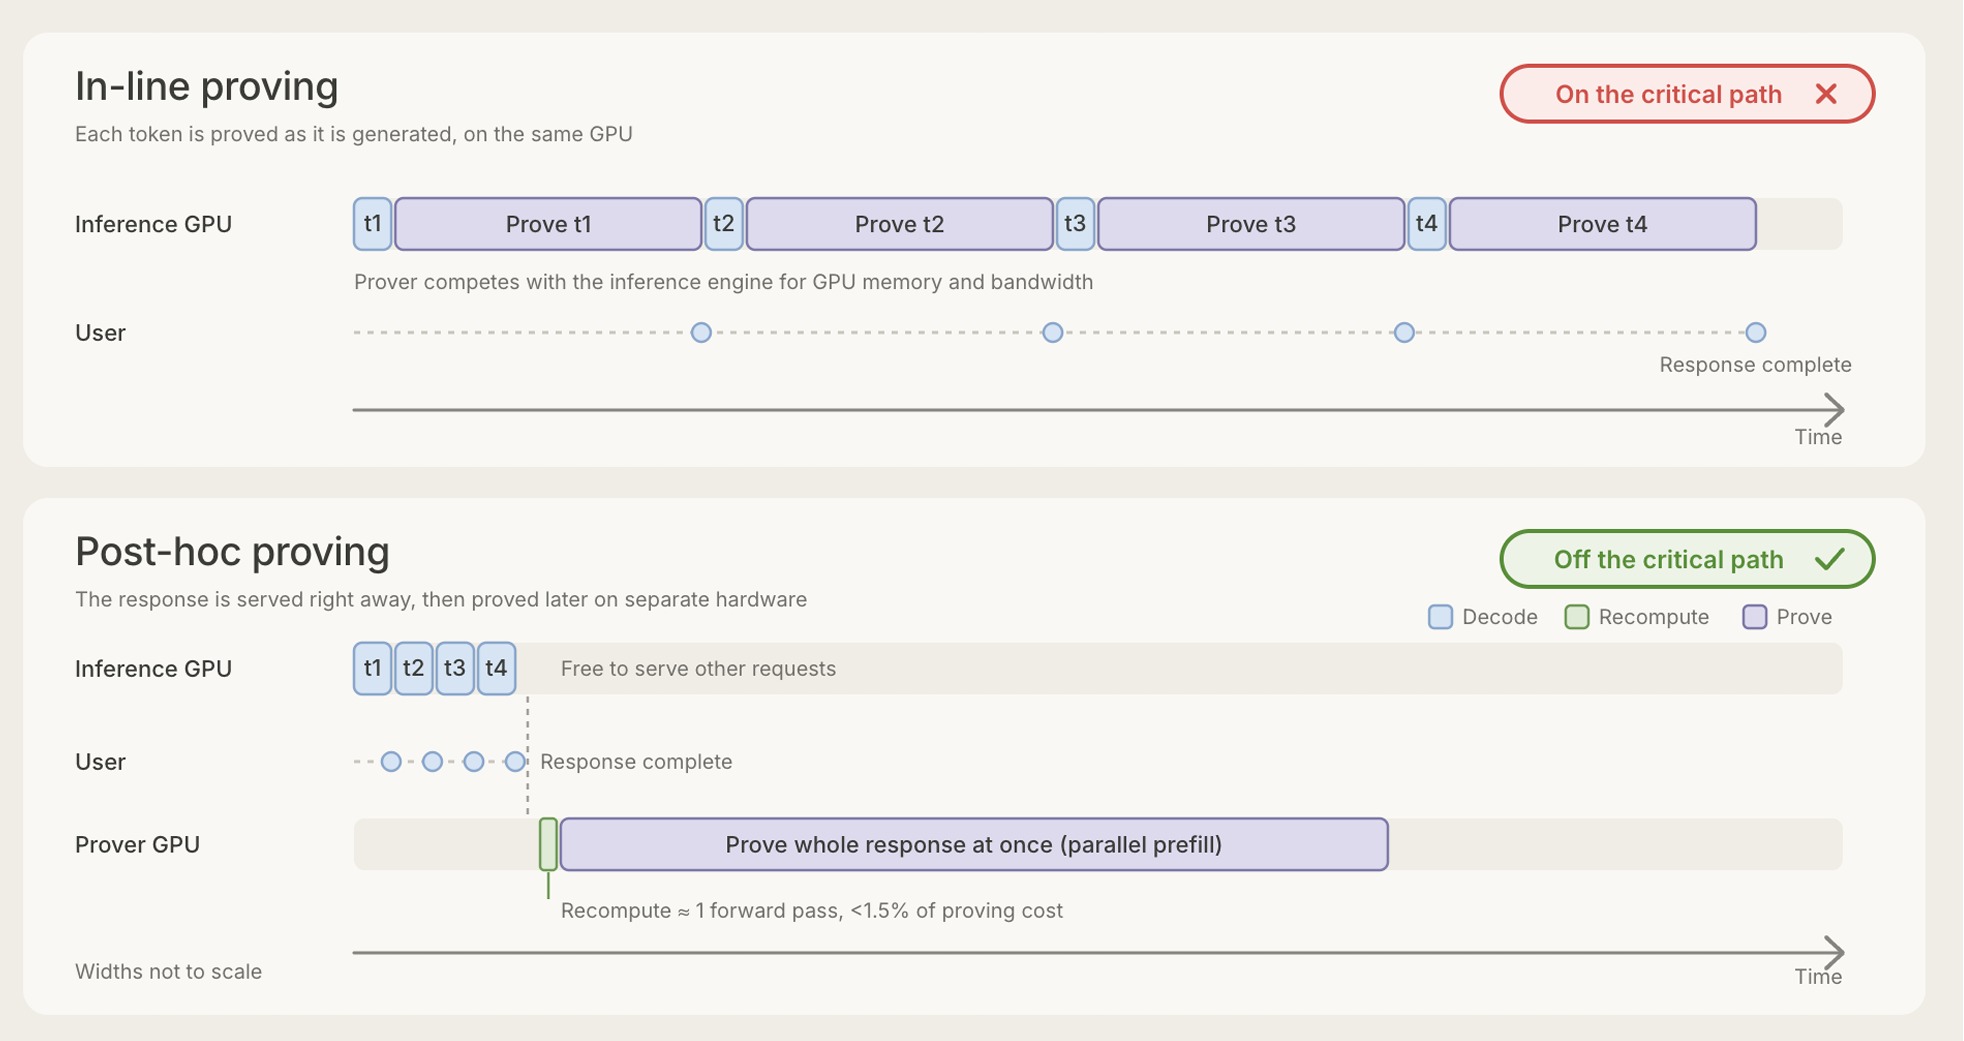
边界同样清楚。目前协议只支持 1024 Token 的上下文窗口,离前沿模型数十万级的窗口差得很远;它证明的是整数版模型在指定位置选择得分最高 Token 的结果,实际服务常用浮点推理和采样解码,出现不一致时还得先排除计算方式差异。事后证明的思路是先返回回答再补证明,这意味着恶意回答可能在核验结果出来之前就被用户读到了。批量处理时的零知识性也还没有拿到完整的形式化证明。
与 TEE 机密推理互补:一个防偷看,一个防调包
提到可验证 AI,绕不开基于 TEE 可信执行环境的机密推理路线。两条路线管的其实不是同一件事:TEE 把计算关进安全硬件,主要防的是服务方偷看用户数据和权重;zkSNARK 这类密码学证明主要防的是模型被调包、回答被篡改。今年已有 Tinfoil 的 Modelwrap 方案用安全硬件加权重承诺核验模型身份,也有以色列安全公司公布了面向大模型的零知识推理证明方案。Anthropic 自家产品目前走的是另一条路——给流量签名并在可信服务器上复核。
对普通用户来说,这项技术短期内不会有体感,毕竟没人愿意为一条回答付出近百倍的算力成本。但对通过路由服务接入多家模型的 Agent 编排方、对要出评测报告的独立机构、对有审计要求的企业客户,一份可以在 CPU 上十几秒验完的密码学证明,是把「你们用的真是这个模型吗」从口头承诺变成数学命题的第一步。报道称 Anthropic 暂无将其部署到自家服务的计划,项目定位就是阶段性进展,欢迎同行拿去改进。
网友评论
- 以后 API 中转站还怎么偷偷用便宜模型赚差价,建议先给自家流水线上一套自证清白。
- 70 到 95 倍的 GPU 开销,等于烧将近一百份电费买一张信任收据,企业客户可能都嫌贵。
- 有个细节挺有意思,系统是 Claude 参与写的,然后又用 Lean 让人类能审计它,AI 造完自己请人查账。
- 疑问:证明能确认是那个模型算的,但能保证回答内容是对的、没胡编吗?好像还是不能。
总结
FlashProve 的价值不在今天能不能用,而在把可证明推理的门槛拉低了一个数量级:证明生成从十几个小时压到秒级 Token 吞吐,证明文件从近百 GB 压到 19MB,核验从专用设备压到普通 CPU。开销、上下文长度和浮点解码三块短板都明晃晃摆在那里,短期更适合研究者接力而非业务接入。方向本身值得记一笔——当模型调包可以通过数学手段被抓包,模型服务这个行当的信任成本,就有机会真正降下来。
