一周前才正式亮相的美团 LongCat-2.5,如今连权重都放出来了。11 月 15 日,LongCat 团队在 Hugging Face 上架了这款 1.6 万亿参数智能体模型的完整 checkpoint,采用 MIT 许可,商用、修改、再分发全部放开,部署指南也一并给出。对普通用户来说,这是一次可以直接下载把玩的开源;对想自建智能体服务的团队来说,看点在于官方只给了 194 张华为昇腾卡的部署方案,英伟达 GPU 一个字都没提。
权重全量放出:MIT 协议意味着什么
先看规格。LongCat-2.5 是一款原生多模态混合专家(MoE)模型,总参数 1.6 万亿,每个 Token 激活约 480 亿,API 口径支持最高 100 万 Token 上下文、单次最长生成 12.8 万 Token。输入认文本、图像和视频,输出为文本,推理开关可自行拨动。与前代 LongCat-2.0 相比,这一代把视觉理解合了进来,定位是长链条智能体任务,尤其是编码。
MIT 许可的实际含义值得展开:下载之后可以自行检查、修改、微调、自托管和再分发,拿来接生产也没有额外授权门槛。试用入口同样开放——聊天界面在 longcat.ai,API 同时兼容 OpenAI 与 Anthropic 两种格式,官方点名可以直接接进 Claude Code、Codex、Hermes 这类智能体外壳。上线期价格折算下来约每百万输入 Token 0.27 欧元、每百万输出 Token 1.07 欧元。
背景方面,前代 LongCat-2.0 于 6 月底在超过 5 万块国产 AI 芯片组成的集群上完成训练;而在正式揭晓之前,LongCat-2.5 的早期版本曾以「Owl Alpha」的匿名代号在 OpenRouter 上跑过一阵,当时没人知道背后是美团。这家以送外卖闻名的公司把算力账本藏得这么深,本身就算个信号。
原生多模态:图像拆成 token 直接进主干
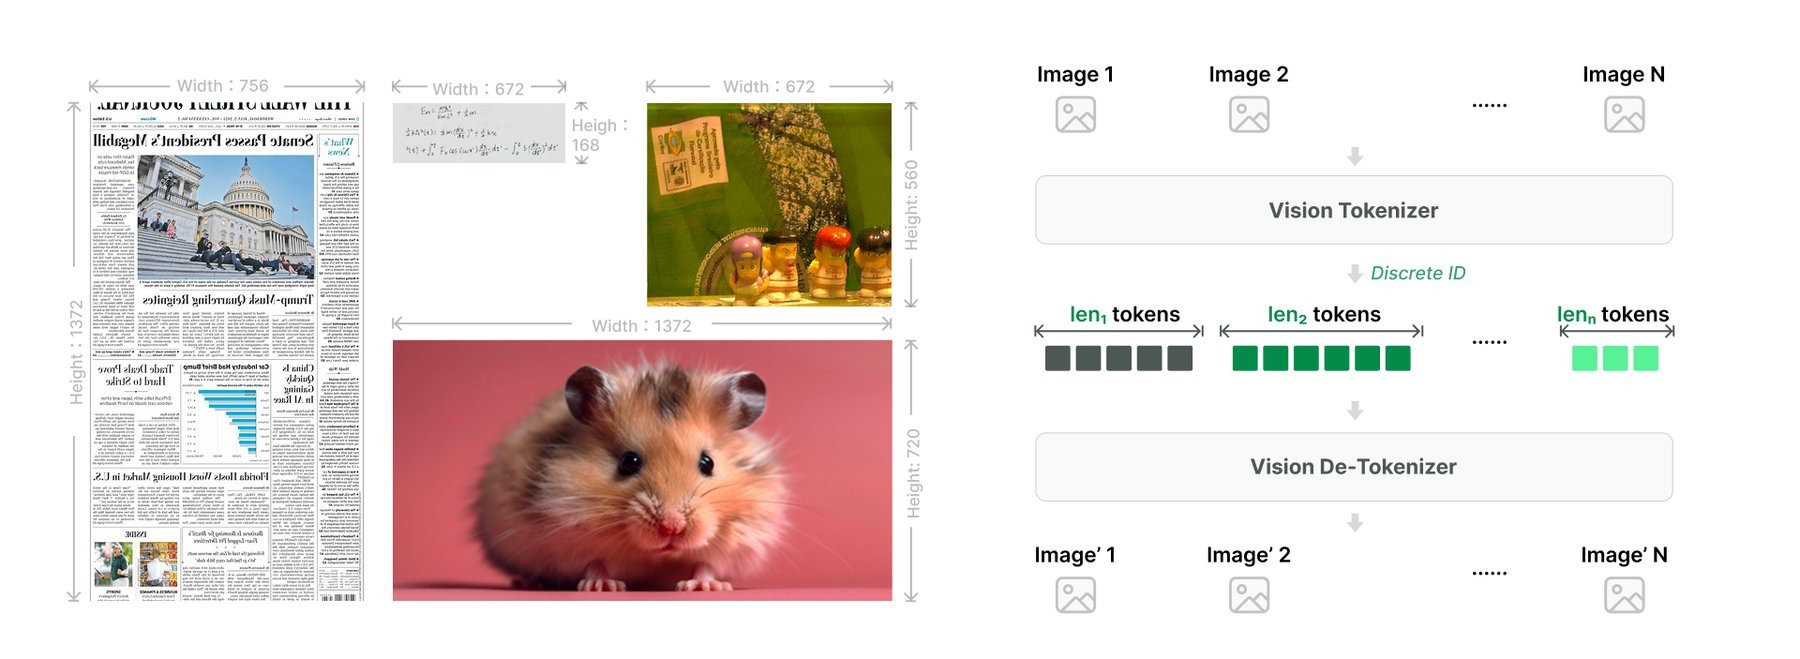
不少多模态模型是在事后外挂一个图像编码器,LongCat-2.5 走的是另一条路:把图像按原生分辨率拆成离散 token,与文本一起送进同一个主干处理,思路继承自内部研究模型 LongCat-Next。按官方说法,这种做法比拼接式的两套管线少一道缝,主要瞄准视觉编码、设计和 3D 这类任务。
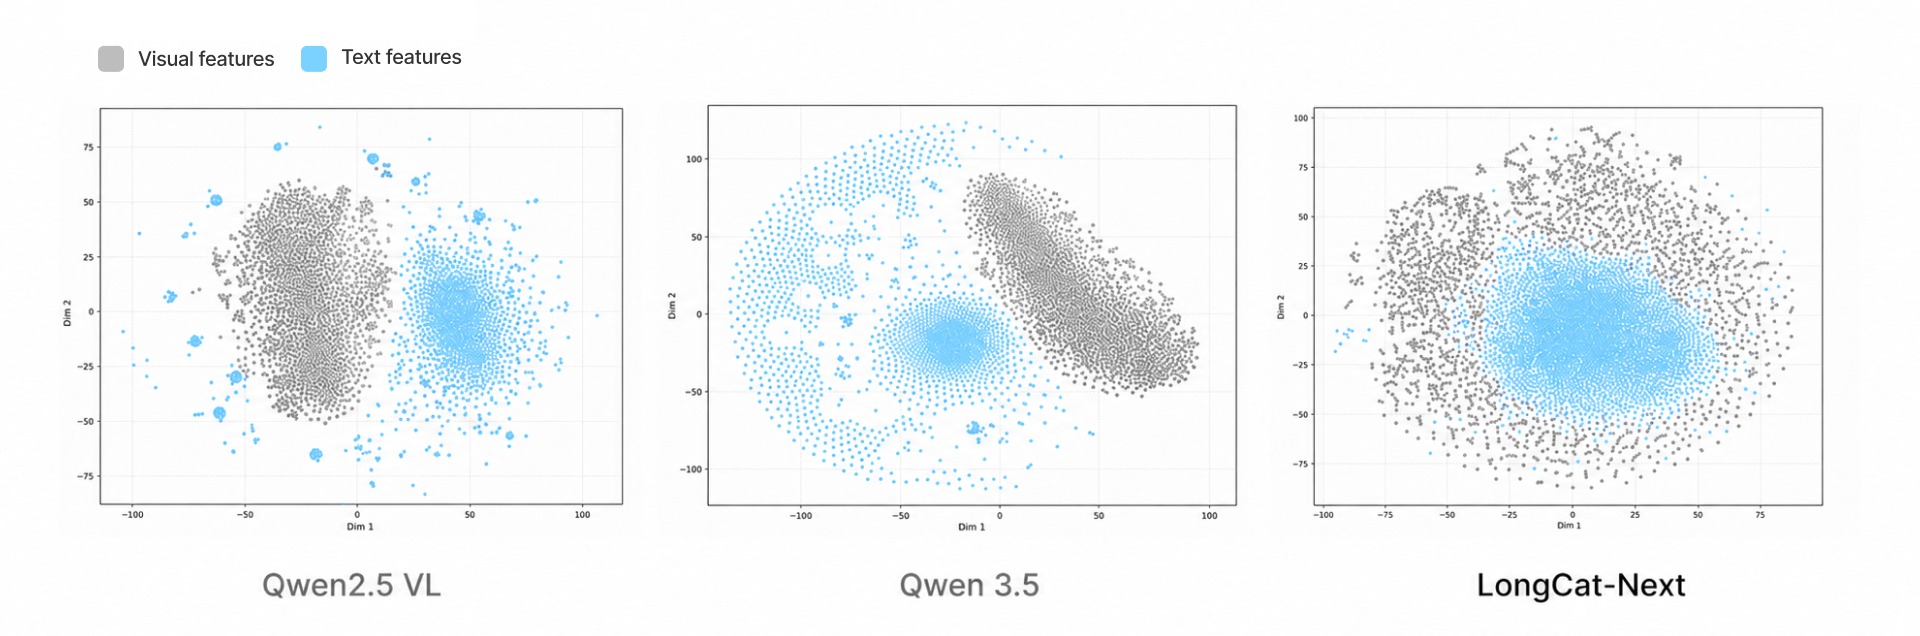
实际用下来这项能力的意义在哪?对要模型看界面截图、读懂架构图再写代码的智能体场景来说,视觉与文本在同一个语义空间里对齐,意味着模型不用在两套表征之间来回翻译。官方在模型卡里放出了视觉与文本嵌入的 t-SNE 对比图——在 LongCat-Next 的验证里,视觉特征与文本特征已经彼此咬合,而不是像外挂编码器方案那样泾渭分明。
跑分对照口径:贴近 Claude Opus 5,但自报成分要认清
按美团自己的评测,LongCat-2.5 在命令行任务基准 Terminal Bench v2.1 上拿到 88.4 分,同表 Claude Opus 5 为 89.1、GPT-5.6 Sol 为 88.8,榜首 DeepSeek-V4.1-Flash 为 90.6——差距已经缩到一分之内。更难的 Terminal Bench v4.0 上它得 38.5 分,压过 GPT-5.6 Sol 的 37.3,但离 Opus 5 的 53.9 还有距离。
进步幅度最猛的是 DeepSWE(真实仓库修 bug 基准):从上一代的 9.7 分跳到 64.6 分,不过对照表里 DeepSeek-V4.1-Flash 的 74.2 与 GPT-5.6 Sol 的 72.7 仍在它之上。网页搜索基准 BrowseComp 它拿了 91.9 的表内最高分,但这项是在美团自家测试环境里跑的。需要提醒的是,这些均为厂商自报跑分,独立第三方验证尚未出现,且对照表没有收录最新的 Claude Opus 5.5 与 GPT-6.1 Sol;表内未带星标的成绩均为美团自测口径,仅供参考。
194 张昇腾卡与 W4A4 量化:部署方案一并给出
这次开源最有信息量的一份附件,是官方自托管部署指南:参考生产集群由 194 张华为昇腾 Atlas A2 组成,其中 2 张负责原生图像处理、64 张负责提示词摄入、128 张负责自回归生成,全程没有给英伟达 GPU 留配置。指南还提到采用分离式的编码—预填充—解码架构,推理栈基于 SGLang 的 NPU 版本。
撑起这套方案的关键是量化。LongCat-2.5 把专家权重与激活值压到 4 比特(W4A4),这是国产芯片能原生处理的精度。与 8 比特版本对比,线上压测显示预填充吞吐提升 43.3%、解码吞吐提升 42.77%,官方还给出 TTFT 降低 15.91%、TPOT 降低 19.72% 的口径,任务精度与未量化模型持平。4 比特版本单独开了仓库,想复现的团队可以直接照着搭。
RL 训练防作弊:断网、删缓存、专人查卷
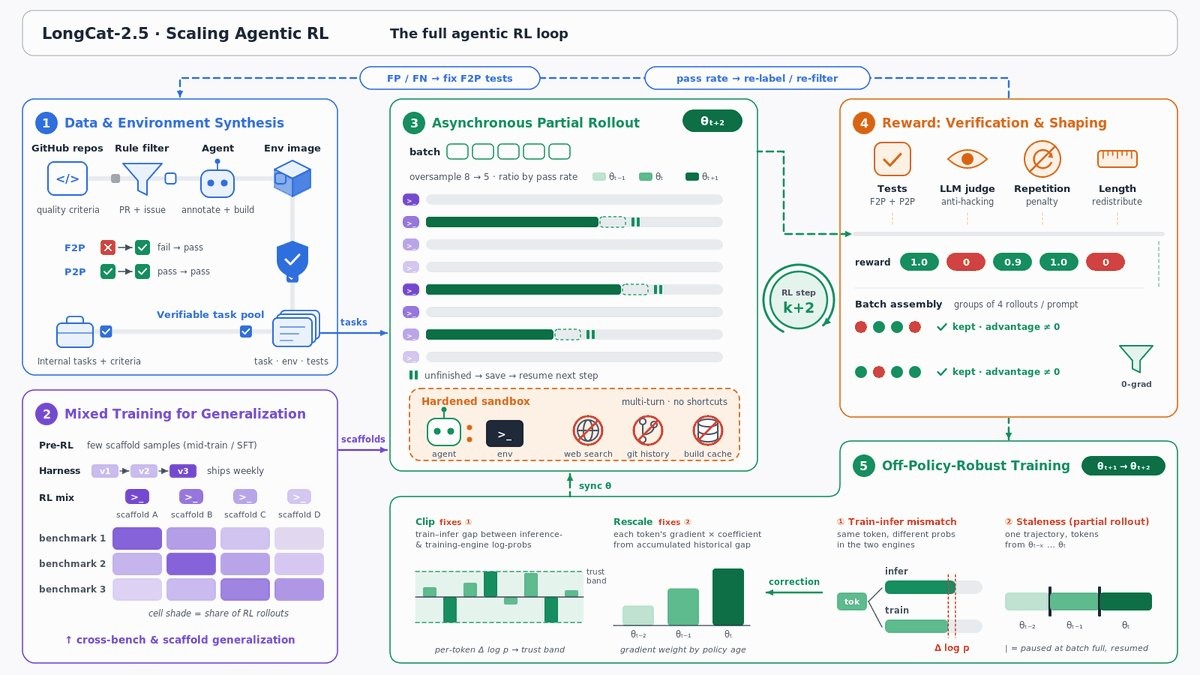
智能体模型最容易出的问题,是「看起来会做题」——绕过测试、投机取巧。为了逼模型真解题,团队把强化学习任务直接取自真实的 GitHub 拉取请求与复现的智能体失败案例,训练沙箱完全断网,Git 历史与构建缓存全部清掉,再部署一个自动检查的模型逐份审查解法里有没有钻沙箱空子的「作弊解」。
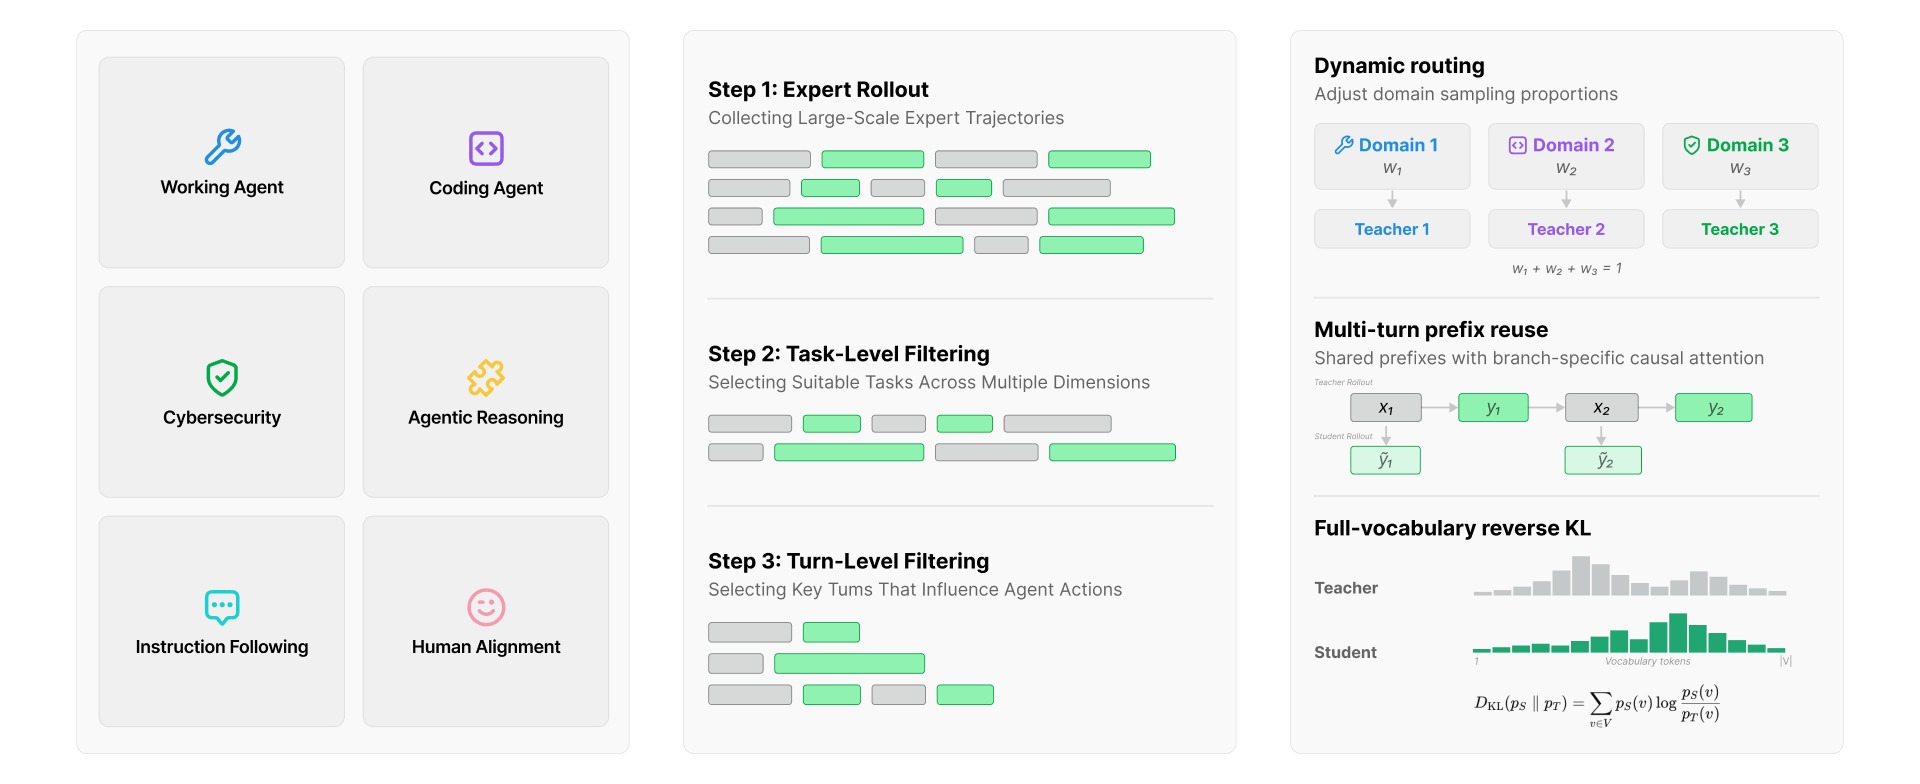
能力来源上,LongCat-2.5 还从多个专长教师模型蒸馏,覆盖智能体操作、形式化推理与多轮对话,蒸馏用的是全词表 KL 方式。这套「断网+删历史+查卷」的组合拳,跟当下榜单分数越好看越要怀疑环境的氛围正好对上了——想验证它有没有水分,照着文档把环境搭起来就能复核。
网友评论
- 「MIT 协议加 4 比特部署指南,这诚意没得说,周末就去下权重跑一跑。」
- 「跑分表里没有 Opus 5.5 和 GPT-6.1,赢的都是上一代,这波属于田忌赛马吧。」
- 「194 张昇腾卡什么价位?小团队怕是连电费都扛不住,还是先看 API 价格。」
- 「断网删 Git 历史这套防作弊流程建议全行业推广,别家榜单也该按这个标准来一遍。」
总结
对普通用户来说,longcat.ai 的网页入口和兼容双格式的 API 已经够用;对企业与开发者来说,MIT 协议加完整的昇腾部署文档,等于把「自建万亿参数智能体」的图纸公开了。参数规模只是这次开源的一半,另一半是把「离开英伟达也能训出、部署得起旗舰级智能体模型」从口号做成了可复现的文档。接下来值得盯两件事:4 比特量化精度说法有没有第三方复现,以及这套部署方案会不会被别家抄进自家文档。
