先把时间点掰正:Qwen3-TTS 不是这个月才冒出来的新模型。阿里 Qwen 团队官方仓库的 News 栏写得很清楚,2026 年 1 月 22 日开源,博客、技术报告、权重和 Demo 同期刊出;网上把它记成 11 月新发布的稿子,多半是二次转载时把日期写错了。它最近又被翻出来讨论,是因为社区在消费级显卡上把实时合成跑通了,GitHub 星标从 4 月的一万出头涨到现在的一万四千多。对做语音助手、配音、有声书或者数字人的团队来说,这套东西值得重新拆一遍,而且要比发布当天看得更细。
一套权重干完四件事:这次究竟开源了什么
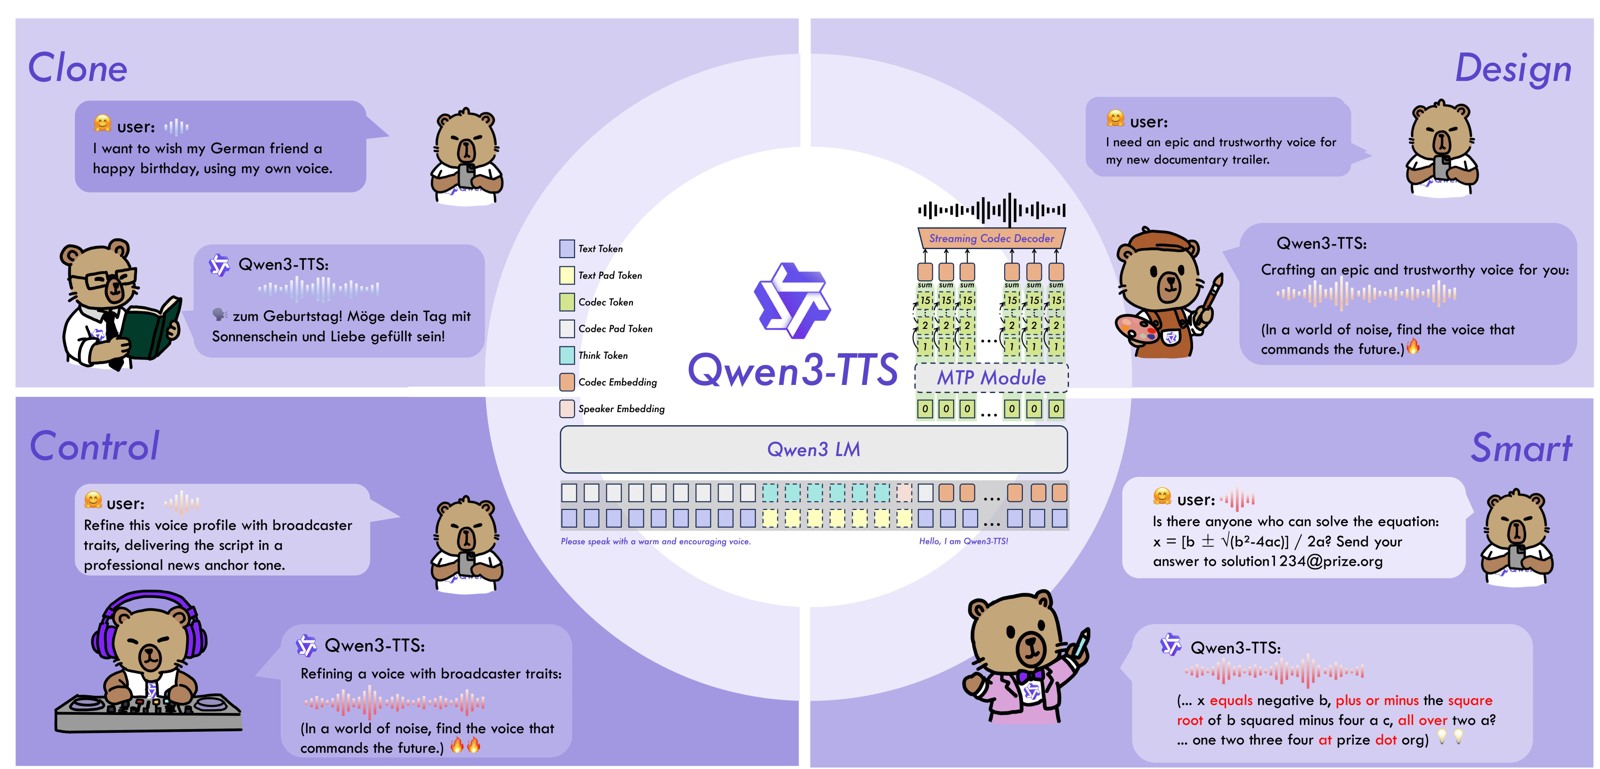
语音合成这两年不缺模型,缺的是把几件常用能力放进同一套权重、还肯把权重交出来的。Qwen3-TTS 一口气给了五款 12Hz 模型和一个独立的语音编解码器:1.7B 档有 VoiceDesign(按文字描述造音色)、CustomVoice(九种预设音色加风格指令)、Base(三秒参考音频克隆,可拿去微调),0.6B 档有 CustomVoice 和 Base,外加 Qwen3-TTS-Tokenizer-12Hz。全部支持流式生成,指令控制只在 1.7B 的两个上层模型上开放。
覆盖范围是十种主流语言——中、英、日、韩、德、法、俄、葡、西、意,外加北京话、四川话这类方言音色。更实在的是许可证:仓库里躺着完整的 Apache 2.0 LICENSE 文件,权重、推理代码、微调脚本、技术报告 PDF 一起放出来,Hugging Face、ModelScope、在线 Demo 和阿里云 DashScope 实时 API 都有入口。这跟只给一个 Playground 让人调接口的「开源」完全是两回事,商用和自托管都不用先去谈授权。
有个容易踩的坑得提前说:技术报告的表格里列了十个模型,还出现了 25Hz 系列和 VoiceEditing(语音编辑)。但 README 里明写「报告里提到的其他模型将在近期发布」,目前真正能下载的是上面那五款 12Hz 模型加 tokenizer。把论文表格当成下载清单,会白等一场。另外官方博客只说「低至 97 毫秒」,报告里其实分得更细,后面会讲清楚。
它跟本站之前聊过的实时语音模型走的也不是一条路。主流高质量 TTS 常见做法是「语言模型先生成语义 token,再交给扩散模型或 DiT 还原声学频谱,最后过声码器」,CosyVoice 就是代表。Qwen3-TTS 想做的是把语义和声学塞进同一个自回归过程里,少了中间那道传话环节。
12.5Hz、十六层码本:先把语音压成一串整数
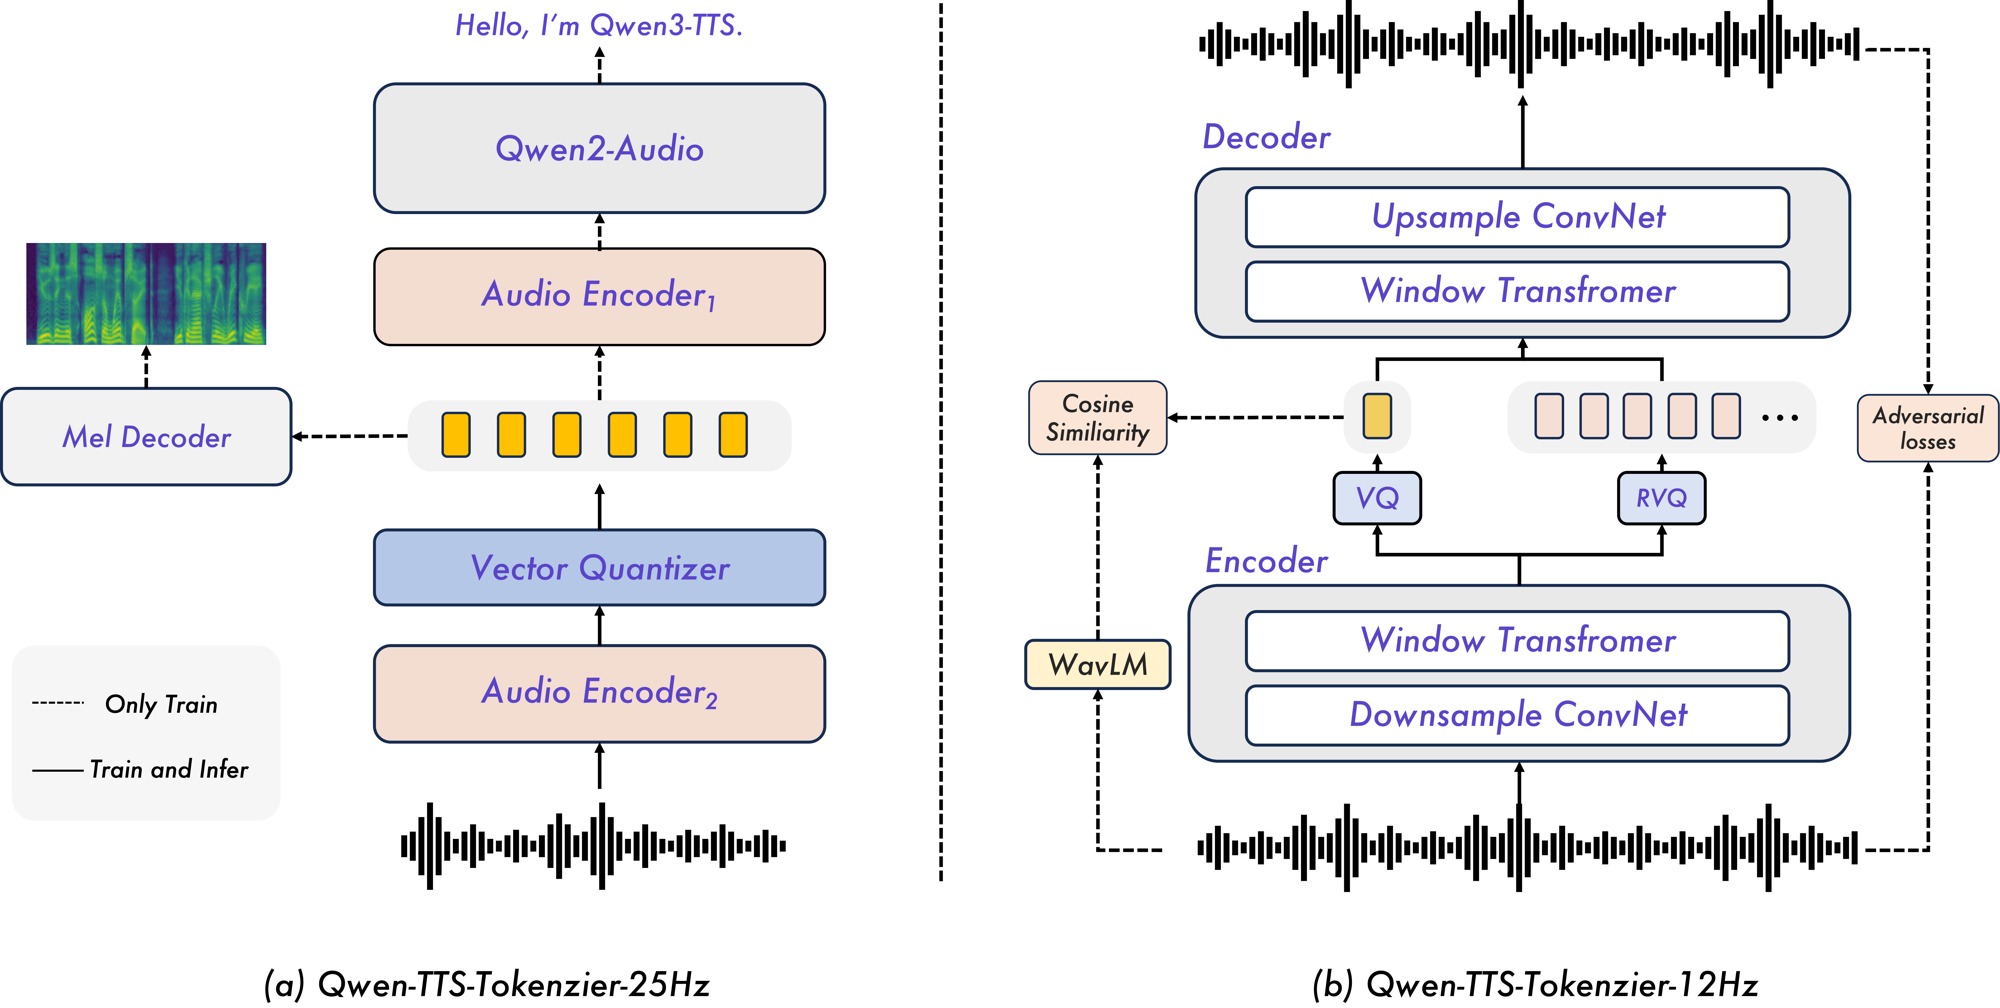
要理解 97 毫秒,得先看它怎么表示声音。团队在报告里做了两套 tokenizer,走的是两条思路。
25Hz 那套是单码本:以 Qwen2-Audio 编码器为底,先继续用语音识别任务预训练,中间插入重采样层和向量量化层;第二阶段再接卷积式的 mel 谱解码器,把声学信息硬灌进 token 里。还原波形靠分块的 Diffusion Transformer 加 Flow Matching,配一个改过的 BigVGAN,解码时按固定长度分块,注意力感受野限制在当前块、回看三块、前瞻一块。这套设计语义表达不错,也方便和 Qwen-Audio 对接,但团队自己评价是:单码本撑不住超低延迟场景。
真正撑起流式的是 12Hz 那套。它把语音拆成十六层离散码本,帧率 12.5Hz:第一层由 WavLM 当教师引导,专门记「说了什么」,后面十五层用残差向量量化逐层补上音色、韵律、情绪和环境声这些细节。训练走 GAN,生成器直接在原始波形上抽取并量化,判别器管自然度,再加多尺度 mel 谱重建损失约束时频一致性。编解码器全部做成因果结构,编码器逐帧吐 token 不前瞻,解码器边收边还原。
码本堆到十六层之后,反而不需要复杂的还原模块了:一个轻量级因果卷积网络就能把 token 变回波形,说话人向量抽取和扩散模型都省掉。有个直观的折算在技术解析里流传过——五秒语音大约压成十六层乘六十帧个整数 token,每秒只有十几帧要算,这正是首包能赶在百毫秒内出来的物理前提。
官方在 LibriSpeech test-clean 上测了重构质量:PESQ 宽带 3.21、窄带 3.68,STOI 0.96,UTMOS 4.16,说话人相似度 0.95。最后这项最值钱,说明压得这么狠,声纹特征基本没丢。当然这组数同样是团队自己测的,跟真实素材里的口音、混响、背景音乐还不是一回事。
双轨 LM 加 MTP:97 毫秒是怎么挤出来的
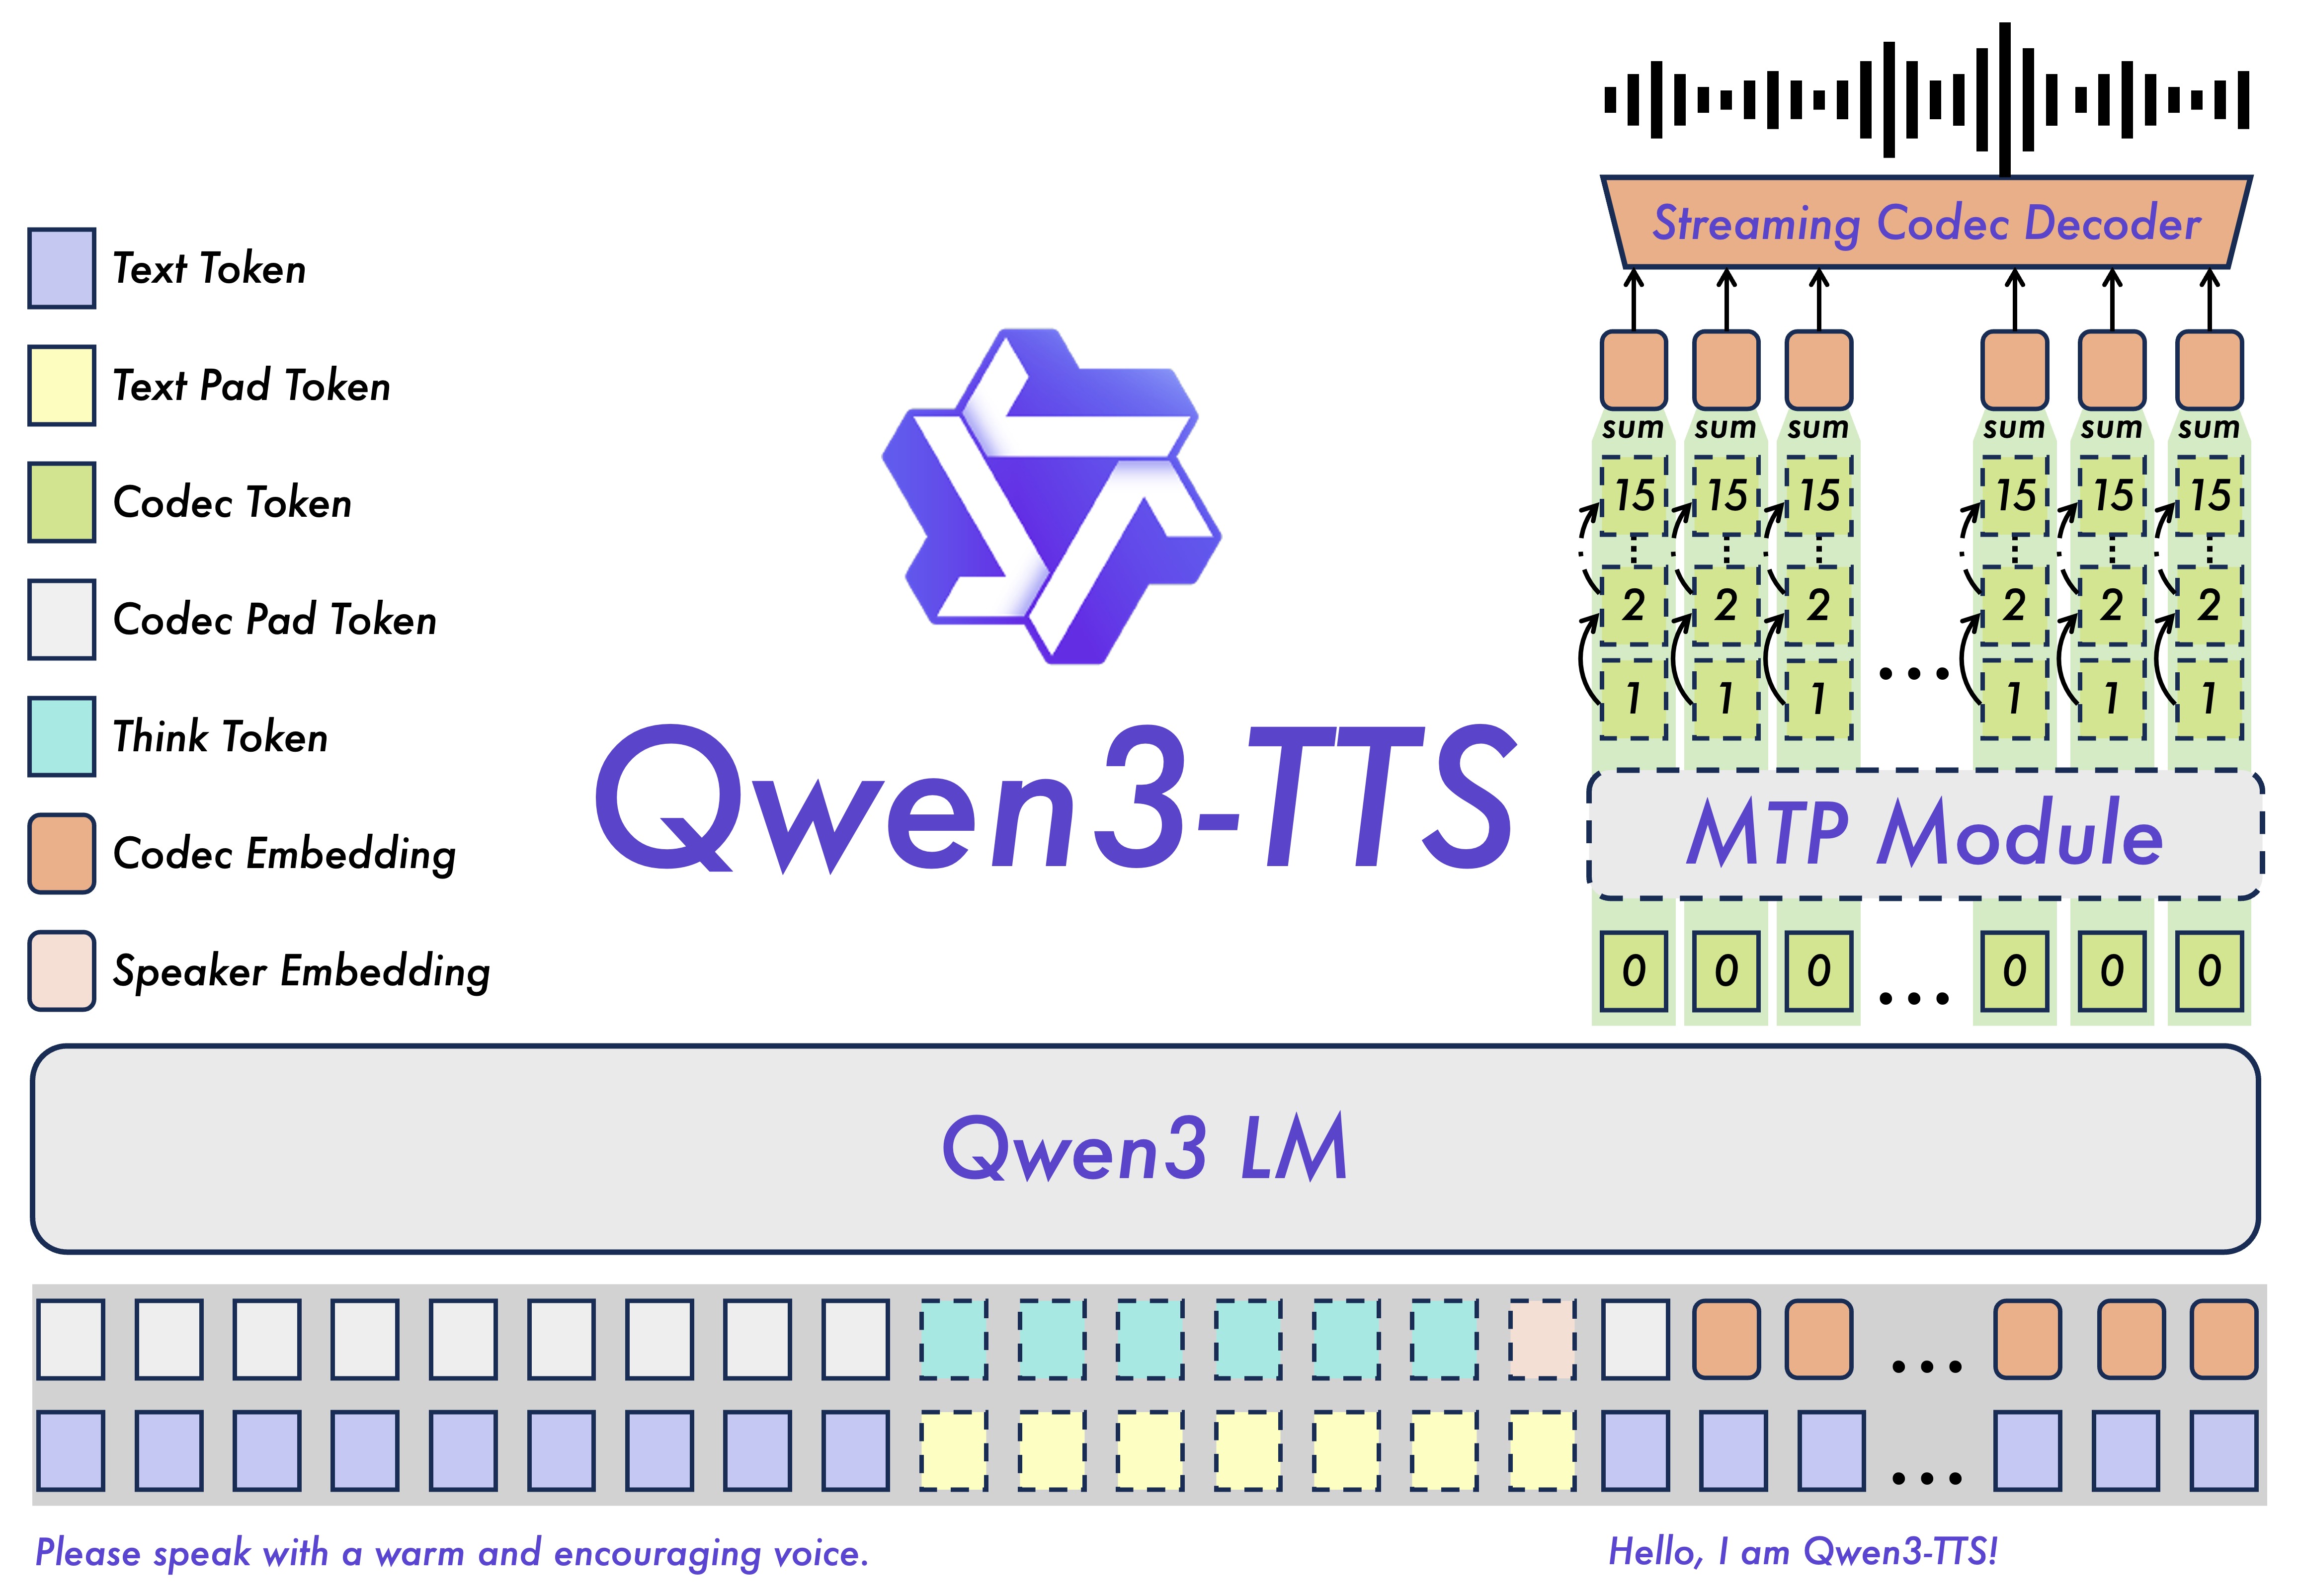
光有高压缩 tokenizer 还不够,模型得敢在文本没写完时就开口。Qwen3-TTS 用 Qwen3 系列语言模型做主干,文本走标准 Qwen tokenizer,语音走上面那套 tokenizer,另外联合训练了一个可学习的说话人编码器来稳住身份。
所谓 Dual-Track 双轨,是把文本 token 和声学 token 沿通道维拼在一起:每收到一个文字 token,模型立刻预测对应的声学 token,再交给 Code2Wav 还原成波形,不必等整段文本规整完。多码本序列不好一次预测,于是加了 MTP(Multi-Token Prediction)模块专门建模层间关系,第一个 codec 帧到手就能开始出声。同一个模型因此既能流式也能非流式,不用为两种场景各训一套。
延迟数字这里必须较真。官方博客写「端到端合成延迟低至 97ms」,技术报告的引言给了完整口径:首包延迟 0.6B 版 97 毫秒、1.7B 版 101 毫秒,且是流式文本输入配流式音频输出的理想条件。它不含网络往返、并发排队和前端文本处理,也不是「说完一整句到出声」的总时长。如果你正打算给实时客服或语音助手做技术选型,按 97 毫秒写进 SLA 之前,最好先在自己的显卡和并发量下压一遍。
不过方向是对的。过去做实时语音,延迟预算一大半花在等模型攒够上下文上;把首响从「整段级」降到「字级」,游戏 NPC、同传播报、边说边出声的助手这些场景才谈得上可用。训练侧也下了本:报告写的是超过五百万小时、覆盖十种语言的语音数据。低延迟换来的代价同样直白,流式生成在长句自然度上通常要让一点,所以 1.7B 和 0.6B 的分工才被设计成「极致效果」对「效率均衡」。
克隆、设计、控制:一句话捏出一条声线
三种玩法对应三类模型,用起来是三套接口。Base 最朴素,给一段三秒参考音频和对应文本,就能照着声线念新内容;参考音频支持本地路径、URL、base64 或者数组。只想要个大致音色、懒得标文本,可以开 x_vector_only_mode,但官方也提醒质量会掉。同一个角色要反复出场,用 create_voice_clone_prompt 把特征抽一次存起来,后面每句直接复用,省掉重复编码。
VoiceDesign 是最有辨识度的那个。不用提供参考音频,写一段自然语言描述就行:性别、音高、语速、口音、情绪、人物背景都能写进去。官方样例里既有「高亢男声、近乎喊叫地宣布开源」这种戏剧化指令,也有「带英音的中年女教授」「哭腔浓烈的古装台词」,甚至给角色编了整段履历再让它说话。CustomVoice 则走稳妥路线,九个预设音色各有母语:Vivian、Serena 是中文女声,Uncle_Fu 是低沉男声,Dylan 带京腔、Eric 带川味,Ryan 和 Aiden 是英文男声,Ono_Anna 是日语女声,Sohee 是韩语女声。官方建议让每个音色先说自己的母语,跨语言当然也支持,只是效果不一定最好。
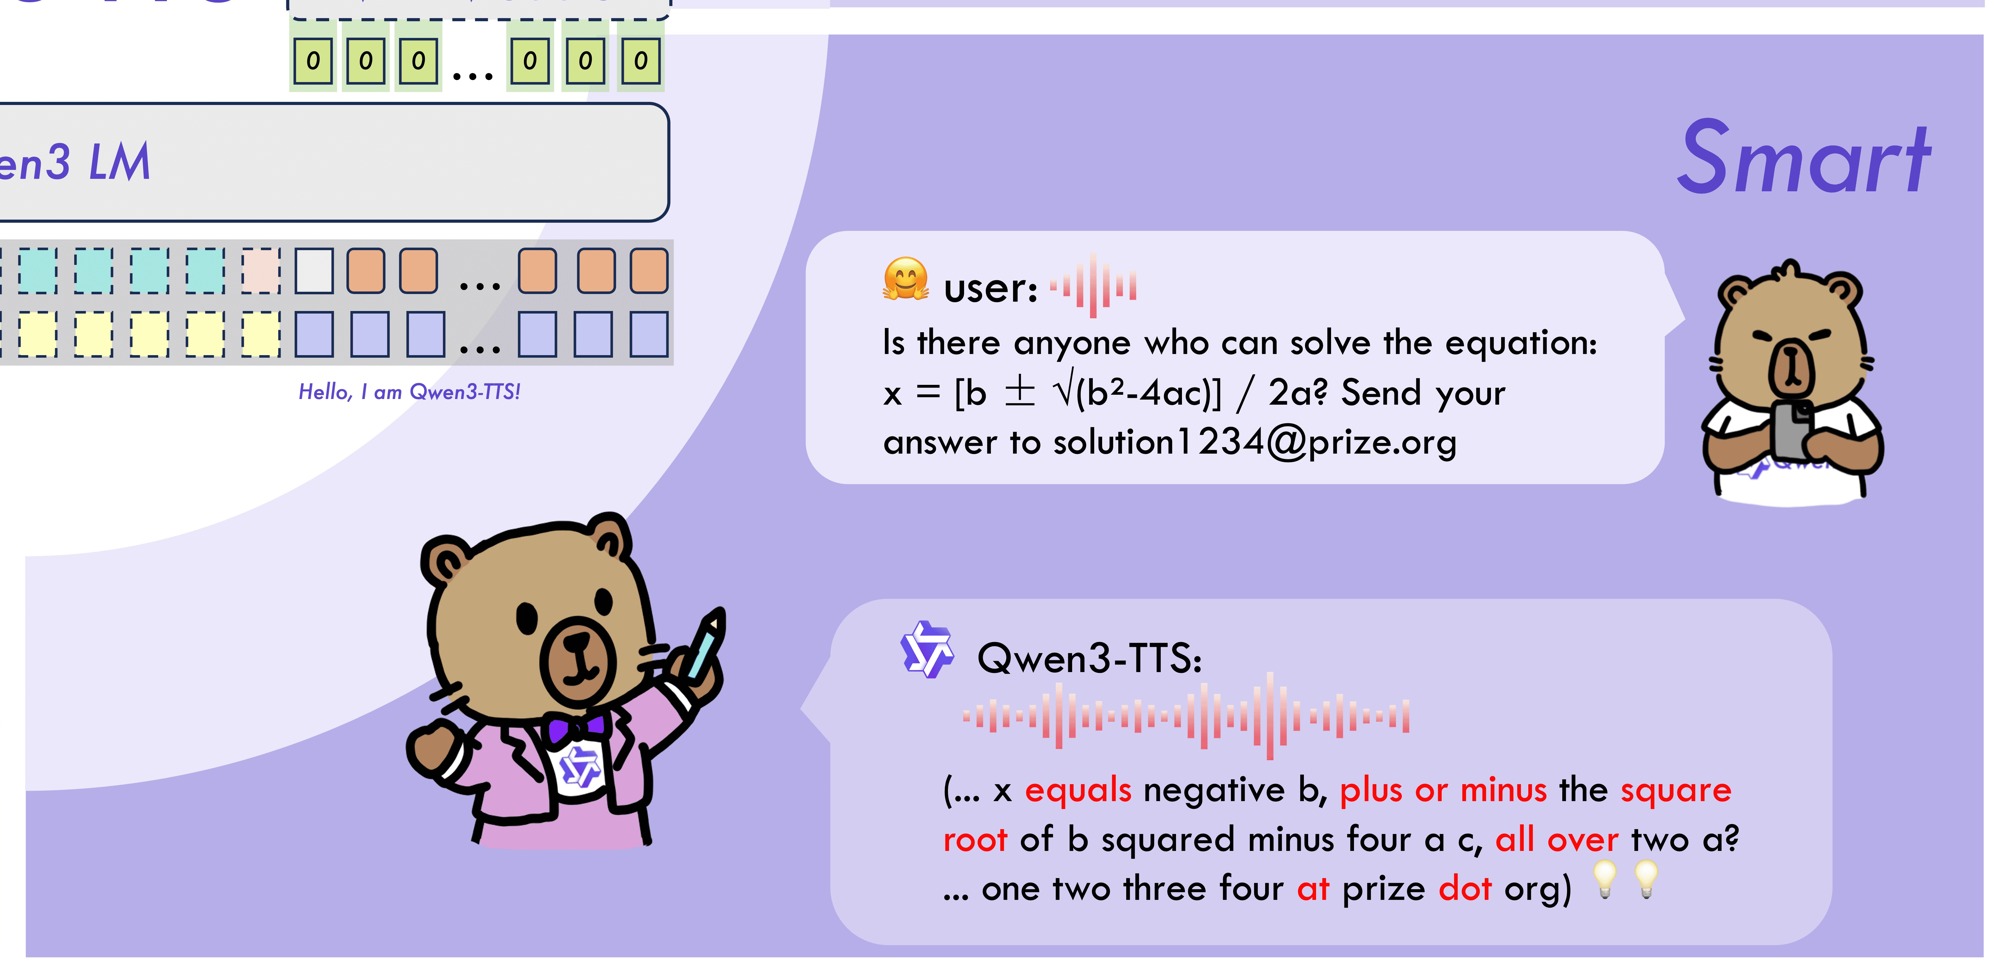
控制粒度落在 instruct 参数上,一句「用特别愤怒的语气说」「特别小声地悄悄说」就能改风格,模型还会顺着文本语义自己调节奏和情绪。文本鲁棒性这块做得挺细:拼音标注、生僻字、数学公式、颜文字混排都给了样例,报告里也把它当成一项独立能力。工程上还有个讨巧的组合——先用 VoiceDesign 合成一小段符合人设的参考音,再喂给 Base 建可复用 prompt,后面几十句台词就能保持同一条声线,做多角色长对话不用每次重新抽特征。
本地跑起来的门槛不高。Python 3.12 环境里 pip install -U qwen-tts 就能装,加载时按模型名自动下权重,国内也可以先用 modelscope 命令手动拉到指定目录。官方给的三个函数 generate_custom_voice、generate_voice_design、generate_voice_clone 各自对应一种任务,都支持批量传入文本、语言、音色和指令。vLLM 这边给了 day-0 支持,走 vLLM-Omni 的离线推理示例,在线服务官方写明后续补上;想直接上云,DashScope 按预设音色、克隆、音色设计分了三条实时 API。据外媒整理的官方口径,0.6B 大约要 3.5 到 4GB 显存、1.7B 要 5 到 6GB,一张消费级卡就能覆盖。
跑分摊开看:哪些赢了,哪些其实没赢
官方 README 把评测原表全贴了出来,这比只看博客里那几句「SOTA」有用得多。评测条件是 bfloat16 推理、max_new_tokens 2048,Seed 与 InstructTTS-Eval 用 language 自动判断,其余测试集显式指定语言。
先看确实硬的。Seed-TTS 零样本克隆集上,12Hz-1.7B-Base 中文词错率 0.77、英文 1.24,英文是同组最低;对照表里 Seed-TTS 是 1.12 和 2.25,F5-TTS 是 1.56 和 1.83,MiniMax-Speech 是 0.83 和 1.65。十语种集上官方报的平均词错率 1.835%、说话人相似度 0.789,整体压过 MiniMax 和 ElevenLabs。跨语言克隆里,英译中混合错误率 4.77,优于 CosyVoice3 的 5.09。可控性方面,指令驱动生成在 InstructTTS-Eval 拿到 75.4 分,官方称音色设计模型的指令遵循和表现力超过了闭源的 MiniMax-Voice-Design;连续十分钟合成的词错率中文 2.36%、英文 2.81%,单人多语言指令平均词错率 2.34%,长文本没崩。
翻到逐语言表格,领先就没那么整齐了。同一张多语种表里,日语词错率 3.823 高于 MiniMax 的 3.519,德语的 1.235 输给 ElevenLabs 的 0.572,葡萄牙语 1.526 也不如 ElevenLabs 的 1.331;跨语言的日译中 3.43 同样落后 CosyVoice3 的 3.05。中文零样本那一行更微妙,CosyVoice3 的 0.71 比 0.77 还低一点。外媒整理同一份博客时还补了参照:Gemini 在指令遵循项上是 87.1 分,差距不算小。更准确的说法是:强在整体稳定性和英文内容一致性,细致韵律控制和部分语种仍有空间,别把一句「全面 SOTA」当结论。
还有个口径问题别漏:所有这些分数都来自团队自测,评测集、对照组和采样参数由官方设定,第三方复现还没跟上。社区这边倒是热起来了。四月有开发者在 r/LocalLLaMA 发了个「Qwen3 TTS is seriously underrated」的本地流式演示,92 个赞、19 条评论,机器是 RTX 3060;配合 MLX-Audio 的 macOS 移植、ComfyUI 集成和 ePub 转有声书的小项目都冒了出来。同期报道也点出仓库还有几十个未关闭 issue、代码推送节奏偏慢,逛社区时能看到有人抱怨方言音色和长句断句,也有人拿它批量做播客旁白。
- 「三秒克隆加一句话造音色,这俩放一个仓库里,做有声书真省事了。」
- 「97 毫秒是理想值吧,我这边并发一上来就到两百多毫秒了,别只抄宣传数字。」
- 「日语和德语的表格数据摆着呢,怎么稿子里都写全面领先。」
- 「25Hz 那几个模型到底还放不放,论文里写了却不给下载,等得有点久。」
总结
Qwen3-TTS 最值钱的不是某个榜单第一,而是把「语音怎么表示」这件事重新做了一遍:十六层多码本把语义和声学一起塞进整数序列,因果卷积网络就能还原波形;双轨 LM 加 MTP 让首包赶在一个字之后;五种权重把克隆、造音色、控风格、流式输出拆成能单独取用的接口,还配了 Apache 2.0。对想自己握着语音层的团队,这套组合比再租一家按字符计费的 API 更有想象力。
但选它之前得把三件事算进去。第一,97 毫秒是 0.6B 在理想流式条件下的首包,1.7B 是 101 毫秒,真机上还要加网络和并发。第二,评测表是自家测的,英文和内容一致性确实能打,日语、德语、细致韵律控制并没有全面领先,官方博客只挑好看的写很正常,做选型得自己翻原表。第三,论文里那批 25Hz 模型和语音编辑还没放出来,别按十个模型规划排期。
讲真,如果你只是想给短视频配个旁白,在线 Demo 试两句就够了;如果要给产品接语音,建议先拿自己业务里的专有名词、数字串和中英混排文本压一轮词错率——这些地方才是 TTS 真正翻车的高发区,比官方榜单更说明问题。仓库还在更新,星标还在涨,这一版更像把底座铺好了,后面看社区和官方能不能把剩下那半张表格补完。
