先说结论:MOSS-Live 不是把语音识别率又刷高了一点点,它改的是交互方式。你说话时它也在听,你随口「嗯」一声它不会当成插话,你让它查酒店、下一句又问停车,它不会卡在那里干等后台返回。11 月上旬,模思智能(OpenMOSS 团队)陆续放出这套全双工实时交互系统:国内媒体把 11 月 2 日记作产品发布日,11 月 7 日团队在 Hugging Face 社区博客与 GitHub 仓库公开了技术说明、三段演示和完整评测表,能逐项核对数字的是后面这一版。对做语音助手、会议协作、车载和导览的团队来说,这套东西比又一张跑分榜更值得拆开看。
一句话说清:把「说话」和「办事」拆成两条时间线
全双工本来是通信术语。打电话是双工的,两头能同时听、同时说;对讲机是半双工的,同一时刻只有一方能出声。现在多数语音 AI 其实更接近对讲机:你说完,它再说,中间靠一个轮次队列串起来。真实对话并不这么整齐,人会停顿、会插话、会改主意,身边还总有别人说话和导航播报。
这就带出三个老毛病。你话没讲完它抢答;你应一声「嗯嗯」它反倒沉默;它去查资料或者调用工具时,音频流整个冻住,只能等结果回来。更烦的是旁边有人闲聊、设备自己在放声音,语音活动检测一响就把当前回答丢掉。MOSS-Live 想解决的就是这几件事:让机器来适应人的说话节奏,而不是让人迁就机器,把话一次说完整、周围还得保持安静。
官方把能力归成三层。交互上,边听边说,按语义判断何时回应、何时等待、何时闭嘴;感知上,语音、实时画面和环境声音放在一起理解;任务上,把复杂推理与工具调用丢到后台,前台继续聊。三层叠起来,目标是从「问一句、答一句」走向「持续在场」。
前后台协同架构:前台聊天不卡,后台慢慢查
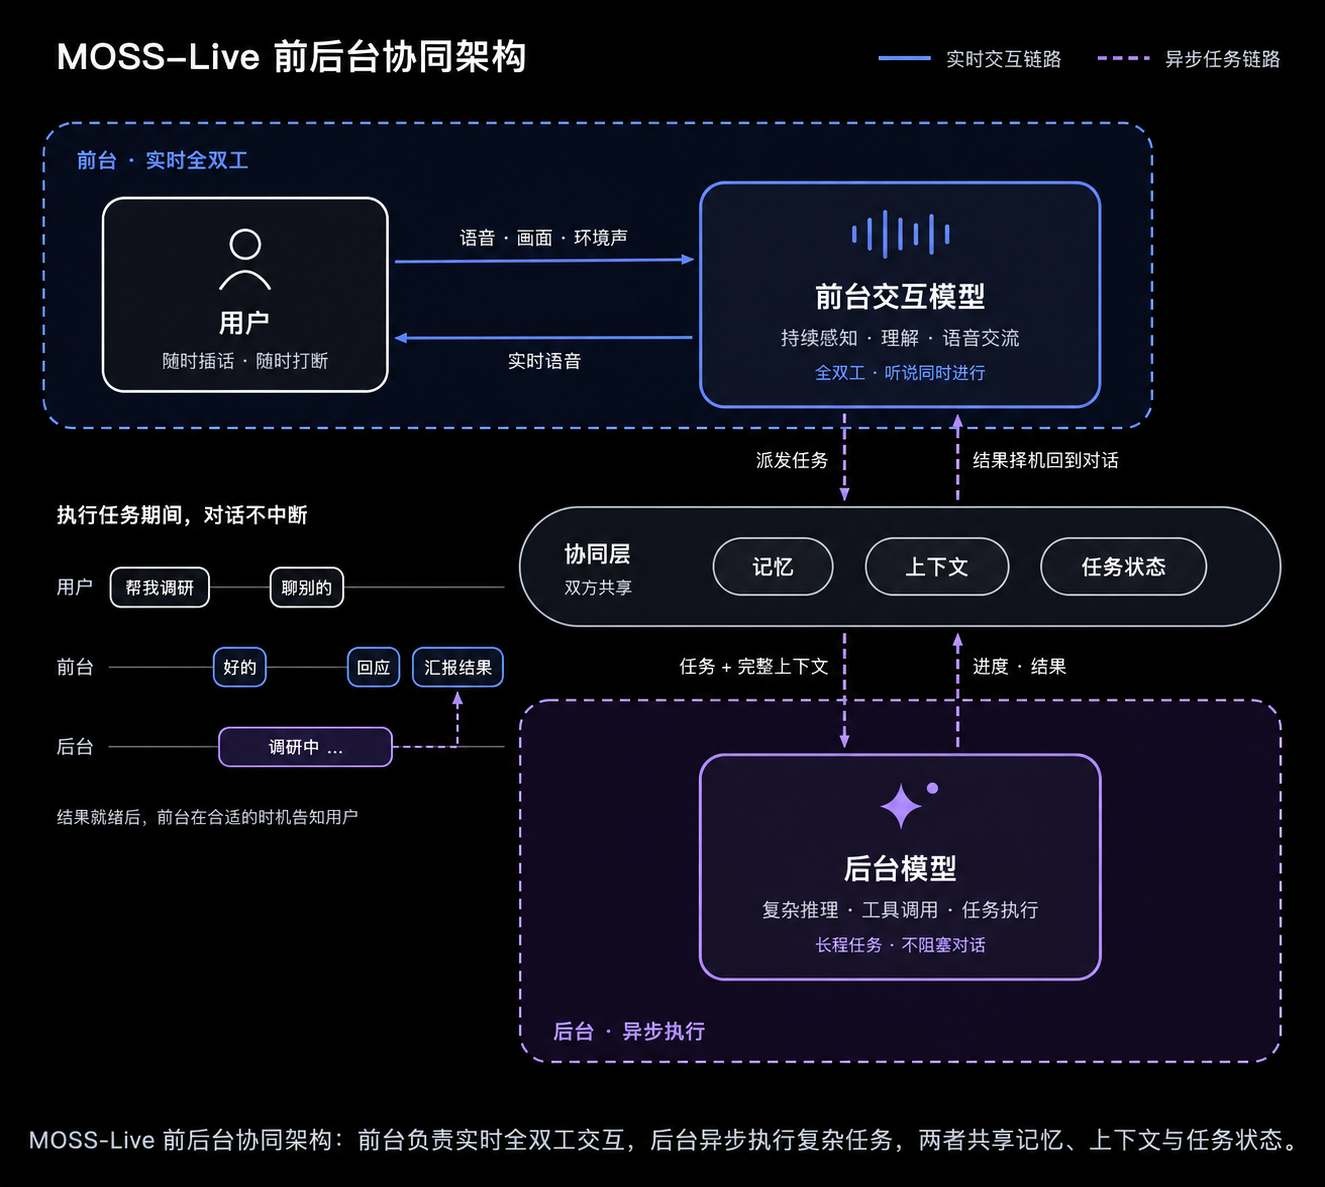
难点在于两种时间尺度打架。对话要的是几百毫秒级的反馈,查数据库、多步推理、调外部接口却常常要几秒甚至几十秒。传统语音管线把两者塞进同一条串行队列,一旦发出工具调用,说话就得停下来;反过来,背景噪音一进来,又容易把正在进行的回答打断。
MOSS-Live 的解法是拆成前台交互模型和后台模型。前台持续接收语音、画面及环境声音,理解当前对话状态,决定何时倾听、何时回应、何时等待,也负责把话轮让出去。后台接复杂推理和长程任务,前台把任务连同对话上下文交过去之后就异步执行,不必等它。中间有一层协同机制共享记忆、上下文和任务状态:前台能掌握后台进展,在结果「说出来有用」的那个时机把它带回对话;用户中途又补了新的语音或画面,任务也能跟着调整。
官方举的例子很直观:你让它查酒店,紧接着又问停车,它可以先聊停车,同时保住行程约束,等酒店信息回来再接上。这比单纯把延迟压低更实用,也解释了不少团队为什么开始把「前台对话+后台执行」当成新范式——同一周里 Antigravity 的 Gemini Live 语音模式、Cursor 的 Grok Voice 语音聊天,走的都是相近的路子。
不过拆开之后多了个新问题:话轮让得漂亮,不等于后续任务跟得上改口。用户把「爬山」改成「海边放松」,几秒后回来的酒店结果如果还按旧需求算,流畅反而成了干扰。共享状态正是为这个设计的,但可靠性得靠复现测试说话,光看演示视频不够。
全双工能力:最难的不是听见,是忍住不接话
官方列的全双工能力里,有几条其实是在做减法。语义打断要求分清附和与真的要插话,你短促应一声,它不中断输出;语义判停要求按语义判断话说完没有,句中停顿、思考时先等着;区分说话对象与无关拒识,是让它认出哪些话冲自己来,旁人闲聊、自言自语、设备播放的声音都不该触发它。再加上自然附和、断点续说与记忆,被多次打断、换过话题之后,还得记得刚才讲到哪儿。
主动交互更有意思。你可以事先交代条件,让它在背诵时纠错,或者在会议里盯着某类事项、到合适时机主动提醒。边聊边做事则是把天气、股价、餐厅推荐、行程规划这些任务丢到后台,前台对话不断,办完主动汇报。流式同声传译支持 14 种语言双向互译,原文文本、译文文本、译文语音以流式同步返回,说话的人还在讲,译文已经在出。
视觉这块同样不是配角。视频通话、屏幕共享的画面可以进入同一段交流,它还能理解非语言的声音,识别环境声、感知说话者的音色等声学特征。上海街头那段演示里,游客举起手机问眼前是什么建筑,系统靠实时画面认出和平饭店,讲起历史,被追问房价和餐饮后又绕回来接着说绿色屋顶——这已经不是「听懂一句话」,是把看、听、查、讲放进一次连续对话。
提醒一句:相机、屏幕、环境音都是持续输入,真要落到产品里,得明确告知在场的人,并把数据权限管住。技术演示里最容易被忽略的,恰好是这一层。
36 项指标摊开看:节奏赢了,任务完成率没赢
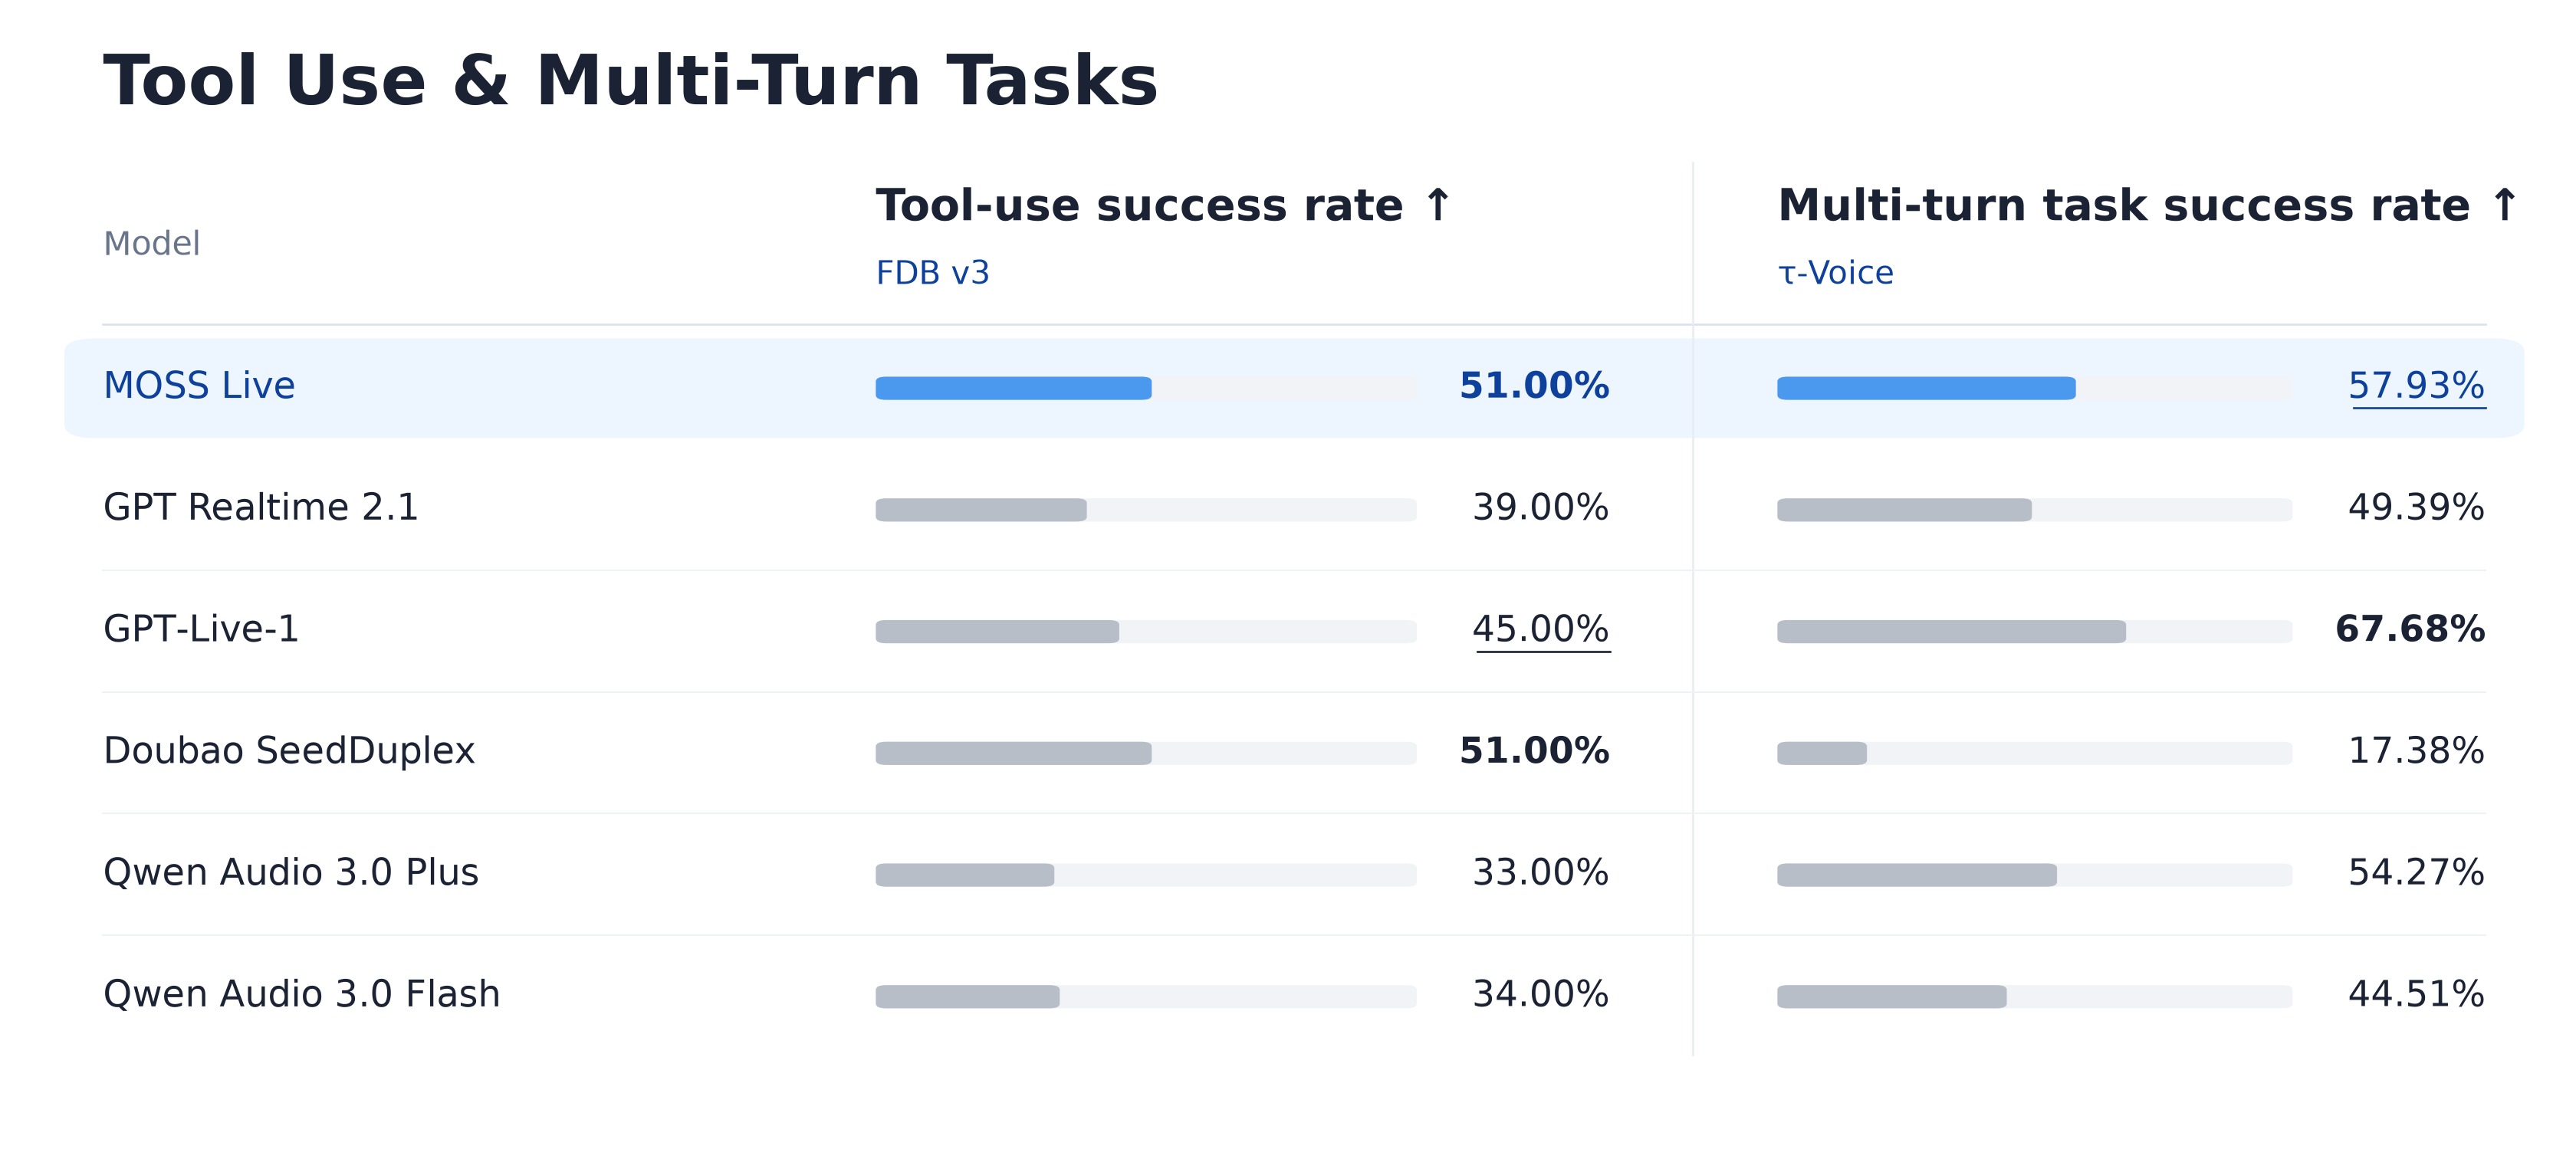
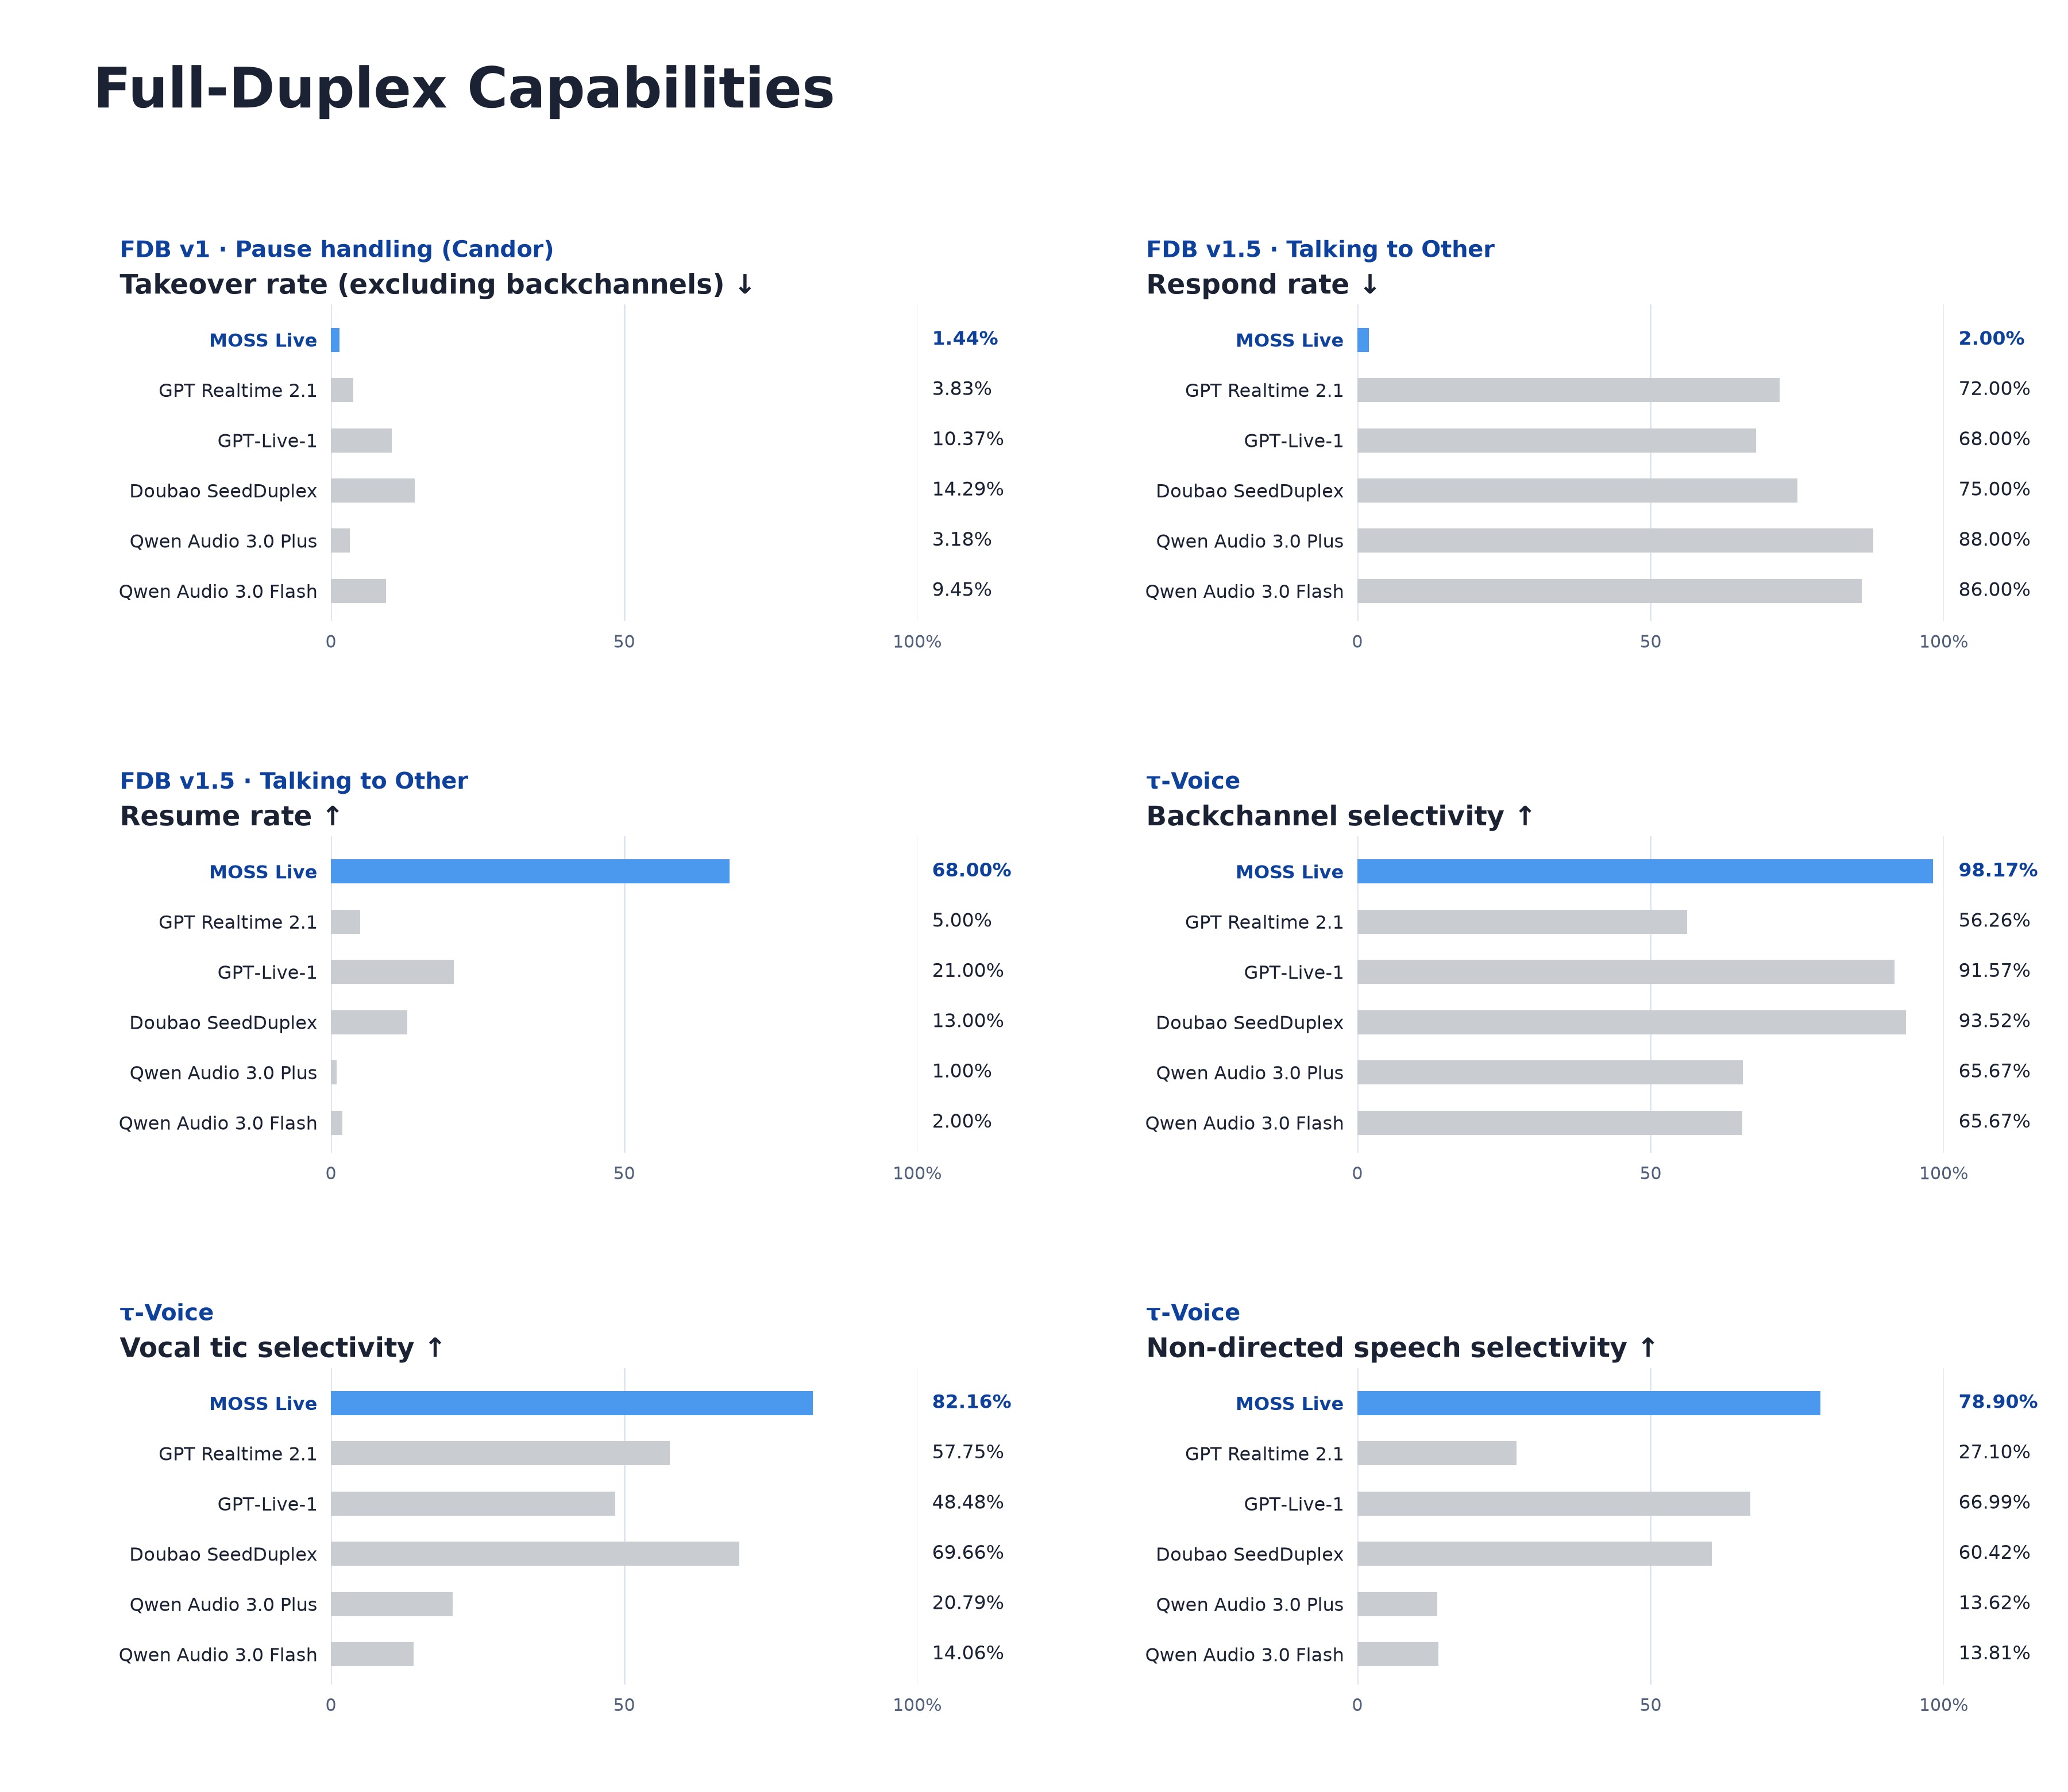
官方公开的评测覆盖 6 个评测集、36 项指标,评测集是 FDB v1、v1.5、v2、v3、Big-Bench Audio 和 τ-Voice,对照组包括 MOSS-Live、GPT Realtime 2.1、GPT‑Live-1、豆包 SeedDuplex、通义 Qwen Audio 3.0 Plus 与 Flash。先看它确实强的地方:FDB v1.5 里无关语音误接话率只有 2.00%,对照的 GPT Realtime 2.1 是 72%、GPT‑Live-1 是 68%、豆包是 75%;无关打断拒识率 68%,同组最好的对照只有 21%;背景语音误响应率 10%,对照普遍在 66% 到 95% 之间。FDB v1 的停顿抢话率(不含附和)压到 1.44%,打断后回答质量 4.88 分(满分 5 分)为同组最高。τ-Voice 的附和、口头语、无关语音抗干扰率分别是 98.17%、82.16%、78.90%,三项都排在前面。FDB v2 的轮次流畅度 4.52 分、实体跟踪与纠错安全 3.63 分也是同组最高,FDB v3 的工具调用成功率 51.00% 与豆包并列第一。
但同一批表格里,落后项一样清楚。Big-Bench Audio 总体准确率 88.40%,低于 GPT Realtime 2.1 的 90.10% 和豆包的 90.50%;τ-Voice 多轮任务成功率 57.93%,排第二,第一名 GPT‑Live-1 是 67.68%;FDB v3 工具场景响应时延 2.36 秒,慢于 GPT Realtime 2.1 的 1.61 秒;τ-Voice「被打断后 2 秒内让话率」只有 52.49%,Qwen Audio 3.0 Flash 是 96.28%;FDB v1.5 的附和抗干扰率 61.22%,明显落后豆包的 98.98%。接话时延 1.14 秒,同组最快的 GPT‑Live-1 是 0.78 秒;接话成功率 84.03%、附和频率 0.0234 Hz 这些行里,它也并非头名。
所以更准确的说法是:MOSS-Live 在「什么时候该开口、什么时候该安静」这类交互节奏指标上优势明显,在「把任务真正办对」和纯语音理解上并不领先。还有两个前提别漏掉——这些分数全部来自团队自己公布的评测,演示也是官方拍的;6 个评测集口径各不相同,36 项指标不能揉成一个总分,更不能直接读成「全面超越」。要把这套系统放进产品,第三方复现和真实噪声环境里的测试仍然绕不开。
三段演示和开发者接入:从会议室到 WebSocket
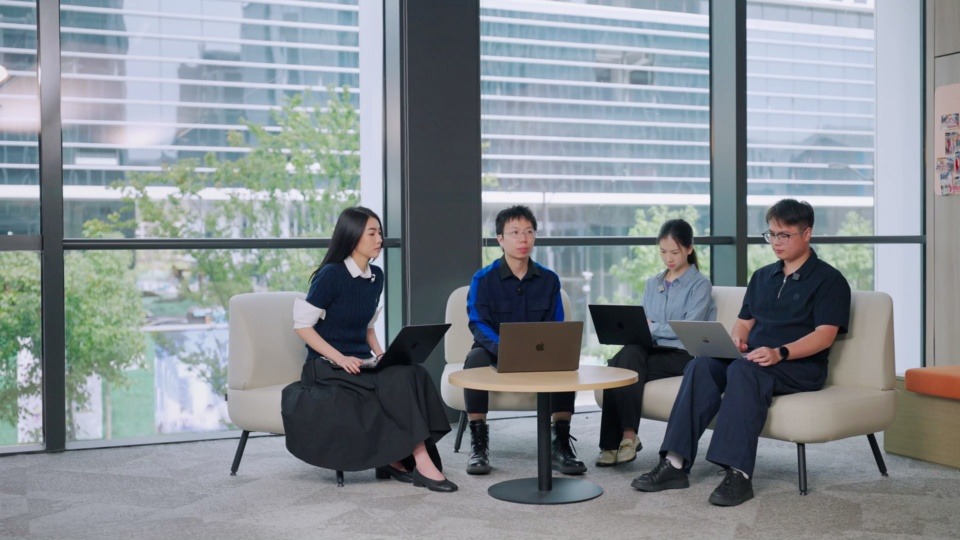
官方放出的三段演示各有侧重。会议室那段看多人讨论:有人让它查上海、杭州的天气和同期大型活动,查询途中被打断,它按新信息调整范围;有人随口附和,它没停;另一位同事抛出新问题,它及时让出话轮;隔了几轮有人重新问起杭州的活动,它还能接上,散会时把结论和待办整理出来。舟山两日自驾那段看抗干扰:用户中途把爬山改成海边放松,后台接着查酒店,前台继续回答渡轮、停车和住宿,车载导航响了好几次都被判成无关声音。上海街头那段是边走边看边问,前面已经说过。
开发者视角更实在。实时接口是 WebSocket 的 wss://api.mosi.cn/v1/realtime,模型 ID 写作 moss-live-1.0,握手时把 API Key 放在服务端请求头的 Authorization: Bearer 里,密钥不进浏览器。连上先发 attach_session,拿到 session_attached 再开麦克风;上行音频是 16 kHz 单声道 PCM S16LE、无文件头,按实时速度持续发二进制帧,用户停下来也要继续发静音帧,好让模型判断停顿;下行是 48 kHz 单声道 PCM S16LE。文字事件走 input.transcript.updated、output.transcript.done 这一类通道,音频单独走二进制帧,播放完还得按 run_id、turn_id、chunk_id 回 playback.chunk.completed 和 playback.completed。用户插话时先收 response.audio.stop,立刻停掉对应播放、清空队列,再回 playback.stopped,response.interrupted 是这次回答的最终状态。这套回执设计挺关键:全双工不是简单把麦克风一直开着,播放进度必须和模型状态对得上。
后台任务有两条路。现成的 Pi 集成要求 Node.js 22.19.0 以上、跑在 macOS 或 Linux,用 npx @mossai/mosslive@0.1.0 demo 起示例,配置存进 moss-live.config.json,默认只开 read、grep、find、ls 这几个只读工具;也可以 init-adapter 生成自己的适配工程,里面带执行器模板、AGENTS.md 和契约测试。这部分是可选的,实时对话和自定义工具本身就能跑。
「开源」这个词得说清楚。GitHub 仓库里放的是 README、docs 和 assets,既没有许可证文件,也没有权重下载入口,所以它不是一个开放权重模型,更谈不上自己部署一份。目前能用的是在线 Playground 和平台上的 Realtime API,计费要看定价页。把它当成一份公开的架构参考加一个可试用的服务,比纠结「开源不开源」更贴近现实。
- 「最烦话没说完它就抢答,1.44% 这个数字要是真能复现,我第一个去试。」
- 「2% 误接话确实漂亮,可表是自家测的,等第三方跑一遍再说。」
- 「仓库里没权重也没许可证,叫开源有点勉强,本质还是调 API 吧。」
- 「车里导航一响就打断,这个场景太真实了,希望真扛得住。」
总结
MOSS-Live 值得看的地方,不是某张榜单上多了个第一,而是它把「对话节奏」当成一等公民来设计:边听边说,分得清附和与打断,查资料时不停嘴,改了主意还能接回原来的话。对做会议协作、车载语音、导览和跨语言客服的团队,这套前后台协同架构提供了一份能照着评估的蓝图;对普通用户,先去 Playground 试一段「故意打断它」的对话,比看参数更有说服力。
但也别急着下结论。交互节奏赢了,任务完成率、语音理解准确率、工具场景延迟都还有落后项,且分数全部来自团队自测;权重与许可证没放出来,实际可用的是 API。真正要落地,还得在混响、多人、噪声这些不体面的环境里跑一遍,并且把摄像头、屏幕共享和环境音的告知与权限先安排好。讲真,从「人适应机器」转到「机器适应人」这个方向挺让人期待,只是这一版更像是把路指出来了,不是把路走完了。
