如果只看发布节奏,最近这十天在具身智能领域算得上密集。
松延动力放出了 Scalabot 上的 HERON-World Model 与 HERON-CRA;智元更新到 AGILE 2.0 并配套 GE-Act 2.0;宇树把 UnifoLM-WLA-1.0 开源了出来。再往前数,傅利叶、乐聚的 KUAVO-VLA、众擎的 EngineAI Awaken 也都在七八月交过作业。同期还有 Cog-WM 1.0、Intern W0、Puffin-World 这类偏基础研究的世界模型。
名字一个比一个长,但把它们摊开看,会发现大家在做同一件事。
从「看完就动」改成「想完再动」
早两年的做法是端到端:摄像头进来一张图加上一条指令,模型直接吐出一串关节角度。这套结构跑演示视频很好看,一进真实环境就露馅——杯子换了个位置、灯光变了一下、桌面多了个障碍,动作链就断了。
原因不复杂。端到端模型学的是「这种画面配这种动作」,它不理解物体之间的空间关系,也不知道「手往前推二十厘米」在物理上意味着什么。它没有被惩罚过,所以也没有学会谨慎。
这一轮各家补的正是这一块。HERON 系列的核心是先在内部建一个可预测的世界表示,机器人动手之前先在「心里」跑一遍,判断这个动作会不会撞到、能不能抓住、抓起来之后重心会不会偏。智元的 GE-Act 2.0 走的是同一路线,把动作生成拆成「预测结果」和「执行动作」两步。宇树开源的 WLA 则把语言、视觉和动作三路拼在一起,让指令、画面和关节控制共享同一套表示。
说白了,以前是条件反射,现在是先预演。多出来的这一步计算很贵,但它换来的是失败之前先犹豫一下的能力。
为什么偏偏是现在
时间点不是巧合,有几个条件同时到位了。
第一是数据。世界模型需要大量「动作—结果」配对的数据,而这类数据采集成本极高——得让真实的机器人反复做同一件事,还要准确记录结果。过去两年国内几家做整机的公司铺了不少真实场景采集,现在这批数据终于够训练量级了。
第二是算力结构的变化。世界模型推理开销比端到端大一个量级,放在机器人本体上跑不现实。今年边缘算力和端侧推理优化进步得很快,一部分预测可以本地做,不必全部传回云端。这对需要实时反应的机器人来说是硬门槛。
第三是竞争节奏。人形机器人硬件这两年进步太快,同一个价位段的机器人在关节、续航、负载上差距缩小了,「身体」不再能拉开差距,只能靠「脑子」分胜负。这也是为什么几家的发布密度突然上来了。
开源这一步,宇树走得更靠前
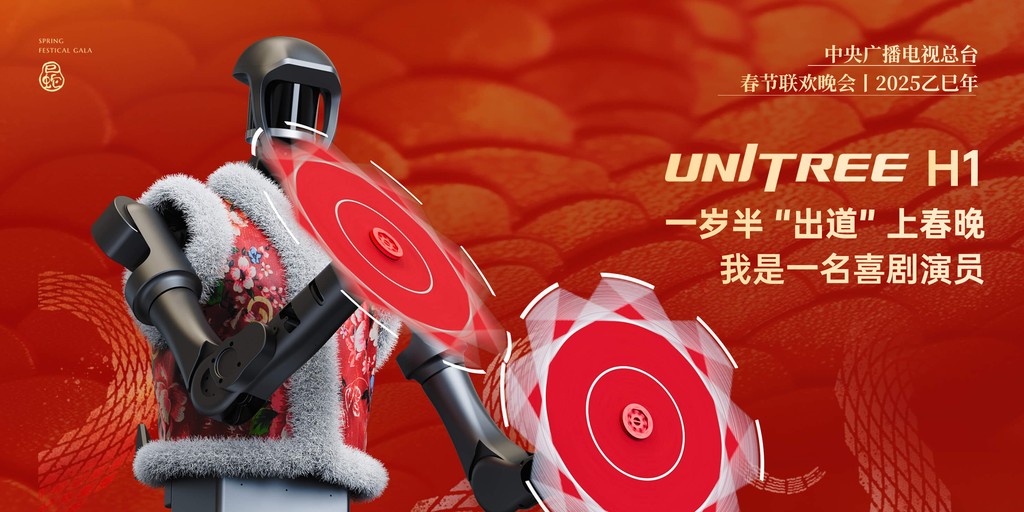
五家里最值得单独说的是宇树。它把 UnifoLM-WLA-1.0 直接开源了。
开源在世界模型这个方向上是件挺反常的事。世界模型最值钱的部分是它见过多少场景、见过多少失败——这些都是拿钱和时间堆出来的数据资产。开源模型权重,等于把一部分积累送出去。
但宇树的算盘也不难猜。它卖的是整机,模型开放出去,会有更多人拿它的机器人本体做研究、发论文、做二次开发。生态一旦起来,后面卖硬件的确定性就高了。这条路径在国内机器人公司里不算主流,但如果赌对了,回报比守着模型大得多。
热闹归热闹,两个问题还没答案
第一个问题是评测。现在各家都在自己搭的场景里报成功率,台面搭得不同,数字就没法比。行业里缺一套像样的公开基准,机器人的「跑分」至今是自说自话。
第二个问题是从演示到干活的距离。演示场景往往围绕固定物件、固定光照、固定动线设计,而真实家庭和工厂里最不缺的就是意外。世界模型的价值恰恰体现在这些意外上——但意外没法在发布会上展示。
所以这一轮集体发布,更像是行业在同一个方向上的加速起跑。真正的分水岭会在明年出现:谁能把成功率从演示级的数字,变成连续跑一周不出大错的稳定性,谁才算过关。
世界模型和 VLA,不是一回事
这一轮发布里,「世界模型」和「VLA」两个词混着用,容易被当成同一件东西,其实分工不同。
VLA 是视觉、语言、动作三路合一的模型,输入画面和指令,输出动作。它管的是「怎么动」。世界模型管的是「动了会怎样」——它预测的是环境在动作之后的变化,给 VLA 提供判断依据。
把两者接起来,就构成了现在比较主流的双段结构:世界模型负责在内部推演几种可能的动作结果,VLA 负责把选中的那一种执行出来。HERON 系列的 World Model 与 CRA 就是这种分工,智元的 GE-Act 2.0 也在往这个方向靠。
这样做的好处是可控性提高了,代价是推理延迟变长。机器人做一次判断要跑两个模型,反应速度必然受影响。所以接下来一年里,这类方案的优化重点会集中在把推理压到边端、或者把两个模型蒸馏成一个。
数据才是这一轮真正的门槛
模型结构上的创新,其实各家差异没有那么大——注意力怎么算、表示怎么对齐,论文里都写得很清楚。真正拉开差距的是数据。
世界模型要学「动作之后环境会怎么变」,就必须有大量同步记录动作和结果的真实数据。这类数据不像文本语料可以在网上爬,只能靠真实设备一遍遍操作采集:抓一个杯子要记录抓取角度、力度、杯子材质、是否打滑、打滑之后怎么修正。一个动作可能要采几百次才能覆盖不同变体。
这也是为什么过去一年国内做整机的公司集体在铺采集场景。硬件卖出去之后能顺带采集数据,形成正循环——机器越多,数据越多,模型越好,机器越好卖。这条逻辑目前只有少数几家跑通了。
反过来看,纯做模型的团队在这个方向上天然吃亏:没有本体,就采集不到第一手数据,只能依赖公开数据集或者和整机厂商合作。这也是国内这波发布里,唱主角的几乎都是整机公司的原因。
落到日常,短期内还看不到什么
对普通用户来说,这一轮技术进展在接下来一两年里不会有直观感受。现在能在展台上看到的机器人,做的还是取物、递东西、简单装配这类动作。它们看起来流畅,但背后是工程师反复调试过的固定场景。
真正的变化会以很慢的方式渗透进来:先是工厂里重复性最高的工位被替换掉一部分,再是仓库分拣这类半结构化场景,最后才轮到家庭。家庭环境是不可控的极端情况——孩子、宠物、地上的拖鞋,都是世界模型没见过的长尾。
所以看这一轮发布,不需要期待马上有什么会出现在家里。值得关注的是那些细碎但关键的事:成功率有没有稳定往上走,推理延迟有没有降下来,同一套模型能不能迁移到不同的机器人本体上。这三件事决定的是三年后,而不是下个月。