DeepSeek 轻量版登顶 Agent Arena 开源榜
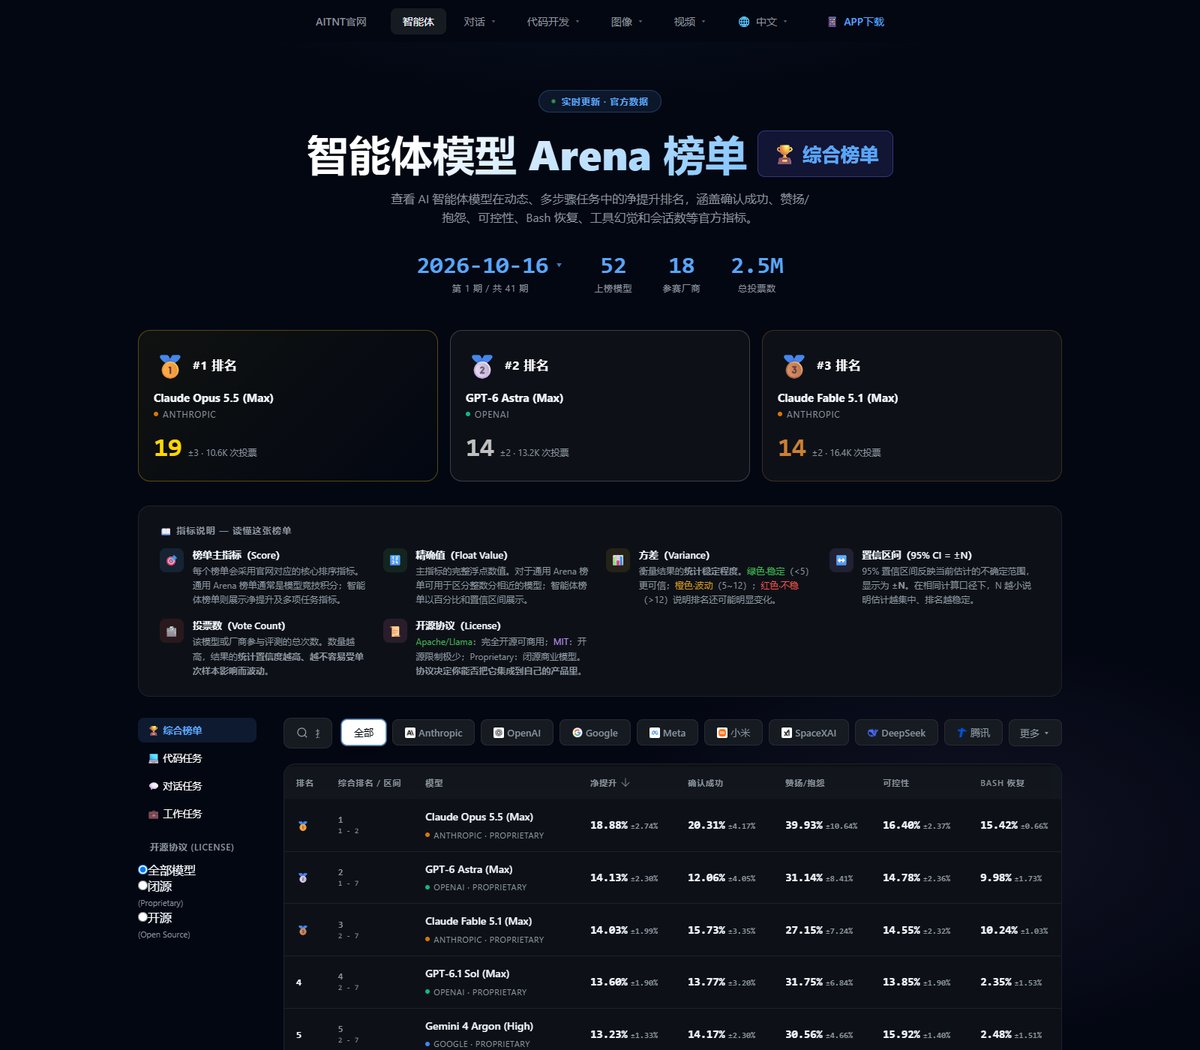
国产模型在智能体竞技场里又拿下一个第一。10 月 20 日,评测平台 Arena 宣布,深度求索 10 月 17 日发布的 DeepSeek-V4.1-Flash-20261017(Max)登顶 Agent Arena 开源模型榜,同时把总榜第 11 的位置一并收入囊中——榜单前列少见的 MIT 许可开源模型,而且还是轻量 Flash 档。
先看关键数字:7498 次真实使用会话、综合净改进 +5.13%、单任务成本中位数约 0.18 美元。总榜前 10 名清一色是 OpenAI、Anthropic、Google 的闭源模型,DeepSeek 以开源阵营头名的身份卡进第 11 位。
Agent Arena 是个什么榜
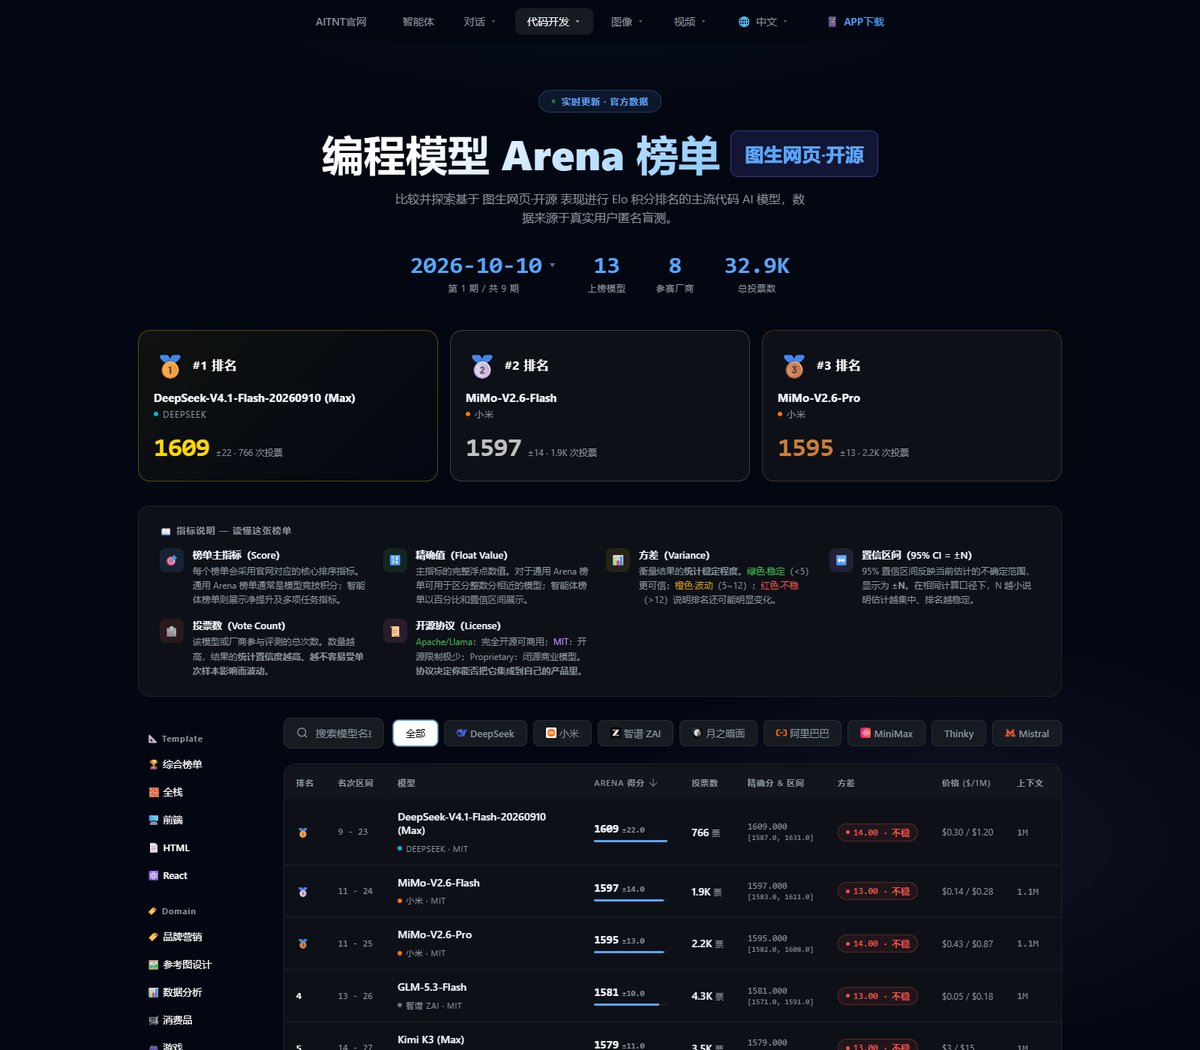
Arena 平台由原 Chatbot Arena(LMSYS)团队运营,靠匿名盲测投票给大模型排座次,是行业内引用最多的评测体系之一。Agent Arena 是它旗下的智能体子榜,玩法与传统跑题考试完全不同:不设预设题目,直接记录真实用户把模型当 Agent 干活的完整会话——调工具、跑终端、多轮交互,用户中途还会改需求、报错、吐槽。
榜单用因果推断方法算出「净改进」指标,衡量模型比随机基线强多少。截至 10 月 19 日,该榜累计收录约 266 万次会话,覆盖 56 个模型。换句话说,排名不是答题纸给的,而是一次次真实干活攒出来的口碑。
数据拆解:开源第一的含金量
具体到 DeepSeek-V4.1-Flash-20261017(Max),综合净改进 +5.13%,样本为 7498 次真实会话,单任务成本中位数约 0.18 至 0.19 美元。分项成绩更亮眼:任务成功确认 +11.54%,总榜第 8;用户正负反馈 +5.89%,总榜第 11;Bash 命令执行可靠性 +5.42%,总榜第 12;可引导性 +2.46%,总榜第 13——这四项全部位列开源模型第一。
工具幻觉指标 0.48%(数值越低越好),排在总榜第 7,说明它很少虚构自己并不具备的工具。对天天跟终端报错打交道的开发者来说,这一条比名次本身更实用。
总榜第 11:跟闭源头部还差多少
差距得坦白讲。总榜第一的 Claude Opus 5.5(Max)净改进 +20.35%,接近 DeepSeek 的四倍,单任务成本高达 6.16 美元;第二名 GPT-6 Astra(Max)+15.15%,每任务 4.13 美元。第 11 名再往上看一级,GPT-5.6 Sol(xHigh)+6.59%、成本 1.6 美元;往下看,第 12 名 Claude Sonnet 5(High)只有 +4.06%,却要收 1.25 美元。
DeepSeek 用 0.18 美元做到 +5.13%,Arena 也把它列入了性能与成本的帕累托前沿——意思是没有任何一个入选模型能同时在性能和成本两个维度压过它。花零头的钱把活干到中上游,这就是开源阵营的现实打法。
一次点状升级,打出超额战绩
10 月 17 日的这次更新,在 DeepSeek 自己的口径里只是常规迭代:网页端、App 与 API 同步替换,调用方式与价格不变,仍走 deepseek-flash 入口,官方称 11 项基准较 9 月版提升 2.0 至 11.1 分,任务跑得更快、输出更短。架构上它是 MoE 模型,主干 552B 参数、外加 196B Engram 参数,预填充阶段仅激活 8B、解码 16B,上下文窗口 1M token,权重以 MIT 许可发布。
就是这样一个「小版本」,在 Agent Arena 之外还顺手拿下 Code Arena: WebDev 开源榜第一(1670 分、总榜第 12),把此前的开源头名 Kimi K3(Max)挤了下去,成本只有后者约十分之一。官方还建议搭配 DeepSeek Harness v0.2.1-rc.1 及以上版本使用,并针对多款主流编程工具做了适配优化;第三方聚合平台 OpenRouter 也在发布当天同步上架。此前我们横评 61 款编码模型时,这个型号就已在编码榜登顶(前情回顾);而 Kimi 那边 10 月 20 日凌晨刚杀回代码榜前十(详情),两边的拉锯还在继续。
开源阵营的追赶节奏
把镜头拉远,开源模型在这份榜单上并非孤例。小米 MiMo-V2.6-Pro 以 +3.74% 排总榜第 14,单任务成本仅 0.12 美元;MiMo-V2.6-Flash 以 +2.54% 上榜,成本 0.06 美元。总榜前 15 名里开源模型占了两席,全部来自中国团队。
追赶路径也很清晰:不硬拼闭源头部的绝对性能,而是把每任务成本压到对手的几分之一,先在帕累托前沿上占住性价比生态位,再用迭代速度一分一分往上磨。
写在最后:名次之外看什么
总榜第 11 与第一名之间 15 个百分点的差距,短期很难抹平,这点没必要回避。但 Agent Arena 这类真实会话榜单的价值在于,它衡量的是用户愿不愿意继续把活交给模型,而不只是考卷分数。
一个轻量 Flash 版能在 0.18 美元的成本位拿到开源第一,至少说明两件事:智能体场景对性价比的敏感度远超参数表,开源模型的迭代速度也足以让闭源阵营感到压力。社区里的反馈也两极:有人已经开始把日常脚本任务整体迁过去,也有人翻出考卷分数质疑「净改进」的算法口径。下一期榜单更新,值得盯的是样本量涨上去之后,+5.13% 这个数字还能不能站得住。
