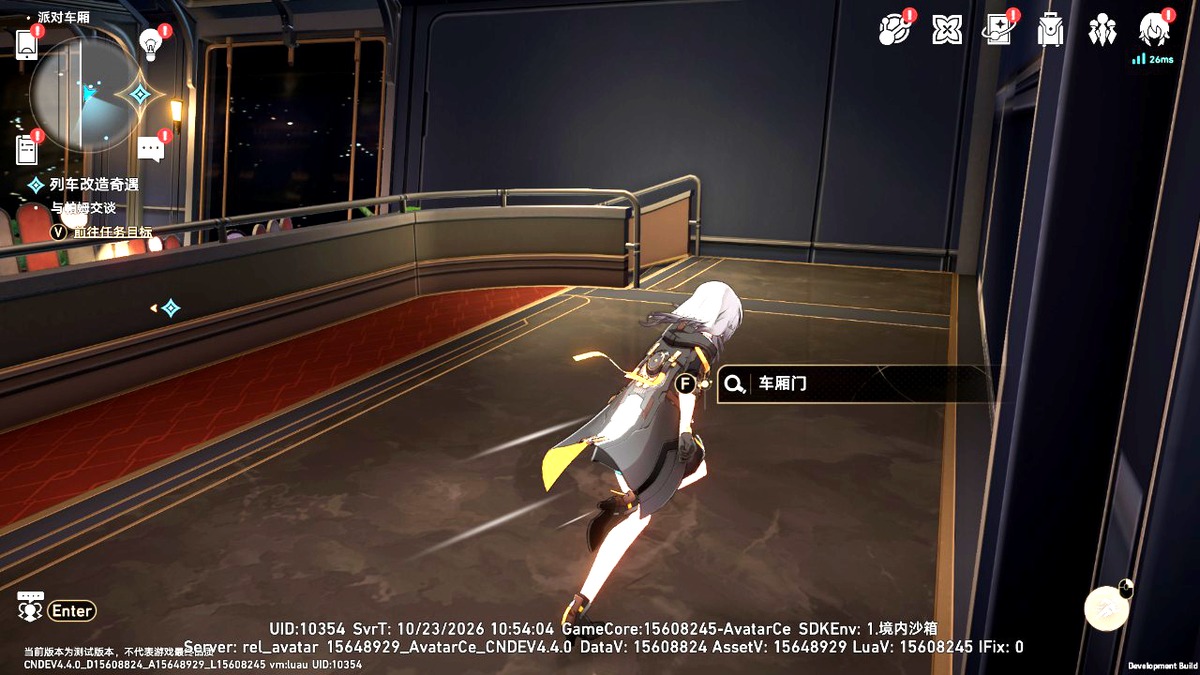
米哈游《崩坏》系列 AI 研发团队在 arXiv 公开论文与项目页面,正式推出通用视觉语言动作(Vision-Language-Action,简称 VLA)基础模型 Gamer。这个模型玩游戏的方式和人类玩家几乎一样:它只盯着屏幕画面,然后用键盘和鼠标动手。在放出的实机演示里,Gamer 已经能在《崩坏:星穹铁道》里推进主线任务、探索场景并完成解谜挑战。团队同时明确表态:这是一项学术研究项目,不支持用于游戏作弊或任何破坏游戏公平性的行为。
只看画面就能玩:像人一样的输入与输出
VLA 模型这个名字最初多见于机器人研究——摄像头画面进,机械臂动作出。Gamer 把同一套思路搬到了电脑游戏上:画面来自显示器,「手臂」换成了鼠标和键盘。它不读取游戏内部数据,不调用任何游戏专用 API,也拿不到特权状态,能看到的只有玩家能看到的像素。
具体节奏是:模型以每秒 5 帧(5Hz)的频率采集游戏画面,每 200 毫秒输出一组鼠标移动指令,外加连续六段各 33 毫秒的按键状态,等效于约 30Hz 的原生键鼠操作。换句话说,两帧画面之间模型会提前规划好若干个小动作,就像人类玩家在一段连贯操作中不会每一眨眼都重新决策一次。由于整套接口只有画面、鼠标和键盘,同一套操作词汇原则上可以迁移到任何键鼠游戏,这与针对单一游戏、依赖内部数据打造的传统脚本智能体有本质区别。
三段式训练:一万小时操作轨迹打底
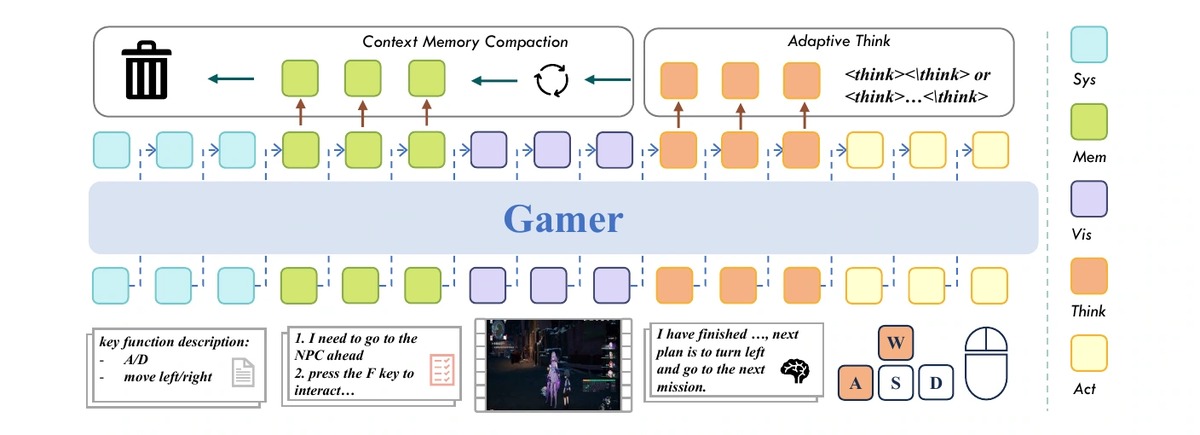
长程实时任务是这类智能体最难啃的部分:任务越长,需要记住的视觉历史越多,响应也越慢,而游戏恰恰要求快速反应。研究团队用三阶段方案来解决这两个瓶颈。
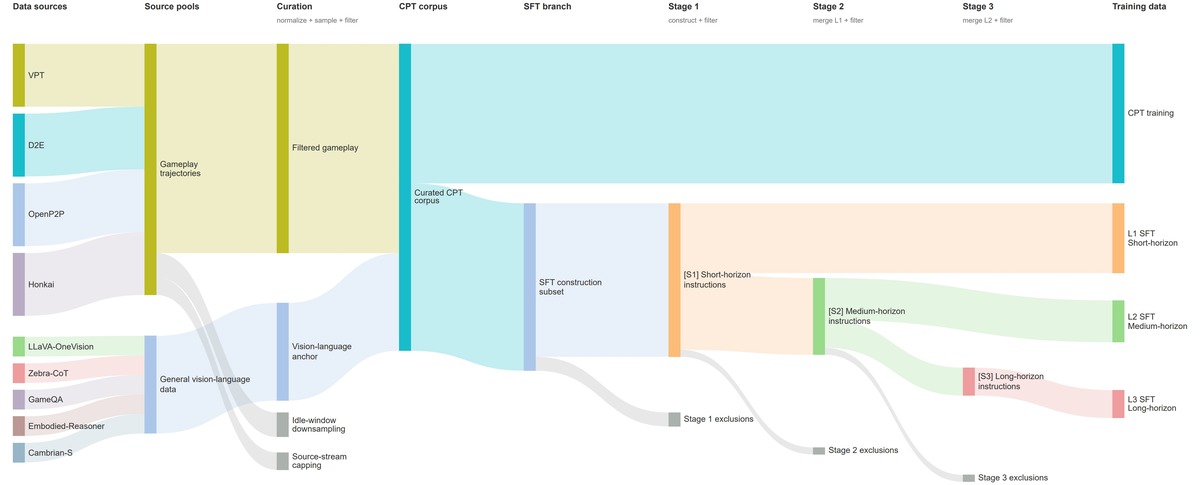
第一段是持续预训练:用超过 1 万小时的跨游戏键鼠操作记录(画面与操作对齐的轨迹)训练模型理解「什么局面下人会做什么操作」,训练过程中还随机重映射按键,防止模型死记硬背「某个键永远等于向左」。第二段是指令微调:引入约 120 万条推理标注与 22.3 万条记忆标注,教会模型两件事——只在关键决策点展开「思考」,平时直接输出动作以节省算力;当旧交互滑出上下文窗口时,把已完成的子目标、失败尝试和剩余计划写成记忆便签带进下文。第三段是在线强化学习:采用团队称为 TA-GRPO 的时序感知方法,奖励直接对照游戏内部状态核验,而不是依赖一个学习出来的奖励模型。
Streaming-vLLM:把延迟从 1306 毫秒压到 65 毫秒
光会决策还不够,实时游玩要求低延迟。团队专门开发了名为 Streaming-vLLM 的推理引擎,在多轮请求之间复用模型缓存,并在一次生成尚未完成时就先行发出动作。在 NVIDIA H200 硬件环境下,这套引擎把端到端请求延迟从 1306 毫秒降到 65.12 毫秒,约二十分之一。按论文作者的说法,更快的推理也让在线强化学习的训练效率随之提高。
星穹铁道成绩单:主线能推进,小游戏通关一半
实机演示之外,团队用训练时未接触过的内容做了留出测试。两条支线任务按「到指定地点、与角色对话」等中间节点逐项计分:支线「机会使然(上)」共 30 个节点,成绩从预训练后的 34.4%、微调后的 72.2% 一路升到强化学习后的 80.0%;支线「兽亦凶猛」共 55 个节点,最终达到 83.6%。七类共 40 个小游戏的平均成功率则为 49.7%,高于微调前的 15.0%,也明显高于论文中作为对照的通用模型 GPT-6.1-Sol 的 17.1%。论文还称 Gamer 的操作效率可与熟练玩家媲美。
需要说明的是,上述成绩全部来自团队自报数据,目前尚无第三方独立复测;49.7% 也意味着大约每两个陌生小游戏里仍有一个过不去。模型规模、对比模型的完整清单等细节,论文披露得也有限。
学术定位与反外挂边界:官方明确「不支持作弊」
一个只看画面、输出键鼠操作的 AI,在旁观者眼里和真人玩家几乎无法区分——这正是外界担心它被拿来做外挂和自动化脚本的原因。对此研究团队的表态非常明确:Gamer 是一项旨在探索交互环境通用智能代理的学术研究项目,潜在应用方向包括游戏测试、无障碍辅助以及人机交互研究;团队不支持将 Gamer 用于游戏作弊、未经授权访问、利用安全漏洞,以及任何损害用户利益或破坏游戏公平性的行为。
数据层面同样留了一手:出于数据安全考虑,团队目前只公开了项目早期基础预训练阶段使用的通用文件(代码以 Apache 2.0 许可开源),既没有公开任何《崩坏:星穹铁道》相关训练数据,也没有发布用该游戏数据训练或微调后的模型权重。换句话说,外界拿不到「已经会玩星铁的成品」。
网友热议
- 有不少玩家认为,比起「AI 代打」,这项技术更现实的落点是自动化测试:一个能看懂任务说明、会点会走的智能体,正好用来在版本更新后回归测试任务流程会不会卡死、路径会不会走断。
- 外挂争议是讨论最热的一支:输出就是普通的键鼠信号,反作弊系统很难从行为层面分辨人与 AI。不少网友因此强调团队的「不支持作弊」表态必须有配套的技术约束,只靠声明不够。
- 也有技术向网友指出,Gamer 与传统外挂的技术路线完全不同:它不碰内存、不调内部接口,是公开研究而非作弊工具,论文开源的部分也不含游戏专属数据,边界划得比较清楚。
- 还有玩家对 49.7% 的小游戏成功率并不买账,认为「一半过不去」说明距离真正通玩复杂游戏还很远,现在的演示更像精心挑选过的成果展示。
意义与边界:从游戏走向通用智能体的试验场
在团队给出的规划里,Gamer 的价值一头连着研发端:用智能体代替人工完成游戏测试与回归验证;另一头连着无障碍辅助,让操作困难的玩家也能借助 AI 体验游戏。更长远地看,游戏具备长任务、部分可观测、稀疏奖励和实时控制等特性,本身就是检验通用智能体的理想试验场。米哈游把训练与推理配方完整公开、却扣住游戏数据与权重的做法,也算给「AI 玩游戏」这条赛道立了一个值得参考的开放边界样本。
