Hamel Husain 是那种不太愿意把问题包装得漂亮的工程师。他在 Airbnb 和 GitHub 做过机器学习基础设施,后来独立做 AI 产品顾问,与 Shreya Shankar 一起在 Maven 上开 AI 评测课,学员累计超过 700 名工程师和产品经理。2026 年 9 月 18 日,两人把这门课里被问得最多的约 40 个问题整理成一份 FAQ,开篇就声明:这些是「大多数情况下有效的尖锐观点,不是普世真理」。这份克制的声明反而让人愿意读下去,因为接下来的每一条,几乎都在推翻行业里被反复推销的默认做法。
速览卡:这位大佬和他说了什么
 | 大佬 | Hamel Husain |
| 身份 | AI 产品与评测顾问,前 Airbnb / GitHub 机器学习基础设施工程师,Maven「AI Evals」课程讲师 | |
| 出处 | hamel.dev 博客《AI Evals: The FAQ》(与 Shreya Shankar 合写,2026-09-18);后续《How to Find Failure Patterns in Complex AI Agents》(2026-09-25) | |
| 时间 | 2026 年 9 月 | |
| 核心观点 | 评测不是基础设施工程,而是从人工错误分析开始的开发纪律;先看数据、再写评估器,别反过来 |
他说了什么
整份 FAQ 里最容易被忽略、但最重要的一句,是关于时间分配的。它把「评测」从一件被视为额外工作的事情,重新定义成了开发本身:
"In the projects we've worked on, we've spent 60-80% of our development time on error analysis and evaluation."
(译文)在我们参与的项目里,我们把 60% 到 80% 的开发时间花在了错误分析与评估上。
他紧接着把这句话的类比说清楚了:
"It's important to recognize that evaluation is part of the development process rather than a distinct line item, similar to how debugging is part of software development."
(译文)要认识到,评估是开发过程的一部分,而不是一个独立的预算科目——就像调试是软件开发的一部分。
这个比例会让很多人不舒服,因为它意味着「做评测」不是加一个环节,而是改变整个工作节奏。但他给出的起步方案又轻得惊人:
"Start with error analysis, not infrastructure. Spend 30 minutes manually reviewing 20-50 LLM outputs whenever you make significant changes."
(译文)从错误分析开始,而不是从基础设施开始。每次做出重大改动时,花 30 分钟人工审阅 20 到 50 条 LLM 输出。
"Use one domain expert who understands your users as your quality decision maker (a 'benevolent dictator')."
(译文)指定一位真正理解用户的领域专家作为质量裁决者,也就是一个「仁慈的独裁者」。
关于用什么标签,他的立场非常硬。行业内流行 1 到 5 分的质量打分,他认为那是在制造伪精度:
"the difference between adjacent points (like 3 vs 4) is subjective and inconsistent across annotators, detecting statistical differences requires larger sample sizes, and annotators often default to middle values to avoid making hard decisions."
(译文)相邻分值之间的差别(比如 3 分和 4 分)是主观的,在不同标注者之间也不一致;要检测出统计差异需要更大样本;而标注者常常默认选中间值,以回避做困难的决定。
"Having binary options forces people to make a decision rather than hiding uncertainty in middle values."
(译文)二元选项迫使人们做出决定,而不是把不确定性藏进中间值里。
而最反直觉的一条,是关于「通过率」的。绝大多数团队把 eval 通过率当 KPI,他直接说这是个陷阱:
"Be wary of optimizing for high eval pass rates. If you're passing 100% of your evals, you're likely not challenging your system enough. A 70% pass rate might indicate a more meaningful evaluation that's actually stress-testing your application."
(译文)要警惕以高通过率为优化目标。如果你 100% 通过评测,很可能说明你没有充分挑战自己的系统。70% 的通过率,可能才代表一次真正在压力测试应用的、有意义的评估。
背景:为什么「买一个评测平台」这条路会走偏
要理解他为什么反复强调「先看数据」,得先理解过去两年评测工具市场的形状。大量平台把「开箱即用的指标」当成卖点:相关性、忠实度、无害性、答案相似度……听起来什么都有,接上 API 就能出一张报表。问题是,这些指标大多是通用的,而通用指标不指向你产品的具体失败。
他的批评很直接:
"No. Generic evaluations waste time and create false confidence when you use them as quality measures. However, they can still help you find traces to inspect."
(译文)不。把通用评估当作质量度量,既浪费时间,又会制造虚假的信心。不过它们仍然可以帮助你找到值得检查的轨迹。
这句话里有一个很细的区分,值得展开:通用指标不是毫无用处,它的用处是检索,而不是度量。你可以用「答案相似度低」这个信号去筛出一批可疑对话,但你不能用它的分数去判断产品是否变好了。前者是找线索,后者是下结论——把两者混为一谈,就会得到一堆漂亮但和用户体验无关的数字。
这也解释了为什么他强调错误分析必须「从零开始编码」,而不是先建分类法。这是他方法论里最像社会科学的一点:先做开放式编码(open coding),逐条看轨迹、写下「这条为什么坏」,不带预设分类;再把涌现出来的问题归并成主题(axial coding);然后迭代。顺序不能反,因为一旦先建了分类,你就会只看见分类里的东西。
核心观点展开:四条可以立刻用的纪律
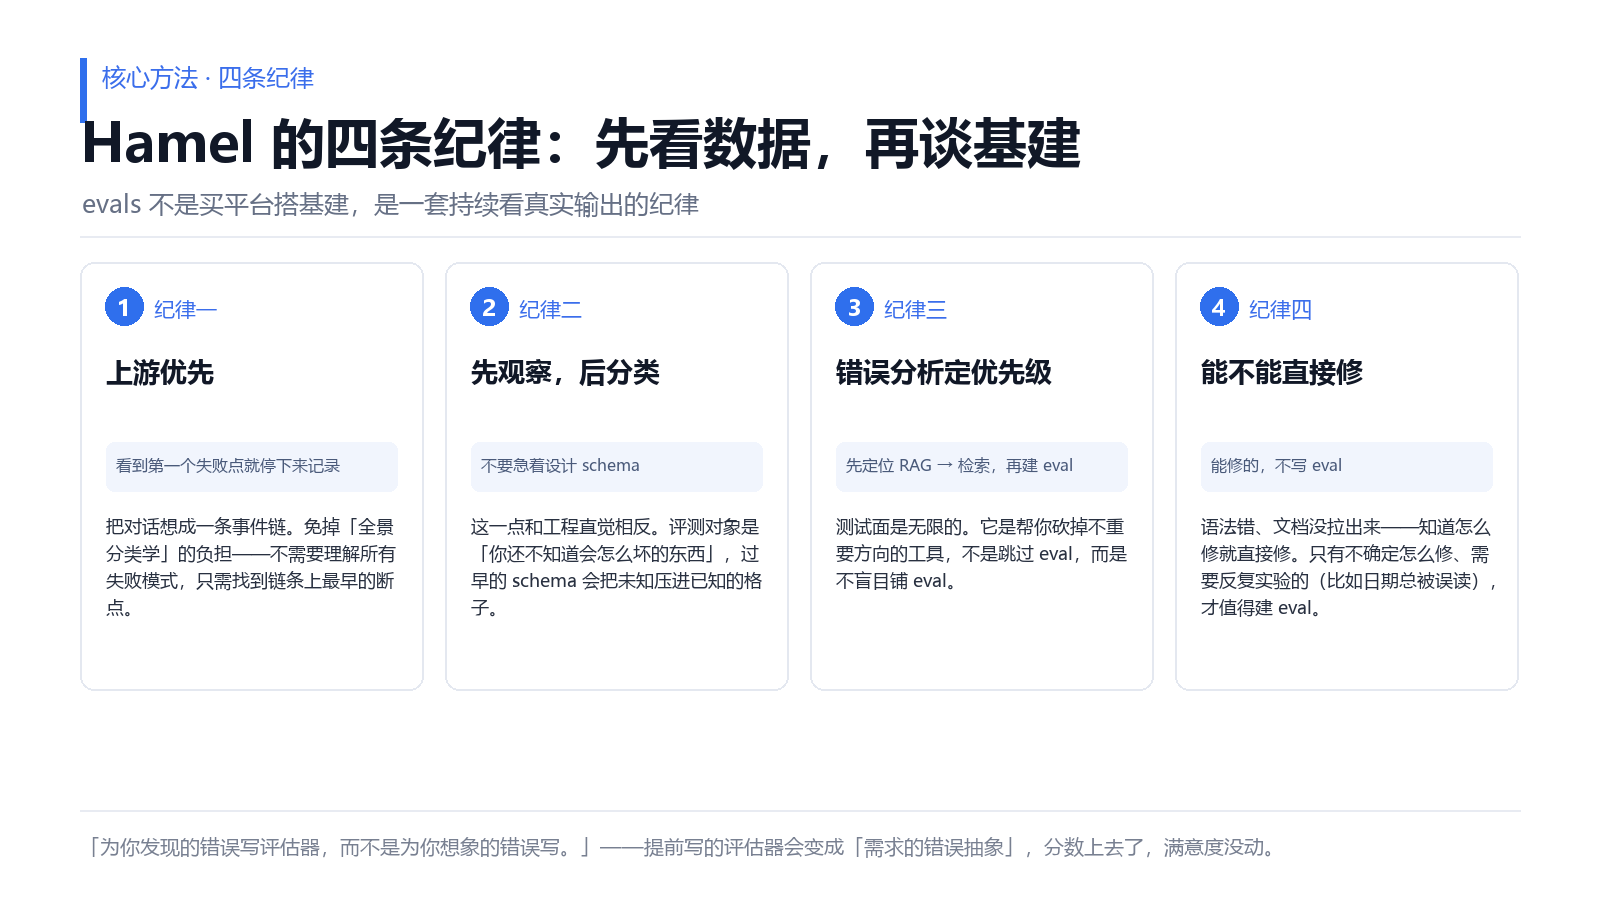
纪律一:上游优先。 把一次对话想成一条事件链:用户输入 → 检索 → 上下文拼装 → 模型生成 → 后处理 → 展示。看到第一个失败点就停下来记录,先修上游再修下游。这个启发式的好处是它免掉了「全景分类学」的负担——你不需要理解所有失败模式,只需要找到链条上最早的断点。很多团队在做的恰恰相反:盯着最终输出的措辞反复调 prompt,而真正的问题在检索阶段就没把文档拉出来。
纪律二:先观察,后分类。 刚开始做错误分析时不要急着建体系,先看、先积累直觉。这一点和工程直觉相反——工程师的本能是先设计 schema。但评测的对象是「你还不知道会怎么坏的东西」,过早的 schema 会把未知压进已知的格子里。
纪律三:让错误分析决定优先级。 测试面是无限的,错误分析的作用是帮你砍掉不重要的方向。他给了一个具体例子:面对一个 RAG 产品,先让错误分析告诉你「RAG 是问题」,再定位到「检索是问题」,然后才值得为检索搭一套 eval。不是跳过 eval,而是不盲目铺 eval。
纪律四:什么时候才该写 eval,是一道成本题。 他的判断规则很干脆:能直接修的,不写 eval——错误分析初期会看到大量明显坏掉的东西(语法错、文档拉不出来),你知道怎么修、也有信心修,直接修就好。不确定怎么修的,才写 eval。属于提示词工程或排序问题、需要反复实验的(比如日期总被错误解释),为它建 eval 再迭代。最后还有一条容易忽略的约束:注意力带宽。除了算力和 API 费用,团队能持续关注的评测集是有限的,所以要持续策展,删掉不该在里面的条目,保持高信噪比。
关于「评估驱动开发」,他的态度是明确的否定:
"Eval-driven development (writing evaluators before implementing features) sounds appealing but creates more problems than it solves. Unlike traditional software where failure modes are predictable, LLMs have infinite surface area for potential failures. You can't anticipate what will break."
(译文)评估驱动开发(在实现功能之前先写评估器)听起来很吸引人,但制造的问题比解决的多。传统软件的失败模式是可预测的,而 LLM 的潜在失败面是无限的,你无法预判什么会坏。
"Write evaluators for errors you discover, not errors you imagine."
(译文)为你发现的错误写评估器,而不是为你想象的错误写。
这个判断背后有一个常被忽视的成本:提前写的评估器会变成「需求的错误抽象」。你按想象定义了什么叫成功,然后团队开始围绕这个定义优化,最后评估分数上去了,用户满意度没动。而这正是他说的「虚假信心」的来源。
一次真实的工具测评:他试了 Claude 的自动评测插件
2026 年 9 月 30 日,Hamel 做了一件很有说服力的事:他没有停在方法论上,而是拿 Anthropic 给 Claude Code 做的 claude-api 插件(内含 build_eval 与 hill-climb 两个命令)实测了一遍,搭档是 Isaac Flath,测试数据是一家公寓租赁公司的真实对话轨迹。
他的结论分成两半。肯定的一半是「发现问题的能力」:这个插件在一次性的问题发现上,是他见过最强的一次,找出了人工交接、格式、语音代理等方面的问题。批评的一半有三条,而且都很具体:
第一,它先给你一个「建议失败清单」让你选,而这时你还没看过数据。这正好违反了他「先观察后分类」的第一原则——你从菜单里挑出来的评测项,是工具想象的失败,不是你的用户真实遭遇的失败。
第二,它要求你先验证标签,但没给足够的上下文;先是让你在一个 markdown 文件里看,后来变成看聚合后的标签计数。脱离了原始轨迹去核对标签,等于让人凭印象打分。
第三,它构建出来的评估器把四种不同的失败捆在了一个开关后面:其中一种需要 LLM 判断,另外三种代码就能查。结果是「只有四个都过才算过」——这样一个 pass 标志,会掩盖到底是哪一种失败被触发了。
他的整体判断是「暂时别用」,但也承认这个插件的作者打算更新。这个测评之所以有价值,不是因为它否定了某个产品,而是因为它把「工具能替代哪一步、不能替代哪一步」划得很清楚:发现可以自动化,判断不行。
行业内的讨论与不同声音
这套方法在社区里的接受度很高,但争议同样存在,主要集中在三点。
第一,「100% 通过率是坏信号」这条会不会被误读。 反对意见认为,对某些强约束场景(比如「绝不提及竞品」「绝不输出个人敏感信息」),100% 通过恰恰是应该追求的目标,把它说成坏信号会让人放松红线。这个批评部分成立,但 Hamel 的原意是针对能力型评测,不是约束型评测。他在 FAQ 里其实留了口子:某些「你确切知道成功长什么样」的约束,提前写评估器是可以的。把这两类混在一起谈,是误读的根源。
第二,「60-80% 时间花在评测上」在商业上是否现实。 对早期产品,这个比例意味着大幅放慢功能交付。支持者的反驳是:如果不花这个时间,你会在错误的方向上更快地跑——这两种成本只是记账时点不同。但不可否认,这个建议对「已经有明确产品市场匹配」的团队更友好,对还在找方向的团队则偏重。
第三,平台厂商与这套方法论之间的张力。 如果评测的核心是「人工看数据 + 一个 notebook + 一位领域专家」,那么评测平台的商业价值就被压缩到了「标注界面 + 数据管理」这一层。这不代表平台没用——当轨迹量到几十万条、需要多人协作与权限管理时,工具是必需的——但它确实把平台的定位从「给你答案」推回了「帮你更快地看」。
还有一个来自实践者的补充意见值得记下:错误分析最难的部分不是方法,而是让人真的坐下来看 50 条轨迹。这件事没有技术门槛,只有注意力门槛,而注意力恰恰是团队里最稀缺的资源。任何让「看数据」变得更麻烦的流程设计,最后都会被绕过。
横向扩展:为什么传统测试的那套直觉在这里失灵
把 Hamel 的方法放进软件工程的坐标系,会更容易理解它的必要性。
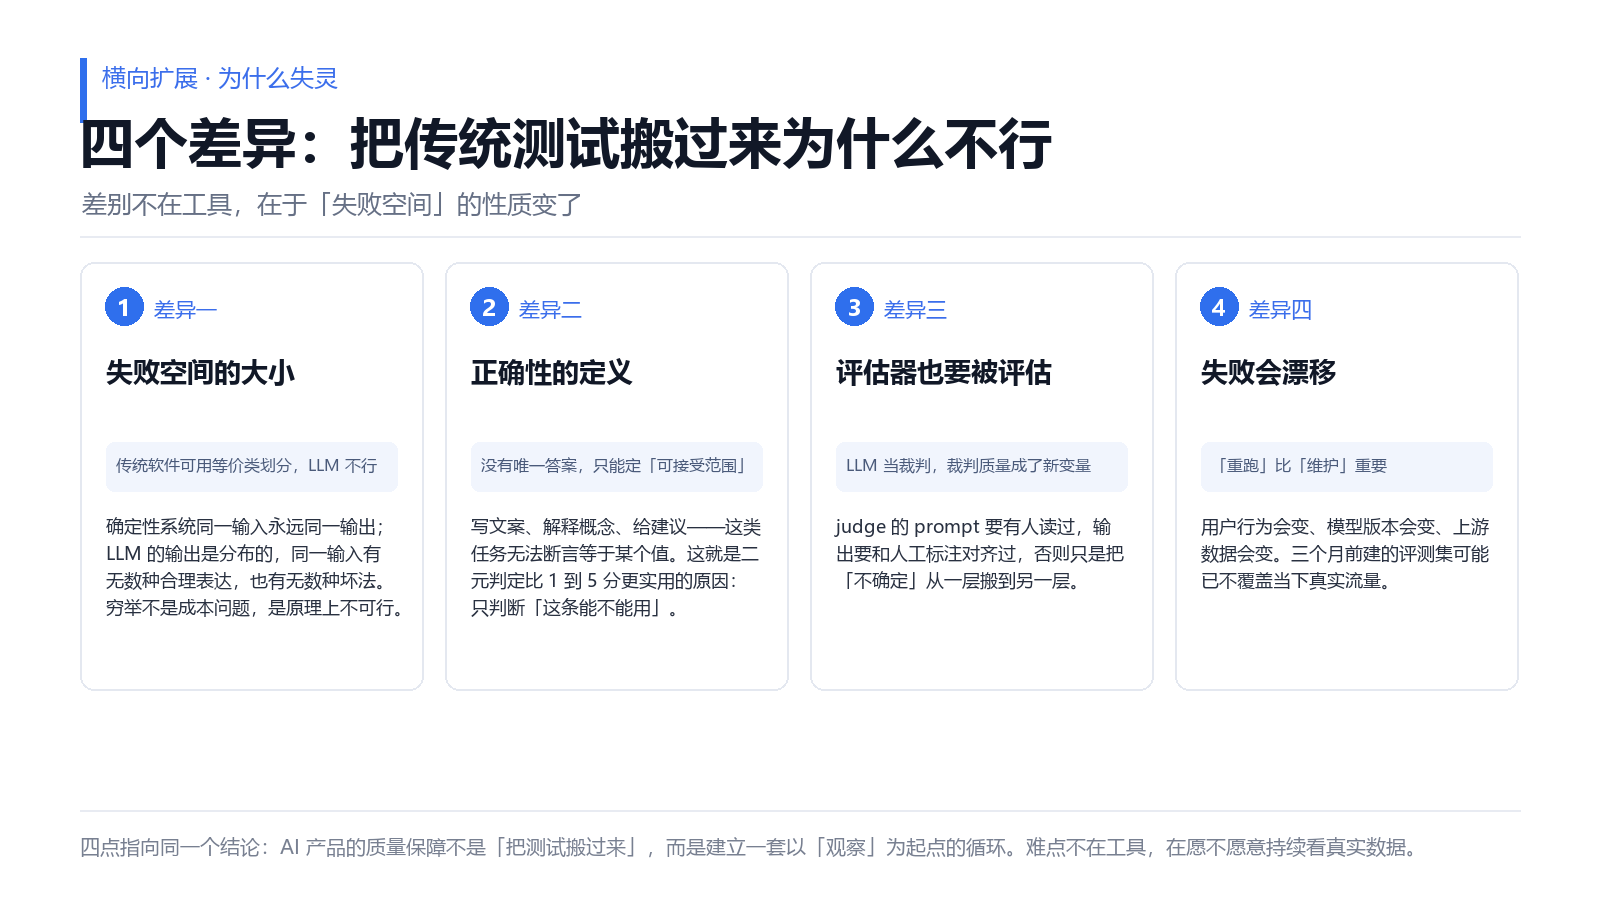
差异一:失败空间的大小。 传统软件的输入空间可以用等价类划分,因为它的行为是确定性的——同一个输入永远给同一个输出。LLM 的输出是分布的,同一个输入可以有无数种合理表达,也可以有无数种坏法。这意味着「穷举测试」在这里不是成本问题,而是原理上不可行。
差异二:正确性的定义方式。 传统测试是断言式的:结果等于某个值,或者满足某个不变量。LLM 的很多任务没有唯一正确答案(写一段文案、解释一个概念、给一个建议),只能定义「可接受的范围」。这就是为什么二元判定比 1 到 5 分更实用——它不要求你精确度量质量,只要求你能判断「这条能不能用」。
差异三:评估器本身也需要被评估。 当你用 LLM 当裁判(LLM-as-judge)时,裁判的判断质量成了新的变量。Hamel 在 FAQ 里反复强调的一件事是:judge 的 prompt 要有人读过,judge 的输出要和人工标注对齐过,否则你只是把「不确定」从一层搬到了另一层。这一点在传统测试里没有对应物——编译器不会「差不多对」。
差异四:失败会漂移。 用户行为会变,模型版本会变,上游数据会变。一份三个月前建的评测集,可能已经不再覆盖当下的真实流量。所以「重跑」比「维护」重要——数据集过时了就重跑,而不是硬撑着用。
这四点合起来,指向同一个结论:AI 产品的质量保障不是「把测试搬过来」,而是建立一套以观察为起点的循环。这也解释了为什么 Hamel 反复用「纪律」这个词,而不是「框架」——因为难点不在工具,在于团队愿不愿意持续地、结构性地看真实数据。
总结与启示
把这份 FAQ 压缩成一句可执行的话:先用 30 分钟看 20 条真实输出,再决定要不要建任何东西。
对正在做 AI 产品的团队,有四条可以马上落地。第一,把「看数据」排进迭代节奏,而不是当成一次性的项目启动工作——每次重大改动后固定 30 分钟,看 20 到 50 条真实轨迹。第二,把质量裁决权交给最懂用户的人,而不是最懂模型的人;如果找不到这样一个人,说明产品范围可能过宽。第三,用二元判定起步,别一上来就设计五级量表;等你能稳定区分「能用」和「不能用」之后,再考虑更细的维度。第四,警惕通过率——一条永远通过的评测,提供的不是质量保证,而是虚假的安全感。
对更上层的管理者,这份材料的价值在于它重新定义了「评测」在组织里的位置。它不是一个可以由平台采购来外包的职能,也不是上线前的一道关卡;它是团队理解用户的方式。当一个团队说「我们的 eval 覆盖率很高」时,更该问的是:这些 eval 是从哪来的?是从数据里长出来的,还是从会议室里想出来的?
最后一层启示关于工具与人的边界。Hamel 对自动评测插件的测评,给出的结论其实适用于所有 AI 工具:发现可以外包,判断不能。 工具能帮你从几千条轨迹里找出可疑样本,但它没法替你决定哪一条失败最伤用户。而这个决定,恰恰是产品能力的核心。
