2026 年 7 月 17 日,在上海世界人工智能大会(WAIC)的思想者论坛上,一位身着中式传统纹样衬衫的老人缓缓走上讲台。他是 Richard Sutton,强化学习领域的奠基人、2024 年图灵奖得主。在全行业都在追大模型、追 Agent 的当口,他说出的话显得格格不入,却又格外值得认真对待:大语言模型,本质上只是「人类已达成共识知识的容器」,而不是能创造新知识的科学家。
速览卡:这位大佬和他说了什么
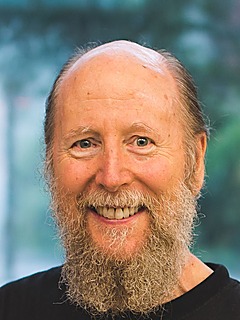 | 大佬 | Richard S. Sutton(理查德·萨顿) |
| 身份 | 强化学习之父、2024 图灵奖得主、阿尔伯塔大学教授、Oak Lab 联合创始人 | |
| 出处 | WAIC 2026 思想者论坛主旨演讲《The Bitter Lesson of AI Research》;Sequoia Capital 播客访谈 | |
| 时间 | 2026 年 7 月 17 日(WAIC 演讲);2026 年 8 月 18 日(Sequoia 播客) | |
| 核心观点 | 基础模型是「人类共识知识的容器」而非知识创造者;合成数据是「巨大的错误」;真正的智能需要持续在线学习 |
Sutton 说了什么
要理解 Sutton 这次的判断,得先回到他那篇只有一页半、却在 AI 圈流传了七年、被引用了无数次的短文——《The Bitter Lesson》(《苦涩的教训》,2019 年)。他在 WAIC 演讲的开头,直接引用了这篇文章的最后一段作为整场发言的注脚。这篇文章的核心,是一个他观察了 70 年的历史规律:
We have to learn the bitter lesson that building in how we think we think does not work in the long run. The bitter lesson is based on the historical observations that (1) AI researchers have often tried to build knowledge into their agents, (2) this always helps in the short term, and is personally satisfying to the researcher, but (3) in the long run it plateaus and even inhibits further progress, and (4) breakthrough progress eventually arrives by an opposing approach based on scaling computation by search and learning. The eventual success is tinged with bitterness, and often incompletely digested, because it is success over a favored, human-centric approach.
(译文)我们必须吞下这苦涩的教训:把我们自认为的思考方式硬编码进系统,长期看是行不通的。这条苦涩的教训基于几个历史观察:(1) AI 研究者总是试图把知识塞进他们的智能体里;(2) 这在短期内总是有用,也让研究者本人很有成就感;但 (3) 长期来看它会进入平台期,甚至阻碍进一步进展;(4) 真正的突破最终来自一条相反的路径——通过搜索和学习来规模化算力。最终的成功总带着苦涩,而且常常没有被充分消化,因为它战胜的是一种偏爱的、以人类为中心的方法。
所谓「苦涩」,在于一个反复出现、让研究者心碎的模式:研究者总想把人类知识直接编码进智能体里,这种做法短期内往往有效,也符合直觉,所以很受欢迎;但从长期看,它终究会遇到瓶颈。真正带来突破的,永远是另一条更「笨拙」、却更依赖算力的路径——大规模搜索和学习。国际象棋如此,语音识别如此,计算机视觉如此,自然语言处理也是如此。每一次,人们精心设计的方法,最终都被一个「更笨但更大」的方案取代。
但 Sutton 这次在 WAIC 上想讨论的,是一个更尖锐的问题:这个延续了 70 年的规律,是否同样适用于今天的大语言模型、今天的基础模型?他的回答是——是,也不是。
大语言模型确实继承了「苦涩的教训」,找到了持续扩展计算规模的方法,这是它「对」的一面。但它最大的超能力——来自人类知识,也可能成为它最大的边界。因为它存储的是人类已经达成共识的知识,而不是尚未被发现的真理。
背景:一位 40 年判断从未随风飘移的人
Sutton 说这些话的分量,来自他近乎偏执的判断一致性。
1988 年,他的博士论文就在研究强化学习里的「时序信用分配」,那时这还是无人问津的冷门领域。他和 Andrew Barto 合著的《强化学习:导论》是全球从业者的标准教材。2024 年,他和 Barto 共同获得图灵奖,表彰他们对强化学习的奠基性贡献——这条研究线直接推动了 AlphaGo 和现代大规模强化学习系统的发展。
更难得的是,他 40 年的判断几乎没有随风飘移过:当业界信奉规则方法时,他研究统计学习;当所有人转向统计学习时,他坚持规模化通用方法;当全行业扑向大模型时,他继续追问「这条路的天花板在哪里」。这种一致性,让他的质疑比大多数「唱反调」的声音更有分量。
在 WAIC 演讲之前几天,他刚刚宣布创立 Oak Lab,离开了 John Carmack 的 Keen Technologies,选择在加拿大独立运作。Oak Lab 的创立声明里有一句很硬的话:当下的深度学习方法「弱且低效,需要根本性的新思路和彻底的重构」,而不是更多的调参。WAIC 是 Oak Lab 成立后的首次公开亮相——也就是说,Sutton 是在用自己的创业,为他的研究立场押注。
核心观点展开:三个环环相扣的论点
Sutton 在 WAIC 的演讲,围绕三个相互关联的论点展开。
论点一:苦涩教训在当下是否还成立?他先确认了大语言模型「对」的一面——它确实找到了一种能随算力扩展的方法,充分利用了今天的大规模计算资源和互联网产生的海量数据。从这个意义上说,大语言模型的成功本身就是「苦涩教训」的一次胜利。但「不是」的一面更关键:基础模型的能力归根结底建立在人类已有知识之上,它本质上还是在「吃人类积累的老本」。用他的话概括就是——规模化了,但规模化的对象可能错了。
论点二:大世界假说(Big World Hypothesis)。这是 Sutton 和学生 Khurram Javed 在 2024 年共同提出的理论:世界的规模和复杂度,永远超过任何单一智能体的认知上限,没有任何心智能完整掌握世界的全部知识。他用现场的听众举例:哪怕面对面交流,他也不可能完全知道每个听众脑海里在想什么——这种信息差是结构性的,是世界本身的属性,而不是技术问题。这个假说还带来一个意外副产品:它从底层消解了「超级 AI 全面超越人类」的恐慌——如果世界永远比任何智能体复杂,全知超心智这种存在本身就违背大世界假说。
论点三:基础模型的合理定位。基于前两点,Sutton 给出了他对「基础模型」的重新定义。他认为行业里大量从业者用这个词,却没想清楚它到底该是什么。他的定义是:基础模型是「当前所有已达成共识的人类知识的容器」,它的终极形态是一部「超级百科全书」——让知识更容易被获取,并根据不同用户的认知水平定制化呈现,边界清晰:存储与提供访问,而非生成新知识。Sutton 特别强调,当下大模型的幻觉问题,本质上是因为模型被赋予了超出这个定位的期待——让它去生成边界之外的内容。
行业内的讨论与不同声音
Sutton 的这套判断,在行业里激起的反应很值得记录,因为它戳中的恰恰是当下最敏感的两根神经:合成数据和持续学习。
在 2026 年 8 月的 Sequoia Capital 播客访谈里,Sutton 和 Khurram Javed 把话说得更直接。当被问到「合成数据能否突破数据瓶颈」时,Sutton 毫不含糊地回答:
不,那纯粹是一个巨大的错误(a big mistake)。
他的理由来自大世界假说:世界无限复杂,任何人类写的模拟器都只是「微观」的近似。一个小程序只能生成一个小世界,它和真实世界不匹配——错误的摩擦系数、不准确的机器人电机模型。更关键的是,世界里有无数其他智能体,它们的内在运作根本无法被生成为合成数据——「别人的脑子,我们没法生成合成数据」。此外还有人力瓶颈:谁来判定哪份合成数据好、哪份坏?按 Javed 的说法,这需要人类专家,于是整个方案又被「人类」卡住了脖子,无法真正扩展。
另一个被 Sutton 反复批评的点,是大模型「上线后就不学习了」:
我们在模型发布前做了太多预训练和后训练,但上线之后它就停止学习了。它们的权重根本没变过。如果你认为可以打造出一个拥有博士级专业能力、但此后却彻底不再学习的系统,那真正奇怪的是你们。
他用一个特别扎心的问题反问:「没有任何动物是靠监督学习长大的。」学校是一种非常特殊的机制,人类几百年前甚至还没有现代学校,它根本不是智能的本质。松鼠不去上学,也能学会生存。把监督学习当成学习的主要范式,是本末倒置。
面对满世界的质疑,这位经历过上一次 AI 寒冬、曾从癌症晚期死里逃生的老学者态度很坚决,说出了一句流传很广的话:
我没疯,是这个领域疯了。(I’m not weird. The field is weird.)
横向扩展:Oak Lab、持续学习与「苦涩教训」的下一章
Sutton 的批评如果只停留在「唱反调」,价值有限。真正让人重视的,是他连「解法」都一并给出了,而且正在用 Oak Lab 把它做出来。
Oak Lab 的架构核心是三个原则。第一是领域通用性:系统内不包含任何领域专用知识,完全通用。第二是经验学习:从运行时的经验中学习,而不是依赖设计时工程进去的静态知识。第三是开放式演进:在算力约束内无限提升,没有能力天花板。它的激进目标,是做一个「万亿参数、实时学习、能耗只有 20 瓦(接近人脑水平)」的智能体。
这条路线有一个技术上的硬骨头:灾难性遗忘。Sutton 认为,真正的持续学习,就是「学习」本身——因为「所有学习都是持续的」,只不过现在的系统学新东西会把旧知识抹掉,所以才需要专门造一个「持续学习」的词来和「批量学习」区分。他的团队在 Nature 上发表的「Continual Backprop」(持续反向传播)方法,是解决这个问题的一条路径:为每个网络权重学习元学习步长,并持续引入新的特征单元,让网络在学新东西时不至于把旧的冲掉。
这套思路可以追溯到他的「Alberta Plan」。这个计划的第二步是「持续深度学习」——他认为这是解锁后面所有步骤的关键。最终目标,是让机器像人一样,在自己的生命过程中不断学习、不断成长,在自己所经历的那部分世界里逐渐形成专长。
把这几件事串起来,Sutton 的完整图景就清楚了:他认为大模型是「智能的四分之一」——一个了不起的科学突破,但只占智能的一小块。真正完整的智能,应该是一个能持续与环境交互、边行动边学习、自己构建并修正世界模型的动态系统,而不是一个训练完就冻结权重的静态模型。他特别强调一个当前领域的空白:
在我们的领域里,还没有「学习模型、然后用模型做规划」的先例——至少没有用自我发现的抽象来做这件事的先例。
这和强化学习的「模型基方法」(model-based RL)一脉相承,也和 LeCun 的世界模型主张、David Silver 近年对「从人类生成数据转向智能体-环境交互数据」的探索形成了共振——几位不同阵营的大佬,在「持续学习 + 世界模型」这个方向上,意外地走到了一起。
把《苦涩教训》读透:两个被大多数人忽略的细节
Sutton 在 WAIC 上引用了《苦涩教训》原文,但多数人其实没细读过这篇只有 1500 词、却极其精准的短文。它里面有两个细节,恰恰是理解 Sutton 整个思想体系的关键,也常常被二手解读丢掉。
第一个细节:算力成本在持续指数级下降,这改变了「最优解」的定义。研究者设计算法时,往往默认算力是固定的,于是用人类知识去弥补算力的不足。但历史的真相是:算力成本在持续指数级下降。这意味着,「今天在算力受限下的最优解」,迟早会被一个「更笨但更吃算力」的规模化通用方法取代。你花了多年打磨的精巧方法,被一个更笨、但能随算力扩展的方案彻底替换——这正是「苦涩」的来源。它不是「人类知识没用」,而是「人类知识撑不起长期的价值」,因为它的相对价格会随着算力变便宜而不断贬值。
第二个细节:心智的内容无法被简化,也不该被「设计进去」。Sutton 的原话指向一个根本性的判断:空间、物体、多个智能体——这些都是外部世界的属性,是任意复杂的,不应该被「设计进」系统里。真正该做的是构建「能自己发现这些复杂性的元方法」,而不是「把我们已发现的东西直接放进去」。他有一句特别值得记住的话:
我们想要的 AI 智能体,是能够像我们一样去发现,而不是装载了我们已经发现的东西。把我们的发现直接植入,只会让「如何去发现」这件事变得更难。
这两个细节合起来,就解释了为什么 Sutton 会对「把人类知识塞进模型」这件事如此警惕——不是因为人类知识没用,而是因为「植入知识」这个动作本身,会让系统错过「自己发现知识」的能力。这也正是他把基础模型定义为「共识知识的容器」、而非「知识创造者」的深层原因:容器装的是「已发现的东西」,而智能的本质,是「能去发现」。
这四个历史领域印证了这条规律的普适性:计算机象棋——早期基于棋理的专用方法,被大规模搜索加算力全面击败(1997 年击败卡斯帕罗夫的 Deep Blue 靠的是搜索而非棋理);计算机围棋——AlphaGo 最终靠大规模强化学习和自我对弈取胜,而非围棋专家知识;语音识别——统计方法取代语音学规则,深度学习又取代统计方法,两轮迭代如出一辙;自然语言处理——从语言学规则到统计方法再到大规模机器学习,三轮迭代,每次都是通用规模化方法胜出。
Sutton 的完整思想图谱:从苦涩教训到 Oak Lab 的连贯主线
如果只看孤立的一次演讲,很容易把 Sutton 当成一个「唱反调的老人」。但把他的思想串起来,会发现这是一条贯穿 40 年、逻辑自洽的主线。
这条主线的起点是《苦涩教训》(2019):长期看,只有随算力扩展的方法(搜索、学习)才能赢,依赖人类知识的方法会撞墙。接着是《大世界假说》(2024,与 Javed 合作):世界永远比任何心智更复杂,所以「静态预训练」永远不够,必须在路上学。再到 2025 年和 David Silver 的合作方向:AI 应该从「人类生成数据」转向「智能体-环境交互数据」。最后到 2026 年的 Oak Lab:把这些理论变成一个「万亿参数、实时学习、20 瓦能耗」的持续心智系统。
这条主线里,最值得关注的是「从人类数据转向交互数据」这个转折。Sutton 和 Silver 的判断是:人类生成的数据(文本、标注)是有限的、有偏的、迟早会用完的;而智能体与环境交互产生的数据是无限的、可自我生成的。这是「持续学习」路线的数据基础——如果一个系统能自己产生自己的训练信号,它就不再依赖「喂给它的数据」了。这恰恰呼应了《苦涩教训》的核心:不要依赖人类提供的东西,要依赖能随规模扩展的东西。
在 Sequoia 的播客里,Sutton 还给出了一个非常具体的、关于「当前领域空白」的判断。他说,学习一个模型、然后用这个模型做规划,这在当前的 AI 里几乎没有先例——至少没有「用自我发现的抽象来做规划」的先例。这听起来有点反直觉(AlphaGo 不就是「学习 + 规划」吗?),但 Sutton 的精确意思是:AlphaGo 的「模型」和「规划」用的还是人类设计的抽象(棋盘、规则),而不是系统「自己发现」的抽象。真正的突破,需要机器自己形成新的抽象,并用这些抽象去规划、推理,而不是用人类手工设计的模型和监督信号。
把这个思想图谱放在 2026 年的时间点上,Sutton 的定位就非常清楚了:他不是反对大模型本身(他称之为「了不起的科学突破」),而是反对「把大模型当成智能的终点」。在他眼里,大模型是「智能的四分之一」,是通往真正智能的一块重要垫脚石,但绝不是终点。终点是一个能持续学习、能自己发现抽象、能用这些抽象做规划的动态系统。
总结与启示
Sutton 这次发言的价值,不在于他预言了「大模型的终结」,而在于他提出了一个被行业集体回避的根本问题:当 AI 的全部力量都建立在「人类已知的知识」之上时,那些尚未被发现的知识,又将从哪里诞生?
对从业者,这里有几个可以立刻吸收的启示。
其一,对「幻觉」有新的理解角度。按 Sutton 的框架,减少幻觉的正确思路,不是让模型「更聪明」,而是让它更清楚地知道自己的边界、拒绝回答边界外的问题。这对 RAG 设计、Prompt 工程都有直接的实践指导意义——你的系统应该是一个「准确的共识知识提供者」,而不是一个「无所不知的回答者」。
其二,对「大模型能做什么」保持清醒预期。把它定位成「超级百科全书」,而不是「万能员工」,能避免很多不切实际的投入。同时要看到,持续在线学习是被严重低估的方向——它才是解决「幻觉」和「知识过时」的根本路径之一。
其三,警惕合成数据的幻觉式扩展。当互联网数据不够用时,用算法生成合成数据看似是自然的下一步,但 Sutton 的提醒值得记在心里:合成数据的世界永远小于真实世界,它可能让你在「看似足够」的地方停下来,而真实世界的复杂度还在门外等着。
最后,Sutton 用一句话给这场发言留了开放式的结尾,也留给了整个行业:「地图可以画得越来越完整,却永远无法提前画出下一块大陆。」这既是对大模型的评价,也是对所有宣称「已经找到了通往 AGI 唯一道路」的人的一句提醒。
参考来源
- Richard Sutton《The Bitter Lesson》原文:http://www.incompleteideas.net/IncIdeas/BitterLesson.html
- WAIC 2026 思想者论坛主旨演讲《The Bitter Lesson of AI Research》(AI 科技评论实录)
- The Decoder《KI-Pioneer Sutton calls synthetic data a “big mistake” in the face of an infinitely complex world》
- Sequoia Capital 播客《Training Data – Rich Sutton & Khurram Javed: Why AI Models Stop Learning》
- Sutton & Javed《The Big World Hypothesis》2024
