2026 年 10 月的第三周,开放权重模型市场经历了一次久违的密集发布:10 月 15 日 Meta 放出 Muse Spark Open,同周 Reflection 与 Hugging Face 联合发布 Beam,Mistral 也宣布了 Mistral Large 4(只给分数,没放权重)。三天后的 10 月 18 日,DeepSeek 的 V4.1-Flash-1017 又把这条线往前推了一格。Nathan Lambert 在 10 月 17 日的 Interconnects 通讯里给这一周下了判断,那句话后来被反复引用:美国开放权重「从基本无关,变成了落后但可用」。
速览卡:这位大佬和他说了什么
 | 大佬 | Nathan Lambert |
| 身份 | 开放模型研究者,Interconnects 通讯作者,前 Ai2 OLMo 团队负责人,现主持非营利机构 Trillium Labs | |
| 出处 | Interconnects《Meta shakes up the frontiers, open and closed》(2026-10-17);哈佛 AI Safety 课程讲座(2026-10-22) | |
| 时间 | 2026 年 10 月 | |
| 核心观点 | 美国开放权重与中国的差距大约缩小一半,但自定义许可证(署名要求 + 营收门槛 + 约束输出)是真正的战略风险;前沿模型的单模型成本已进入十亿美元量级 |
他说了什么
Lambert 的开篇是一个明确的定性:这一周改变的是「平衡」,而不只是多了一个模型。
"This has been a week where the balance of American open-weight models took a step change back toward the frontier."
(译文)这是美国开放权重模型的天平朝前沿方向发生一次台阶式变化的一周。
他紧接着给了一个更有冲击力的反事实:
"Without these two models, there would be 20+ open-weight models built and released by Chinese companies better than the best Western models."
(译文)如果没有这两个模型,就会有 20 多个由中国公司构建并发布的开放权重模型,强于西方最好的模型。
而他对「差距缩小」的量化,用的是一个很克制的说法:
"In many ways, the gap between the best American and Chinese models has been reduced roughly by half. We've gone from the best American open models being largely irrelevant to consumers who require the cutting edge of performance, to them being behind but relevant."
(译文)在很多方面,美国与中国最好模型之间的差距已经大约缩小了一半。我们已经从「美国最好的开放模型对追求前沿性能的用户基本无关」走到了「落后,但仍然相关」。
关于 Muse Spark Open 本身的能力定位,他没有用「最强」这种笼统说法,而是给了一个坐标:
"Muse Spark Open is now the strongest American-made open model by quite some margin"
(译文)Muse Spark Open 现在是美国制造的开放模型里明显最强的一个。
至于这份能力在全局里的位置,他的判断是:
"Its performance falls somewhere above GLM 5.2, near DeepSeek V4.1 Flash, and behind GLM 5.3 or Kimi K3."
(译文)它的性能大致在 GLM 5.2 之上、接近 DeepSeek V4.1 Flash,但落后于 GLM 5.3 或 Kimi K3。
最尖锐的一段,是谈许可证的。他没有绕弯子,直接把这份自定义协议称为「不必要的战略风险」:
"If anything will hold Muse Spark Open back, it'll be the specific license they designed for it."
(译文)如果有什么会拖住 Muse Spark Open,那就是他们为它专门设计的那份许可证。
"This is why we think it's an unnecessary strategic risk for labs trying to compete and regain adoption to have complex, non-standard open licenses for their models."
(译文)这就是为什么我们认为,对于想竞争、想重新赢回采用率的实验室来说,给模型配上复杂、非标准的开放许可证,是一种不必要的战略风险。
背景:开放权重为什么忽然变成了主战场
要理解这一周的分量,得先理解过去两年开放权重市场的结构变化。
第一层变化是「需求端的性质变了」。早期人们要开放权重,主要动机是省钱和可私有化部署;而现在,随着开放式智能体(open agents)真正可用,企业开始需要「在自己基础设施上跑一个能连续执行任务的模型」——这不只是成本问题,而是数据边界与可控性问题。Lambert 在文里点出了这一点:
"Western open models get far more adoption than Chinese ones at the same performance-per-size, and demand for open inference is rising as open agents become real."
(译文)在同等「性能/规模」比下,西方的开放模型获得的采用远多于中国的模型;而随着开放式智能体成为现实,对开放推理的需求正在上升。
第二层变化是「供给端的成本结构」。前沿模型的单次训练成本已经高到只有少数公司能承受:
"the costs of building true frontier models are now measured in billions per major model and only huge companies can sustain that."
(译文)构建真正的前沿模型,成本,现在已经以「每个主要模型十亿美元」来计量,只有巨型公司才能持续承担。
这两层叠加,导致一个反直觉的结果:开放权重不再是「小团队的游戏」,而变成了大公司的战略选项。Meta 是这一轮里唯一同时发布前沿闭源模型(Muse Wonder 系列)与前沿开放权重模型的公司——Lambert 特别强调了这一点,因为它在结构上改变了过去「开放等于落后一代」的默认假设。
第三层变化在模型本身的设计取向。Muse Spark Open 是一枚混合专家(MoE)模型,总参数 816B、每 token 激活 42B,上下文 100 万 token,原生多模态,官方定位是「为编码与智能体工作而构建」。这个规格组合说明它不是在追求「参数量最大」,而是在追求「激活成本可控 + 长上下文 + 工具使用」——正好对应开放智能体的真实负载。
核心观点展开:四个判断,一个警告
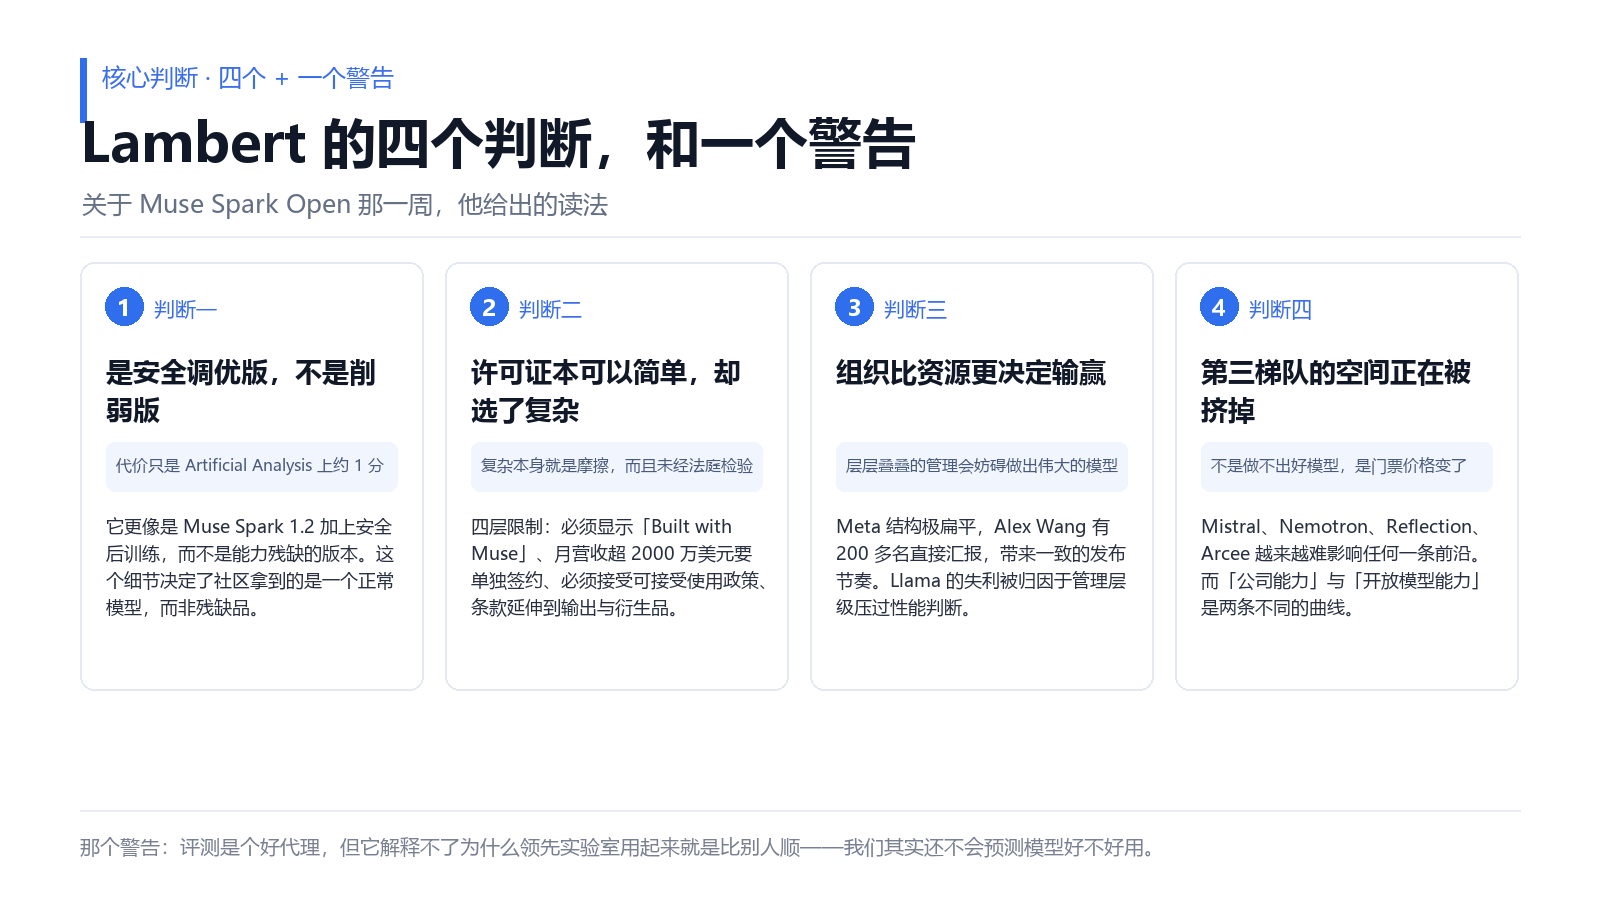
判断一:这次是「安全性调优」,不是「被削弱的版本」。 因为 Muse Spark Open 发布在闭源的 Muse Spark 1.3 之后,很多观察者怀疑它是在安全训练中被「弄坏」的模型。Lambert 的读法相反:它更可能是 Muse Spark 1.2 的一个安全调优版本,代价只是 Artificial Analysis 上大约 1 分的下降。他给出的旁证是:Meta 在发布 30B 的智能体模型 Muse Glimmer 时,Alex Wang 曾表示准备把 Muse Spark 1.2 以开放权重形式放出。这个细节很技术,但它决定了一件事——社区拿到的是一个「正常模型 + 安全后训练」,而不是一个能力残缺的版本。
判断二:许可证明明可以简单,Meta 选择了复杂。 他逐条列出了这份自定义协议的四层限制:产品里必须显示「Built with Muse」;月营收超过 2000 万美元的公司部署该模型需要单独签约;必须接受一份可接受使用政策(这在真正的开源定义下,等于「极度不开源」);以上条款还延伸到模型的输出与衍生品,导致「能不能用它生成合成数据」在法律上含糊。他的结论是,这份协议虽然允许内部研究与自用,但复杂度本身构成了摩擦。
更值得记的是他对「许可证到底有没有用」的观察。他承认现实是:
"We're at a weird equilibrium where this license is complex and unproven in court, but many players will likely ignore it."
(译文)我们处在一个奇怪的均衡里:这份许可证既复杂、又未经法庭检验,但很多参与者很可能会忽略它。
这句话点出了一个被低估的事实:许可证的约束力,取决于执行意愿与执行成本。当规避的成本远低于遵守的成本时,条款就变成了一种「选择性执法」的工具——它约束的是守规矩的大公司,而拦不住真正想绕开的人。这也是他称之为「战略风险」的原因:它伤到的是采用率,而不是滥用。
判断三:组织比资源更能解释输赢。 这一段是全文最不像技术分析、但最有信息量的部分。他提到 Meta 的结构非常扁平——Alex Wang 有 200 多名直接汇报对象——而这种扁平带来的是一致的发布节奏。反过来,他把 Llama 的失利归因于管理层级与内部因素压过了性能判断:
"Layers of management easily get in the way of making a great model."
(译文)层层叠叠的管理很容易妨碍做出一个伟大的模型。
这个判断对所有做模型的组织都成立,只是在大公司里更明显。它解释了一个现象:为什么资源相近的实验室,产出节奏会差出一年。
判断四:第三梯队的空间正在被挤掉。 他把 Mistral、Nemotron、Reflection、Arcee 这类玩家归为「tier 3」,并指出它们越来越难影响任何一条前沿——不是因为他们做不出好模型,而是因为前沿的门票价格变了。同时他给出了当前的力量排序:
"The ranking would be Anthropic > OpenAI > Meta ~ Gemini > xAI ~ Chinese Open Weights > U.S. Open Weights."
(译文)排序大致是:Anthropic > OpenAI > Meta ≈ Gemini > xAI ≈ 中国开放权重 > 美国开放权重。
注意这个排序里有一个反直觉的位置:Meta 的闭源模型被放在与 Gemini 同级,而它的开放权重模型单独排在最后一档。也就是说,「公司能力」与「开放模型能力」是两条不同的曲线,不能用前者推断后者。
那个警告:我们其实不会预测模型好不好用。 他在文末承认了一件让整个评测行业不太舒服的事:
"evaluations are a good proxy, but why do the leading labs like Anthropic go from hit models like Claude Fable 5 to total duds in Claude Opus 5 and then back to hits with Opus 5.5? ... the models fundamentally still are largely unknowable in the long-tail."
(译文)评测是个不错的代理指标,但为什么像 Anthropic 这样的领先实验室会从 Claude Fable 5 这样的爆款,掉到 Claude Opus 5 这样的失败,再回到 Opus 5.5 的成功?……在长尾场景里,模型从根本上仍然相当不可知。
这段话对做选型的团队特别有用:它说明「跑分高」和「在你的场景里好用」之间,存在一段无法用公开评测填补的距离。唯一可靠的办法还是自己测。
行业内的讨论与不同声音
这套判断在社区里获得了广泛引用,但也立刻遭遇了三次检验。
第一次检验来自跑分。 Artificial Analysis 给 Muse Spark Open 的智能指数是 39 分,是美国开放模型里的第一,但落后于 GLM-5.3 的 45 分和 Kimi K3 的 44 分;更值得注意的是,在一组智能体评测里,它在排名前九的开放模型中垫底。这个结果和「明显最强的美国开放模型」并不矛盾——它说的是「美国阵营内的相对位置」,而不是「全球绝对位置」。但它确实提醒读者:Lambert 的乐观是有条件的,他说的「相关」不等于「领先」。
第二次检验来自时间。 他 10 月 17 日说差距「大约缩小一半」,10 月 18 日 DeepSeek 的 V4.1-Flash-1017 就发布了,把那条线又往前推了一格。这件事本身就是对「差距」这个概念的讽刺:在一个以周为单位移动的市场里,任何静态的差距估计都会迅速过期。Lambert 自己在文里也承认,他在等一个问题的答案——「Kimi 和智谱自 8 月 18 日、7 月 16 日发布 GLM-5.3 与 Kimi K3 之后,这段时间去哪了?」
第三次检验来自他五天后自己的讲座。 10 月 22 日,他在哈佛的 AI Safety 课程上给了一场 48 分钟的开放模型讲座,给出的数字比通讯里更细:按 Artificial Analysis 的口径,开放模型落后闭源前沿大约 3 个月;按 Epoch AI 的软件工程指数,大约 5 个月;而美国的开放模型还要再落后 3 到 4 个月。与此同时,他引用的估算显示,领先的美国实验室拥有的算力大约是中国同行的 10 倍。这组数字放在一起,构成了一个需要解释的谜题:为什么算力差 10 倍,差距却只有几个月?
他对这个谜题的回答,是拒绝最省事的解释。行业内流行「中国实验室靠蒸馏(从 API 里提取推理轨迹来训练)」这个说法,他承认这类团队确实存在,但认为它解释不了全局:公开研究并没有显示「借用推理轨迹」能带来轻松的性能跃升,而强化学习的作用在变大。他给出的最硬的一个证据是小米把 MiMo-V2.6 的训练过程公开直播:Pro 版本在 5 天 7 小时里跑了 30 个强化学习步,处理 750 亿 token,成本 262 万美元;小一号的 Flash 版本是 85.4 万美元。他的结论是:即使蒸馏被禁,这些团队依然是强竞争者,因为「快速跟随」所需的算力远低于「推前沿」。
还有一类质疑针对「开放」这个词本身。 批评者指出,Muse Spark Open 这类模型只能叫「权重可用」,不能叫「开源」:训练数据不公开、训练代码不公开、许可证还带使用限制。这与 OSI 的开源定义(允许任意使用、修改、再分发,不得对使用领域或人群设置限制)相冲突。支持者的反驳是,「开放权重」本来就是一个比「开源」更宽的谱系,用开源的标准去要求它,会让愿意放权重的大公司干脆不放。这场定义之争短期内不会有结论,但对企业的实际影响很直接:法务在评估时看的不是「是不是开源」,而是「这份许可证允许我们做什么」。
横向扩展:开放模型的四个层次与许可证光谱
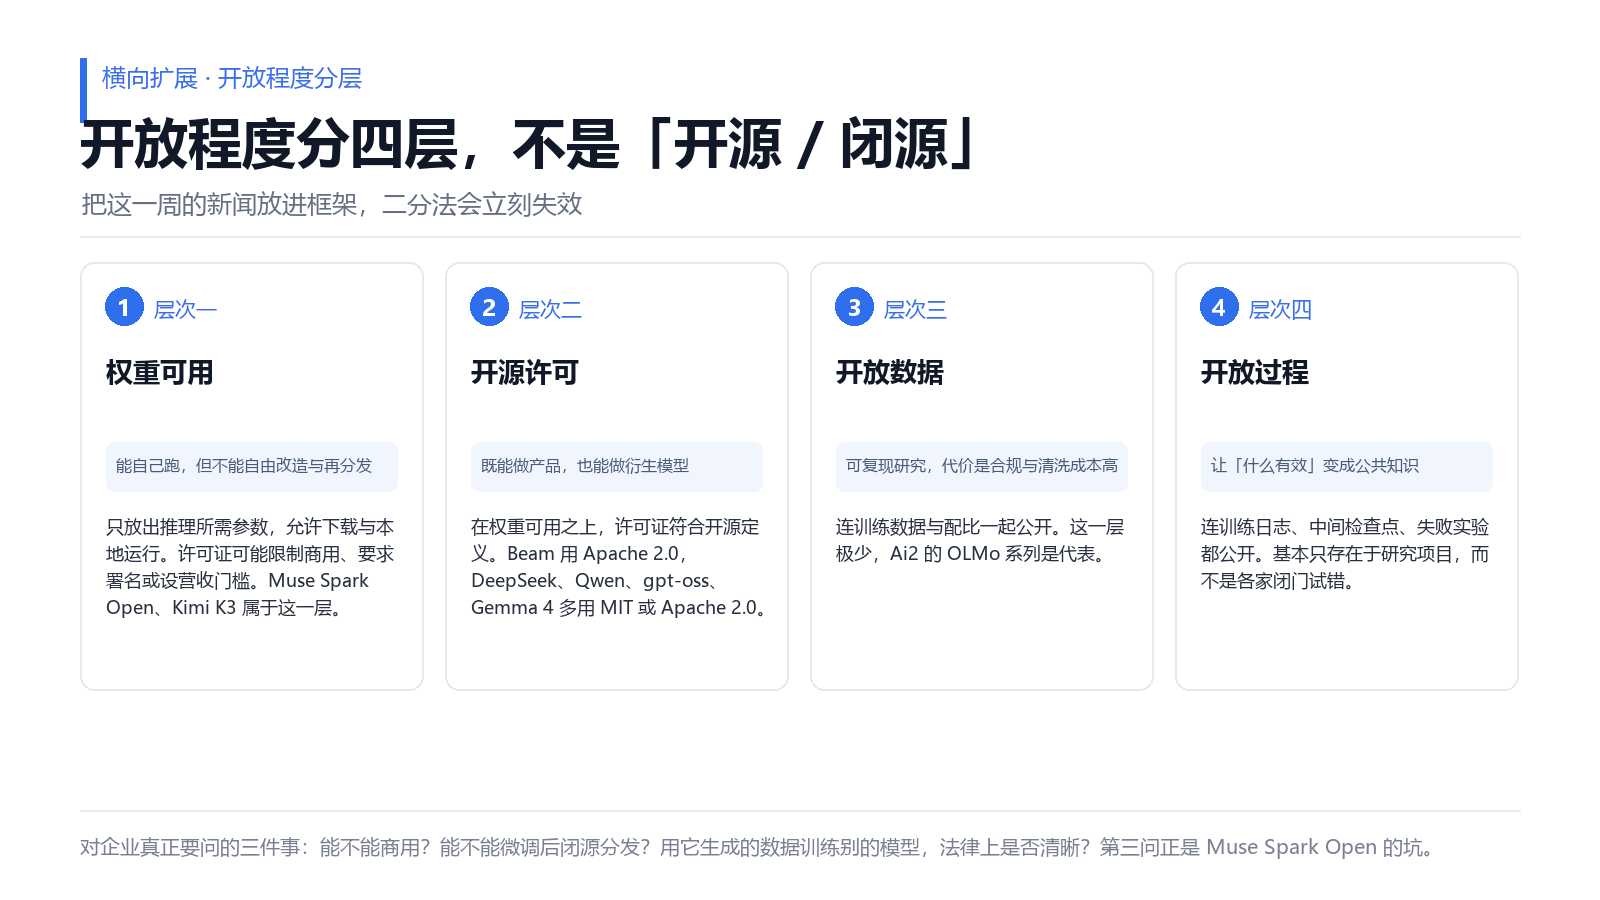
要把这一周的新闻放进框架,最好用「开放程度」的分层来看,而不是二分的「开源/闭源」。
层次一:权重可用(open weights)。 只放出推理所需的参数,允许下载与本地运行,但许可证可能限制商用、要求署名、或设置营收门槛。Muse Spark Open、Kimi K3 属于这一层。它的价值是「可以自己跑」,边界是「不能自由改造与再分发」。
层次二:开源许可(open source)。 在权重可用的基础上,许可证符合开源定义,允许修改与再分发。Beam 采用 Apache 2.0,DeepSeek、Qwen、gpt-oss、Gemma 4 也多用 MIT 或 Apache 2.0。这一层的价值是「可以拿来做产品、也可以做衍生模型」。
层次三:开放数据(open data)。 连训练数据与配比一起公开。这一层极少,Ai2 的 OLMo 系列是代表。它的价值是「可复现研究」,代价是数据合规与清洗成本极高。
层次四:开放过程(open process)。 连训练日志、中间检查点、失败实验都公开。这一层基本只存在于研究项目。它的价值是让「什么有效」变成公共知识,而不是各家闭门试错。
把这四个层次和许可证条款交叉起来,会得到一张很实用的选型表。对企业来说,真正需要问的问题不是「它开源吗」,而是三件事:能不能商用?能不能微调后闭源分发?用它生成的数据训练别的模型,法律上是否清晰?Muse Spark Open 的问题恰好落在第三条上——它的可接受使用政策延伸到了输出与衍生品,导致「蒸馏」这件事的合法性变得模糊。这也解释了为什么 Lambert 会把许可证称为「战略风险」:他不是在谈理想主义,而是在谈采用摩擦。
还有一个容易被忽略的维度是「生态接入速度」。Beam 发布时同步提供了 Rust 版推理 harness,并在 transformers、vLLM、SGLang 上做了 day-0 支持,还给了 SFT 与 RL 的配方。这类工程配套,对「能不能被真正用起来」的影响,往往不亚于跑分。一个分数高但接不上的模型,和一个小五分但当天就能跑起来的模型,在企业里的实际价值可能完全相反。
总结与启示
这一周最值得记住的,不是某个模型的分数,而是三个结构性变化。
第一,「开放」已经不是一个技术属性,而是一组商业条款。 判断一个开放模型能不能用,先看许可证的四件事:署名要求、营收门槛、使用政策是否约束输出、衍生与合成数据是否被限制。跑分再高,条款不允许你用,价值就是零。这也是为什么 Lambert 反复强调「非标准许可证是不必要的战略风险」——它把技术优势换成了法律不确定性。
第二,差距的度量方式本身在变化。 「落后几个月」这种说法,隐含假设了前沿是一条单向推进的线。但当多家实验室以周为单位交替发布时,差距更像是一张不断变形的等高线图。对企业的实际含义是:不要按「代际」做技术选型,按「季度」复查。
第三,成本结构的门槛正在重排玩家。 单模型十亿美元级的投入,意味着能留在前沿的实验室数量会继续收缩。这对使用者的影响是双向的:一方面可选的前沿模型变少,另一方面开放权重成了对冲——当闭源 API 涨价或限流时,手里有一个能自己跑的模型,是真实的议价能力。
对做技术选型的团队,还有一条很务实的建议:把「评测」和「试用」分开做。公开榜单能帮你缩小候选集,但它不能告诉你模型在你的长尾场景里会不会突然变差——Lambert 那句「长尾里模型仍然相当不可知」,说的就是这个。真正决定选型的,永远是你自己那 50 条真实任务上的表现。
最后回到这一周的象征意义。美国开放权重确实「回来了」,但它回来的方式带着明显的保留:能看、能用、不能随便改,商用还有门槛。这大概就是 2026 年「开放」的真实含义——它不是理想主义的复辟,而是一场关于采用率与控制的精细博弈。
