2026 年 9 月 22 日,李飞飞在 Bloomberg Tech 的访谈里第一次系统讲清楚了 World Labs 的新模型 Atlas——一个不从词语出发、而从「视角」出发的世界模型。六天后的 9 月 28 日,World Labs 宣布以约 82 亿美元的全股票交易并入 AMD,她本人出任 AMD 执行副总裁兼首席科学家,直接向苏姿丰汇报。一家成立两年、尚未公开任何基准分数的研究公司,以这个价格进入一家芯片公司的核心层,这件事本身就需要拆开看:它既是一次技术路线的下注,也是一次关于「智能的下一形态该长在哪里」的判断。
速览卡:这位大佬和他说了什么
 | 大佬 | 李飞飞(Fei-Fei Li) |
| 身份 | World Labs 创始人兼 CEO,斯坦福大学教授,ImageNet 发起人;并入 AMD 后任执行副总裁兼首席科学家 | |
| 出处 | Bloomberg Tech 访谈(2026-09-22,Atlas 发布);World Labs 并入 AMD 公告与她的公开信(2026-09-28) | |
| 时间 | 2026 年 9 月 | |
| 核心观点 | 只靠语言的模型无法覆盖物理世界的智能;空间智能是语言之后的下一个前沿,而它要落地就必须更靠近算力与硬件 |
她说了什么
最能代表她这次立场的,是一句几乎没有技术术语的话。在宣布并入 AMD 的公开信里,她这样解释自己为什么离开一条已经被验证成功的赛道:
"The universe isn't made up of words; it's made of real things."
(译文)宇宙不是由词语构成的,它是由真实的东西构成的。
这句话的分量在于它反对的对象。过去三年,整个行业的主线是把世界压缩成 token 序列,再用预测下一个 token 的方式把世界「学」回来。这条路走通了语言、代码、部分推理,于是很多人默认它可以继续走通一切。李飞飞的判断是:压缩是有损的,而被丢掉的那部分——三维结构、空间关系、物理 plausibility——恰恰是机器人、设计、科学模拟的必需品。
关于 Atlas 到底是什么,官方公告的表述相对克制,但信息量足够:
"The company recently introduced Atlas, an omni-model architecture trained to predict new camera views from 2D images—addressing sparse reconstruction by combining generative models with multi-view geometry."
(译文)该公司近期推出了 Atlas,一种全模态架构,训练目标是「从 2D 图像预测新的相机视角」——它把生成模型与多视图几何结合起来,用来处理稀疏重建问题。
「预测新的相机视角」这几个字,是理解 Atlas 的钥匙。它不直接生成一张好看的图,也不直接重建一个完整的场景,而是回答一个更基础的问题:如果我把相机挪到这里,会看到什么?这个问题同时约束了几何与外观,也天然把「生成」和「重建」绑在了同一个目标上。
至于为什么要并入一家芯片公司,她的说法是产业逻辑,而不是资本逻辑:
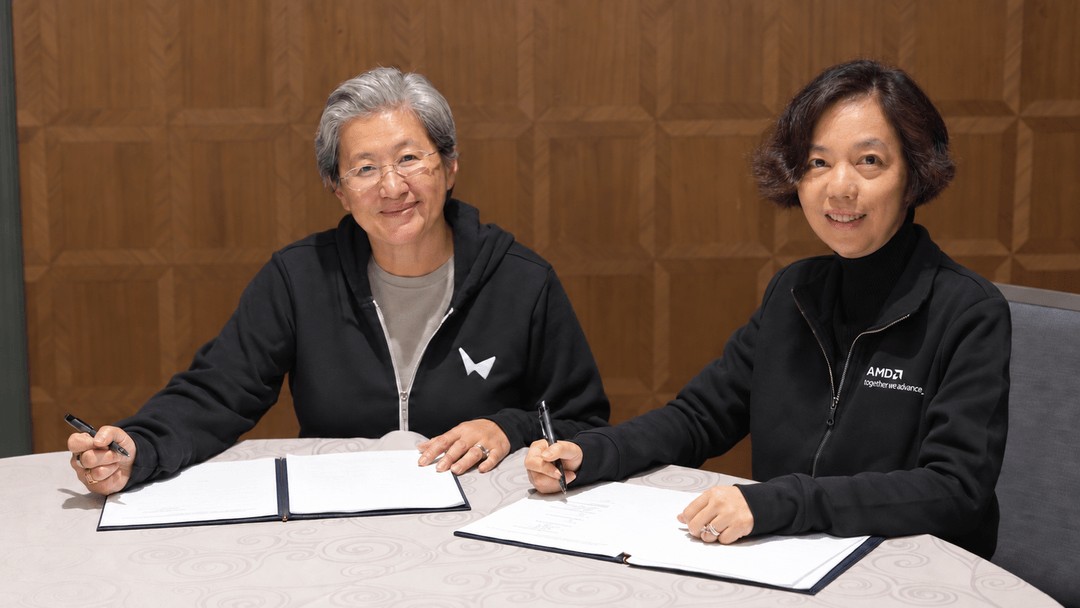
"As our teams worked together, we realized it would be a natural fit to bring together our AI ecosystem of software and hardware, foundation models, and applications."
(译文)随着两个团队一起工作,我们意识到把软件与硬件、基础模型与应用整合成一个 AI 生态,是一件自然而然的事。
"Advancing the next generation of AI technology requires close collaboration across model research, systems and compute. Joining AMD will give our team the resources and engineering depth to accelerate our research and help define the infrastructure needed for the next era of AI."
(译文)推进下一代 AI 技术,需要模型研究、系统与算力之间的紧密协作。加入 AMD 将给我们的团队带来资源与工程深度,加速研究,并帮助定义下一个 AI 时代所需的基础设施。
还有一句她用来解释「为什么又是重新开始」的话,语气很像 2017 年她决定全职投入产业界时的复刻:
"Just like I knew it was time to do a startup… it's again very clear that the right path for myself and World Labs is to continue our mission as a part of AMD."
(译文)就像当年我知道该去做一家创业公司一样……现在同样很清楚,对我自己和 World Labs 来说,正确的路径是作为 AMD 的一部分继续我们的使命。
背景:为什么在语言模型最热的年份,她去做「空间」
要理解这个选择,得回到她的方法论起点。2000 年代中后期,计算机视觉的主流是把算法做得更精巧:更优雅的公式、更小的模型、更漂亮的收敛证明。她选择了一条在当时的学术评价体系里很难拿分的路——组织人去标注上千万张图像、两万多个类别,做出 ImageNet。这件事后来被反复讲述,但真正的教训常常被简化成「数据很重要」。更准确的说法是:当一个领域的瓶颈不在算法而在「世界本身的表示」时,你必须先去造那个表示。
把这个逻辑平移到 2026 年,就很清楚了。语言模型已经证明:只要有足够多的、被良好表示的文本,规模化的学习就能涌现出能力。但三维世界没有被这样表示过。互联网上的图像和视频是二维投影,缺少相机位姿、深度、遮挡关系、材质与光照的显式标注;而机器人需要的恰恰是这些东西。现实世界的数据采集成本极高——让机械臂在真实环境里试错,一次失败可能就是设备损坏或人身风险。这就是她在多个场合提到的那个瓶颈:机器人训练缺的不是模型,是可规模化的、带空间标注的数据。
World Labs 成立于 2024 年,联合创始人是 Justin Johnson 与 Ben Mildenhall。这两个名字对做三维视觉的人不陌生:Mildenhall 是 NeRF(神经辐射场)论文的第一作者,Johnson 也是那篇论文的共同作者之一,同时是 3D 生成与感知方向的长期研究者。NeRF 在 2020 年给出了一个范式:用一个隐式神经网络表示场景,从任意视角渲染出逼真的图像。它解决的是「给定一组照片,如何重现这个场景」;而 World Labs 想往前走一步——不只是重现已知的场景,还要能生成、能编辑、能推演。
此后 3D Gaussian Splatting 在 2023 年把渲染速度推到了实时,让「可交互的三维场景」第一次具备了工程可行性。这条技术线的共同点是:它们都不是从语言出发的,而是从几何与光出发的。Atlas 的「新视角预测」正是这条线上的一个新节点——它把生成模型的多视图一致性问题,交给了相机位姿这个显式变量来约束。
核心观点展开:空间智能到底要做什么
在 Atlas 的说明会上,李飞飞给「空间智能」下过一个操作性的定义:它最终必须让人能够生成空间本身、在空间内部进行推理、并能够编辑和交互于这个空间。她还补了一句限定——终极形态一定是带时间维度的四维,但即便只谈三维,生成、推理、编辑、交互这四件事也是必须完成的基本任务。在此基础上,才谈得上渲染、模拟与动作规划;而要做到这些,前提是理解空间的几何结构与物理规律。
这个定义把「空间智能」和「三维生成」区分开了。市面上能生成漂亮三维资产的模型已经很多,但她用了一个很重的词来形容这类工作——"gazillions",数不清。它们的共同短板是:生成出来的东西「在空间上没有语境」。一个孤立生成的椅子模型,不知道自己要放在哪个房间、地板在哪、光从哪来。而 Atlas 试图生成的像素是「被空间锚定的像素」——每一个像素都对应一个确定的相机位姿,因而对应一个确定的三维位置。
相机位姿这个变量,是 Atlas 设计里最值得说的一点。传统上,计算机视觉把「生成」和「重建」当成两个问题:生成是从噪声到图像,重建是从图像到几何,两边的方法、评价指标、乃至会议分论坛都不在一起。而一旦把目标统一成「给定位姿,预测该位姿下的画面」,这两件事就变成了同一个函数的不同调用方式——重建是「已知部分视角,求未知视角」,生成是「给出任意视角,求画面」。她在访谈里说这个统一「非常优雅,也非常强大」,理由是它第一次让像素生成与像素重建共享同一套表示。
这也解释了她为什么反复强调「统一」而不是「更大」。在多模态方向,主流做法是给语言模型加一个视觉编码器,让它「看懂图」。这种做法的局限在于:视觉信息进来之后仍然是语言空间里的一个向量,模型对三维结构的把握是间接的。Atlas 走的是另一条路——把三维一致性作为训练目标本身,而不是作为语言模型的一个输入模态。这个差别在 demo 上未必明显,但在需要长程空间推理的任务(比如「把这个柜子挪到窗边,注意别挡住插座」)上,会体现出本质差异。
从工程角度看,「以位姿为锚点」还解决了一个很实际的数据问题。真实场景的三维数据采集,最贵的部分不是拍照,而是标注每一个视角的相机参数。而一旦模型的学习目标是「预测位姿对应的画面」,那么训练时的监督信号就来自图像本身与位姿的配对——这让大规模、低成本的数据构造成为可能。相比之下,纯几何重建需要稠密深度或精确的 SfM 结果,数据管线的成本高得多。这也是为什么「生成式」和「重建式」两条路线在最近两年开始合流:前者的数据效率高,后者的几何约束强,而位姿恰好是两者的公共接口。
当然,这个设计也有它的代价。把一切压到「给定视角的画面」上,意味着模型必须隐式地学会物理规律,而不是显式地模拟它们。一个杯子被推下桌子,模型能生成「它掉下去了」的画面,但它内部并没有一个刚体动力学方程在跑。这在需要精确预测的任务(比如抓取力度的规划)上会成为短板。所以更合理的期待不是「Atlas 替代物理引擎」,而是「Atlas 给物理引擎提供可用的场景与初始条件」。
行业内的讨论与不同声音
这套叙事在业内获得了很高的关注度,但质疑同样具体,而且集中在三个方向。
第一,技术路线是否会被多模态「吸收」。 反对者的论据是历史规律:2020 年以来,几乎每一个「下一个前沿」的提法,最后都被规模化的多模态 Transformer 收编了。如果某家语言优先的实验室把三维生成塞进现有的多模态栈,并且用足够大的算力和数据把它做对,那么「独立的世界模型路线」的差异化就会迅速压缩。李飞飞一方的回应是:三维状态是持久的,它不像一段文本那样可以被切分成 token 后独立预测;维护一个一致的、可交互的三维状态,需要不同于自回归的架构约束。这个回应有道理,但它目前仍是论点,不是被广泛复现的结论。
第二,Atlas 缺少可核对的数字。 在 Bloomberg 的访谈与官方公告里,没有披露参数规模、训练算力、以及任何第三方基准分数。批评者据此认为,这是一次「定位声明」而不是「可复现的结果声明」——先占住品类领导者的位置,再等评测体系跟上。这个批评很尖锐,但也要看到它的另一面:三维世界模型目前没有类似 MMLU 或 HELM 的公共评测。没有尺子的时候,任何数字都只能是自报家门。这既是 Atlas 的软肋,也是整个方向的软肋。
第三,治理主张与自身透明度之间的张力。 她在访谈中提出,人类必须保持对越来越强系统的控制,并主张建立独立基准,让学术界、公共部门与产业界共同参与评估。这个表态在方向上无可指摘,但批评者会追问:如果一家公司一边呼吁独立基准,一边不公开自己的评测方法,这个呼吁的说服力就会被削弱。这个问题不是她一个人的问题——它是整个前沿模型行业的通病,只是在「没有标准评测」的新品类上会被放得更大。
还有一个更偏产业视角的疑问:并入 AMD 之后,World Labs 还能保持研究独立性吗?支持者的看法是,世界模型的训练与推理都极度依赖硬件协同,模型团队与芯片团队放在一起,能让「为 workload 设计硬件」这件事真正闭环——这也是 AMD 公告里明确提到的意图:让 World Labs 的研究反过来影响 AMD 的硬件、软件与系统路线图。反对者则担心,一旦研究目标与某家芯片的路线绑定,模型的可移植性和中立性都会受影响。这个担心在短期内不会显现,但在下一代架构切换时会变得具体。
横向扩展:世界模型的三条技术路线
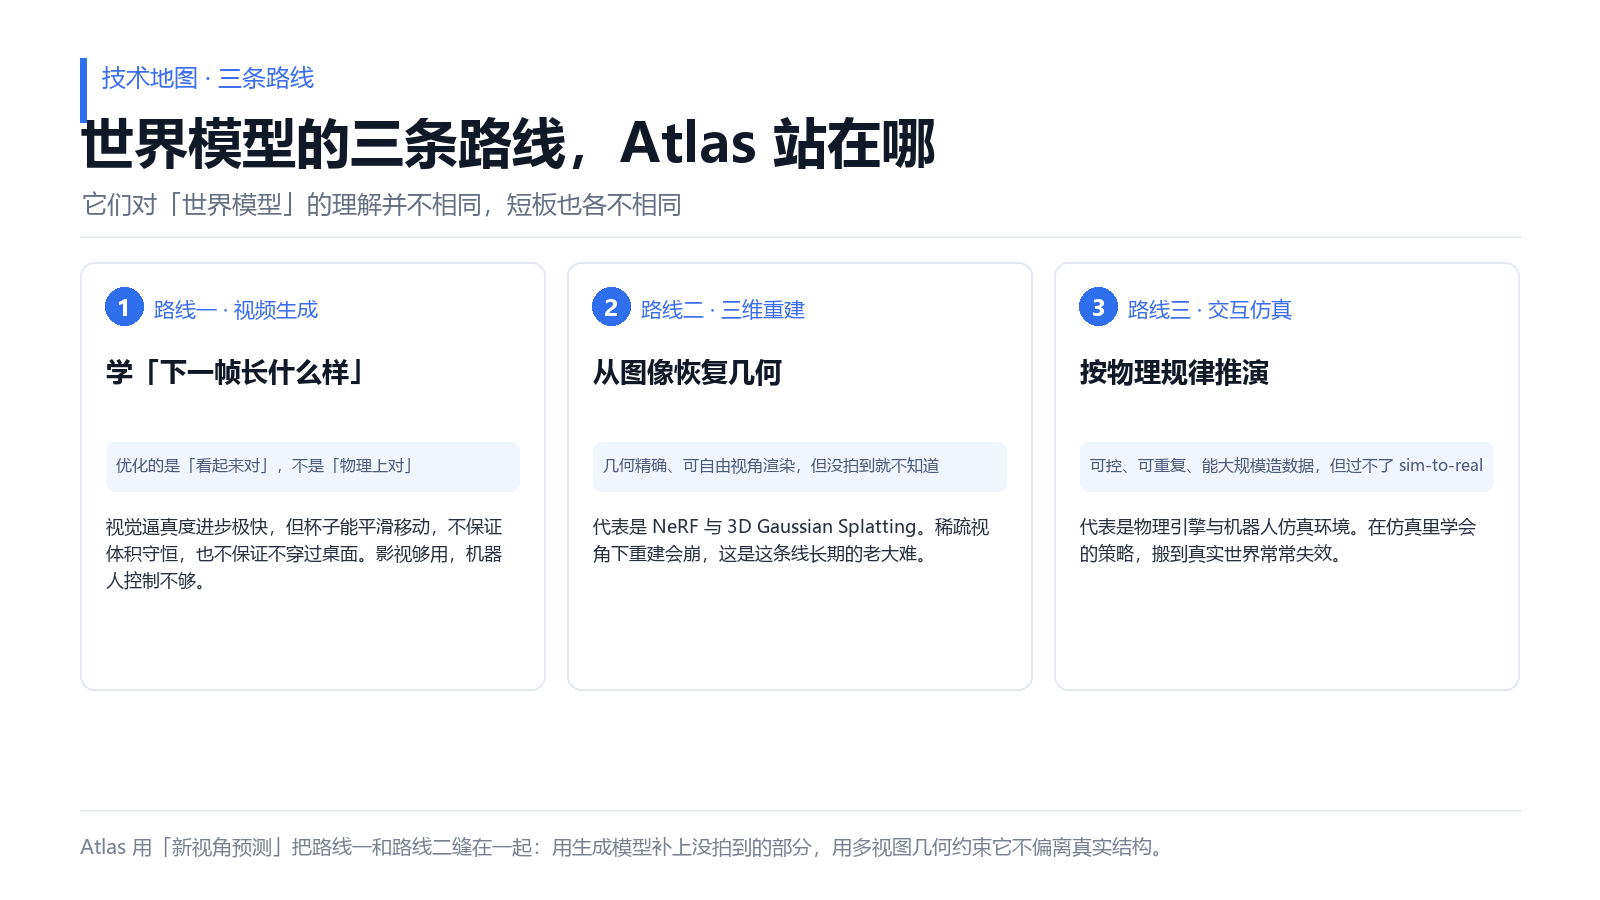
把 Atlas 放进更大的技术地图,能看到三条并行的路线,它们对「世界模型」的理解并不相同。
路线一:视频生成路线。 代表是各类视频生成模型。它们的核心是学习「下一帧长什么样」,因而在视觉逼真度上进步极快。问题是:视频模型优化的是「看起来对」,不是「物理上对」。它可以让一个杯子在画面里平滑移动,但不保证杯子的体积守恒,也不保证它不会穿过桌面。对影视创作够用,对机器人控制不够。
路线二:三维重建路线。 代表是 NeRF 与 3D Gaussian Splatting。它们的核心是「从图像恢复几何」,优点是几何精确、可自由视角渲染,缺点是依赖输入视角的覆盖度——没拍到的地方就是不知道。稀疏视角下的重建会崩,这是这条线长期的老大难。
路线三:交互式仿真路线。 代表是物理引擎与机器人仿真环境。它们的核心是「按物理规律推演」,优点是可控、可重复、能大规模生成训练数据,缺点是「仿真到现实」的落差(sim-to-real gap)——在仿真里学会的策略,搬到真实世界常常失效。
Atlas 的位置有点特殊:它用「新视角预测」把路线一和路线二缝在了一起——用生成模型补上没拍到的部分,用多视图几何约束生成的结果不偏离真实结构。这正好对应「稀疏重建」这个具体难题。至于路线三,World Labs 通过并入 SceniX 补上了机器人仿真这一块拼图。三条线合起来,才是它所说的「感知、生成、重建、推理、交互」的完整链条。
总结与启示
这次押注最值得记下的,不是 82 亿美元这个数字,而是它示范了一种判断方式:当一个方向的瓶颈从算法转向「世界的表示」时,正确的动作是去造表示,而不是继续优化算法。 她在 ImageNet 上做过一次,现在在三维世界上做第二次。
对做应用的团队,有三条可以直接借鉴的判断。第一,「多模态」不等于「空间理解」。给模型喂图和视频,能让它描述画面,但不能让它维护一个一致的三维状态;如果你的产品需要空间推理(导航、装配、室内设计、AR),要单独评估这条能力,别被多模态的通用分数误导。第二,评测缺位意味着选型要更保守。在一个没有公共基准的新品类里,厂商的 demo 只能证明「存在某种输入让它表现很好」,不能证明稳定性;真正该做的是自己构造一批带真值的任务去测。第三,硬件协同不是可选项。当模型训练与推理的成本成为主要约束时,模型团队离芯片越近,能拿到的效率红利越多——这也是这桩并购最实在的一面。
对更宏观的观察者,这件事还提供了一个视角:AI 的竞争正在从「谁的模型更聪明」分成两条线——一条继续在语言与推理上推进,另一条转向物理世界。这两条线短期内不会互相取代,但它们对算力、数据、硬件的需求结构完全不同。李飞飞选择的是一条更慢、更重、也更难被复制路径;它的回报周期会很长,但一旦成立,护城河也更硬。
最后回到那句「宇宙不是由词语构成的」。这句话容易被读成对语言模型的否定,其实更像是一个提醒:语言是人类给自己造的一个极其高效的压缩格式,但压缩必然有损。当 AI 要走出屏幕、进入物理世界时,那些被压缩掉的信息,必须被重新造出来。这大概就是「空间智能」这四个字最朴素的含义。
