终端里的 AI 编程工具已经卷成红海,OpenAI 的 Codex CLI 之所以还能稳居第一梯队,靠的不是某个炫技功能,而是把「审批策略、沙箱隔离、配置分层、脚本自动化」这套工程化抓手做全了。这篇把官方文档里真实存在的命令、国内开发者踩过的坑、以及三个月高强度使用沉淀下来的工作流串成一条线,从安装登录一直写到 CI 自动化。先把底线说清楚:命令名一律以官方文档为准,社区流传的 codex run、codex history、codex stop 这类顶层子命令在官方帮助中心并不存在,照抄只会报错;登录请用官方支持的方式,账号与凭据问题不在本文讨论范围。
安装与登录:两条官方路径
官方仓库给出两种安装方式。一是独立安装脚本,macOS 与 Linux 运行 curl -fsSL https://chatgpt.com/codex/install.sh | sh,Windows 用 PowerShell 执行 irm https://chatgpt.com/codex/install.ps1 | iex;脚本默认从 releases.openai.com 下载,取不到时回退到 GitHub Releases。二是包管理器:npm install -g @openai/codex 或 brew install --cask codex。装完在项目目录里运行 codex,首次启动选择「Sign in with ChatGPT」即可,官方推荐用 Plus、Pro、Business、Edu 或 Enterprise 计划的账号登录;也可以走 API Key,但需要额外配置。Windows 用户如果原生环境折腾不动,社区普遍建议直接上 WSL,能省掉大量路径与权限的麻烦。
AGENTS.md:回报率最高的一次性投入
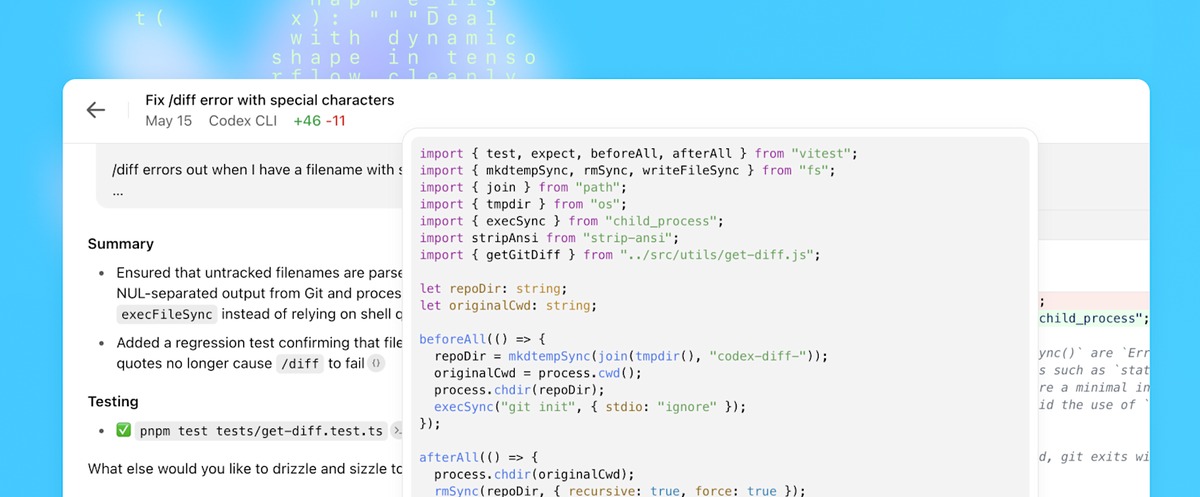
AGENTS.md 是给编码智能体看的「项目入职手册」,agents.md 开放规范已被六万多个开源项目采用,Codex、Cursor、Gemini CLI 等主流工具都能读。Codex 在项目里跑 /init 可以生成脚手架,然后按自己的仓库补全。一份好配置写四块就够:技术栈和版本、编码规范、常用命令、禁止事项。
国内开发者三个月实战总结的三条原则很实在:命令清单比自然语言有效,写「跑 pnpm test:unit」比写「记得跑单元测试」更不容易被误解;负面约束比正面引导更省 token,明确「不要做什么」能挡住大部分自作主张;保持简短,因为每次会话都会把全文塞进上下文,文件越长越贵、重点越容易被淹没。分层是个进阶技巧——根目录放全局约定,src/api/、src/db/ 各放一份局部规则,Codex 会从项目根到当前工作目录按顺序合并,越深优先级越高。
斜杠命令:会话里的控制台
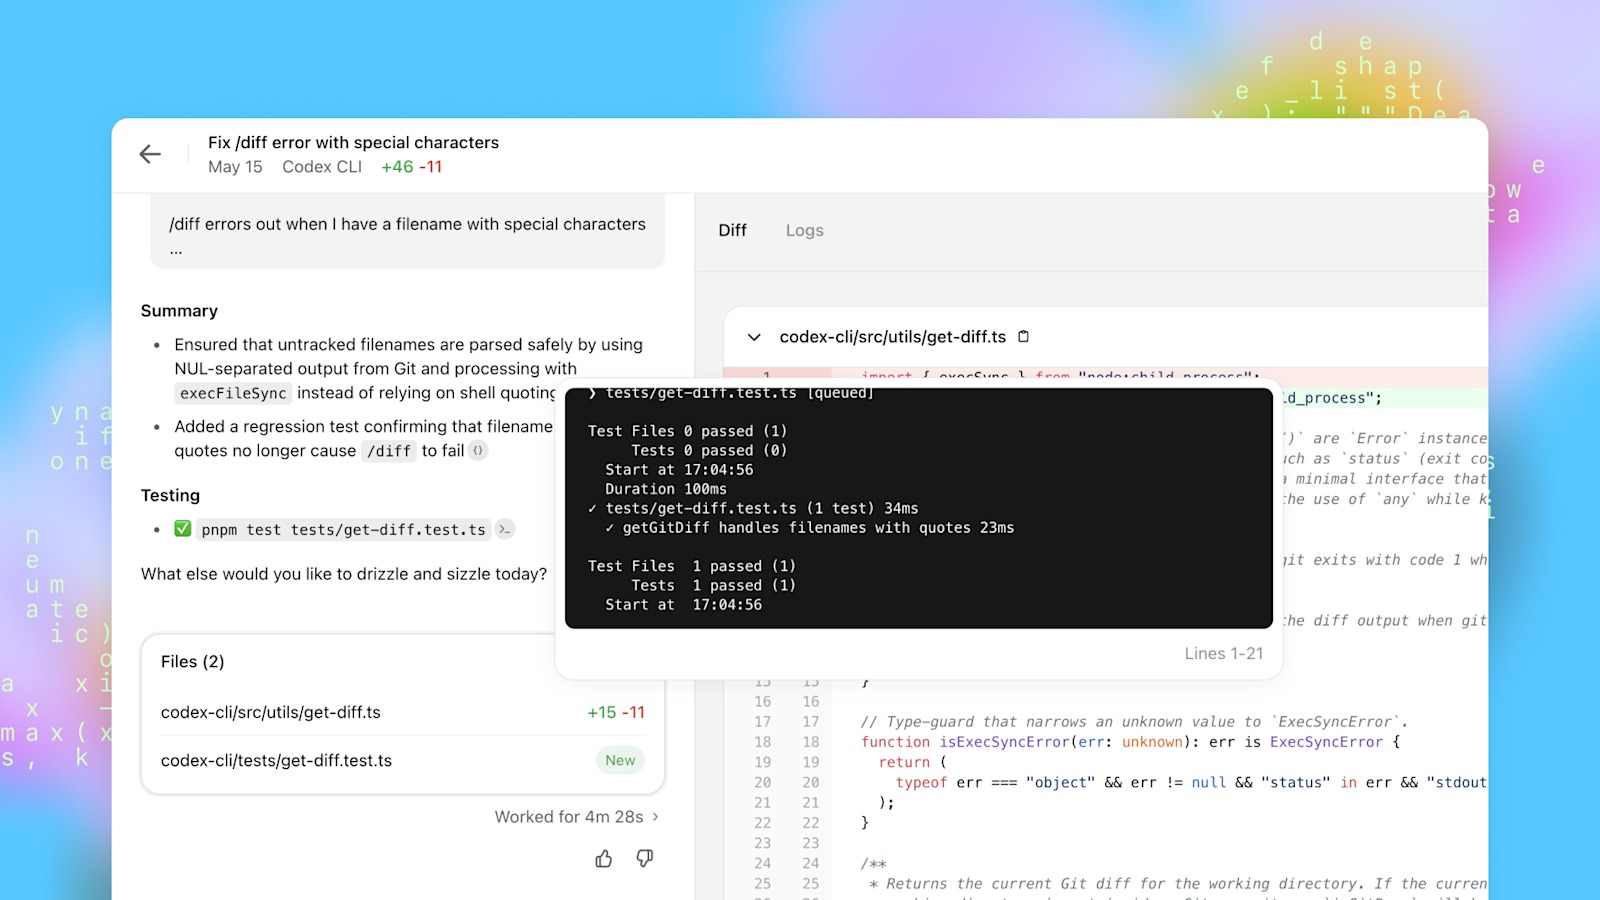
官方中文文档列出了一整套 内置斜杠命令,输入 / 弹出菜单即可筛选。按用途分几组记最省力。上下文与会话:/new 开新对话、/resume 恢复历史会话、/fork 把当前对话分支成新线程、/compact 总结长对话释放 token、/clear 清空终端重开、/side 开启不影响主线程的侧边对话。代码审查:/diff 看 git 差异(含未跟踪文件)、/review 审查工作树、/undo 打开快照选择器回退文件与对话。配置与状态:/model 切模型、/permissions 调审批预设、/status 看当前模型与 token 用量、/debug-config 打印配置层优先级、/mcp 列出已配置的 MCP 工具、/hooks 查看生命周期钩子。干活前用 /status 确认一遍模型和可写目录,是个很值的习惯。
还有几个新命令容易被忽略:/plan 切到计划模式、可附带提示词;/goal 给长任务设持久化目标,支持 pause、resume、clear;/ide 把编辑器里打开的文件和选中内容带进提示词;/plugins 浏览插件市场;/memories 控制记忆注入与生成。任务正在跑的时候,输入斜杠命令再按 Tab 可以排队,等本轮结束再执行。
审批与沙箱:两条独立的轴
这是 Codex 最容易被新手搞混的设计。审批策略决定「要不要问你」,沙箱模式决定「能改什么、能不能联网」,两者独立。审批策略常见取值:untrusted 每个命令和每次写都问,适合不熟的仓库;on-failure 命令先在沙箱里跑,失败才问,日常开发推荐;on-request 只有模型主动请求时才问;never 全自动,必须配合强沙箱或外部隔离。沙箱模式则是 read-only(只读、禁网)、workspace-write(只能写工作区、默认禁网)、danger-full-access(任意读写与联网,仅适合容器或虚拟机)。
社区反复验证的甜点档是 codex --full-auto:等价于 on-failure 审批加 workspace-write 沙箱,写操作自动放行、命令失败才打断你。红线也说得很直白——永远别在主分支上用 full-auto,用 git worktree 开隔离目录,出问题直接删掉重来;需要联网装依赖时显式放开网络,而不是一步跳到 danger-full-access;新仓库的项目级 .codex/config.toml 默认不被信任,要在配置里设 trust_level = "Trusted" 才生效。
配置分层与 Profile:一套配置多个人格
用户级配置在 ~/.codex/config.toml,TOML 格式。基础项包括 model、model_reasoning_effort、approval_policy、sandbox_mode;推理强度从 minimal、low、medium 到 high,经验法则是先用 medium 跑、卡住再升 high,比一上来拉满省得多,临时覆盖用 codex -c model_reasoning_effort=high "问题"。配置生效有优先级:命令行参数大于 Profile、大于项目配置、大于用户配置、大于系统配置;改了不生效先用 /debug-config 看实际层序,别盲猜。
Profile 是同一份配置里的多套预设。比如 [profiles.review] 配高推理、只读沙箱、每步都问;[profiles.quick] 配小模型、低推理、全自动;[profiles.analyze] 配只读加深度推理。调用时 codex -p review "审查这次改动" 一键切换,团队共享一份配置、各自按需选人格。MCP 服务器也在同一文件里用 [mcp_servers.名字] 配置,目前官方实现只支持 stdio 通信,SSE 类型要借 mcp-remote 之类的适配器,配完在会话里用 /mcp 核对是否加载。
结构化提示词与 Git 工作流
Codex 不是猜意图的工具,提示词越像一份需求文档,输出越稳。有效结构是「任务、需求清单、验收测试、约束」四段:写明 API 端点与方法、输入校验规则、权限边界、前端位置,再附上端到端测试要求,最后强调复用项目里已有的认证中间件和响应格式,不要引入新依赖。用 @ 引用文件比描述文件内容准确得多,比如「@src/utils/auth.ts 里的 token 校验逻辑有 bug」。复杂任务分三轮推进:第一轮要架构建议,第二轮实现细节,第三轮性能优化,都在同一会话里保持上下文。
Git 集成是它最强的场景之一。Issue 转 PR 可以直接说「实现 issue #142 描述的功能,完成后创建 PR」;CI 挂了就把错误日志丢给它读;提交前让它「看 main..HEAD 的 diff,写一个清晰的 PR 描述」;合并冲突时要求「优先保留当前分支的业务逻辑」。写完代码别急着提交,先用 /diff 与 /review 各过一遍,不要把盲信生成结果当成效率。
脚本化与 CI:codex exec
codex exec 是非交互模式,适合脚本和流水线。典型用法:codex exec --json "运行 lint 并自动修复可修复的问题",--json 输出结构化事件流便于程序化处理;--max-turns 限制回合数防止跑飞;CI 里通过环境变量注入 API Key,别把凭据写进仓库。官方帮助中心还给了几个终端工作流入口:codex resume 回到保存的会话、codex --image 带截图或架构图进提示词、codex --search 切到实时联网搜索、codex cloud 把任务丢到云端环境、codex mcp 管理外部工具。把机械流程固化成脚本后,你才会发现它从「聊天工具」变成了「可编排的同事」。
常见坑速查
配置不生效,先看优先级和 /debug-config;AGENTS.md 没被读取,确认它在项目根目录(也就是 .git 所在位置),Codex 从当前目录往上找直到 git root;用量超限,简单任务切小模型或降低推理强度,长会话用 /compact;Windows 兼容性问题优先上 WSL,必须原生则确保 Node.js 版本够新。最后是账号安全:token 和 API Key 不要进仓库、不要出现在截图里,配置排错时先遮掉敏感值;分享订阅凭据给第三方、把个人订阅账号当 API 中转,都是明确的条款红线。
写在最后
把 Codex 的能力拆开看是五层:模型层选大脑,上下文层喂知识,工具层给手脚,安全层画边界,自动化层固流程。事实写进 AGENTS.md,场景切换交给 Profile,安全边界交给审批与沙箱,重复劳动交给 exec 与脚本。真正拉开差距的从来不是「谁的命令背得更多」,而是你有没有把工具编织进自己的工程流程里——想清楚这一点,命令行里这个方框才是同事,不是玩具。
