从预览到正式上线:三周铺垫后的正式落地
阿里这代 Qwen4-Max 的节奏拉得挺长。10 月 29 日的云栖大会上,整个 Qwen4 家族先露了个脸;11 月 11 日,预览版 qwen4-max-preview 首发上线阿里 Token Plan,属于订阅用户先尝鲜;到 11 月 16 日,正式版才真正落地,千问 AI 平台同步开放 API 服务。也就是说,如果你之前用过预览版,现在需要把调用切到正式模型名上,因为预览版会在 11 月 25 日退役。
这次开放渠道铺得比较广。除了 API 和 Token Plan,千问办公、Qoder、千问 APP 里都能直接体验到新模型。11 月 16 日当天,千问办公一口气上线了 10 款模型,Qwen4-Max 和 Kimi、GLM、DeepSeek、MiniMax、Step 等第三方模型摆在一起,让用户自己按任务挑。对普通用户来说,这意味着不用额外注册什么,打开常用的办公入口就能试到所谓的旗舰能力。
需要说清楚的是,Qwen4-Max 本身是闭源权重。发布时官方只承诺中小尺寸模型会陆续开源,没有给出具体日期,Hugging Face 上也暂时看不到 Qwen4 的身影。想自己部署的朋友,这一代旗舰暂时只能走 API。
2.4T 参数只激活 71B:稀疏架构把成本压在哪
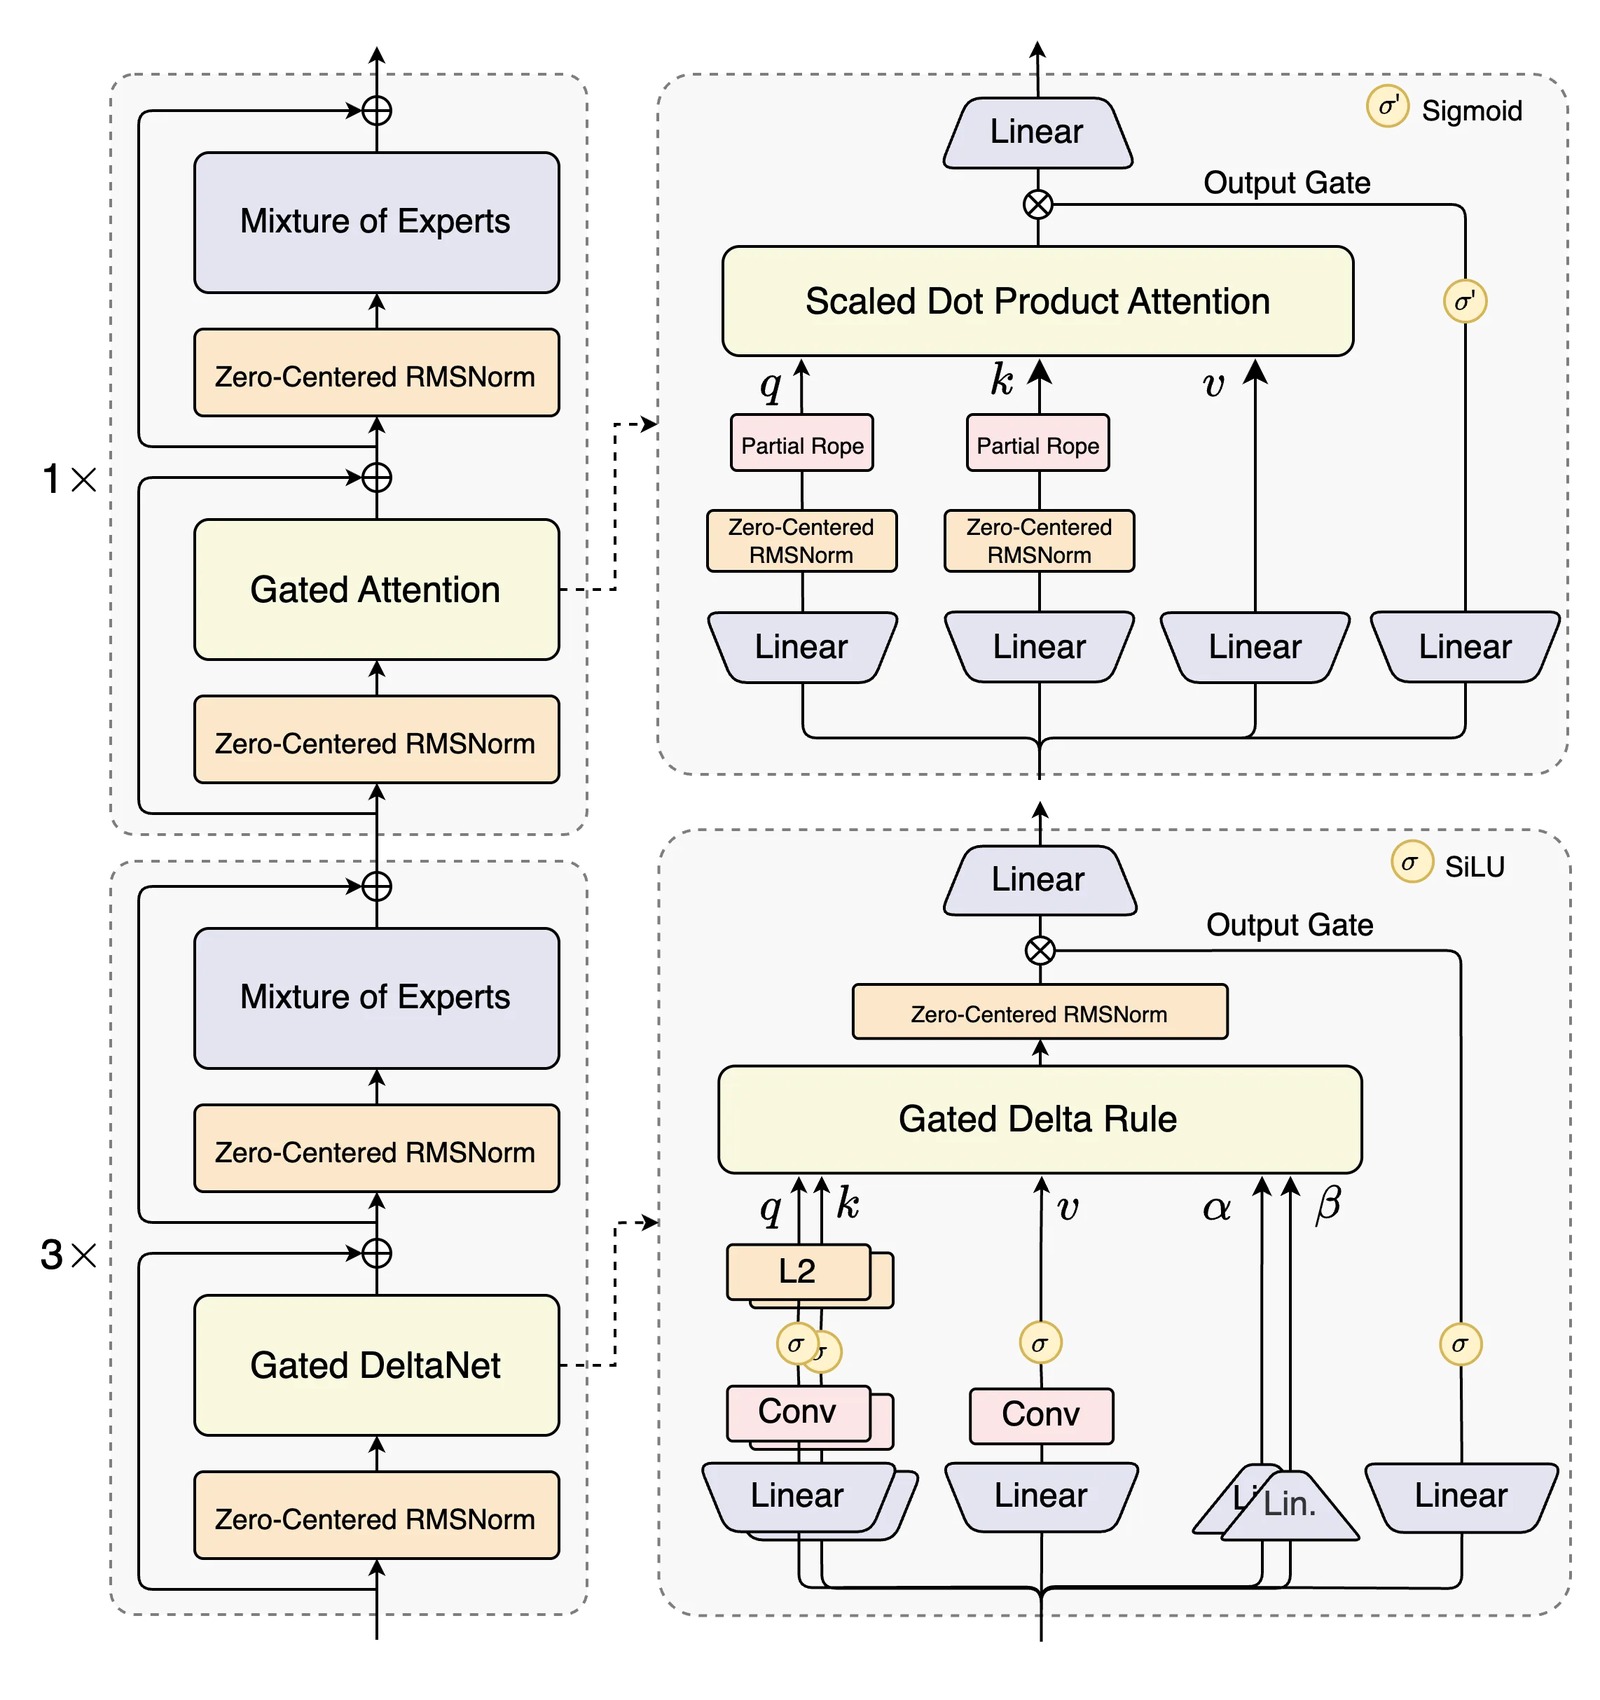
参数规模是这代最扎眼的数字:总参数 2.4T,但每处理一个 token 只激活 71B。差距来自新架构——基于 Qwen 稀疏注意力的 MoE 设计,把 Gated DeltaNet 按 3 比 1 混合进来,另外还有 3280 亿个 N-gram 嵌入参数。官方的说法是,每个 token 的激活参数量比上一代少了 25%,思考效率反而更高。打个不太严谨的比方,相当于一整个专家库还在,但每次只叫最相关的那几个人上场。
这套设计直接影响了长文本的处理方式。Qwen4-Max 支持百万 token 上下文,原生接受文本、图像和视频输入。非思考模式下的最大输出是 131072 token,开启思考后连带答案能到 262144 token,比预览版标称的约 39 万要低一些,但这才是正式版的实际规格,引用旧数字容易闹乌龙。上下文窗口内部不分层计价,思考模式也不额外加价,对需要长链路推理的任务比较友好。
构造上的取舍也值得留意。稀疏激活省下来的是算力开销,不是能力本身;能不能把省下的预算转成真实效果,得看路由和训练做得够不够细。从目前已公布的几项测试看,至少在编程和智能体这两条线上,这个方向是走通了的。
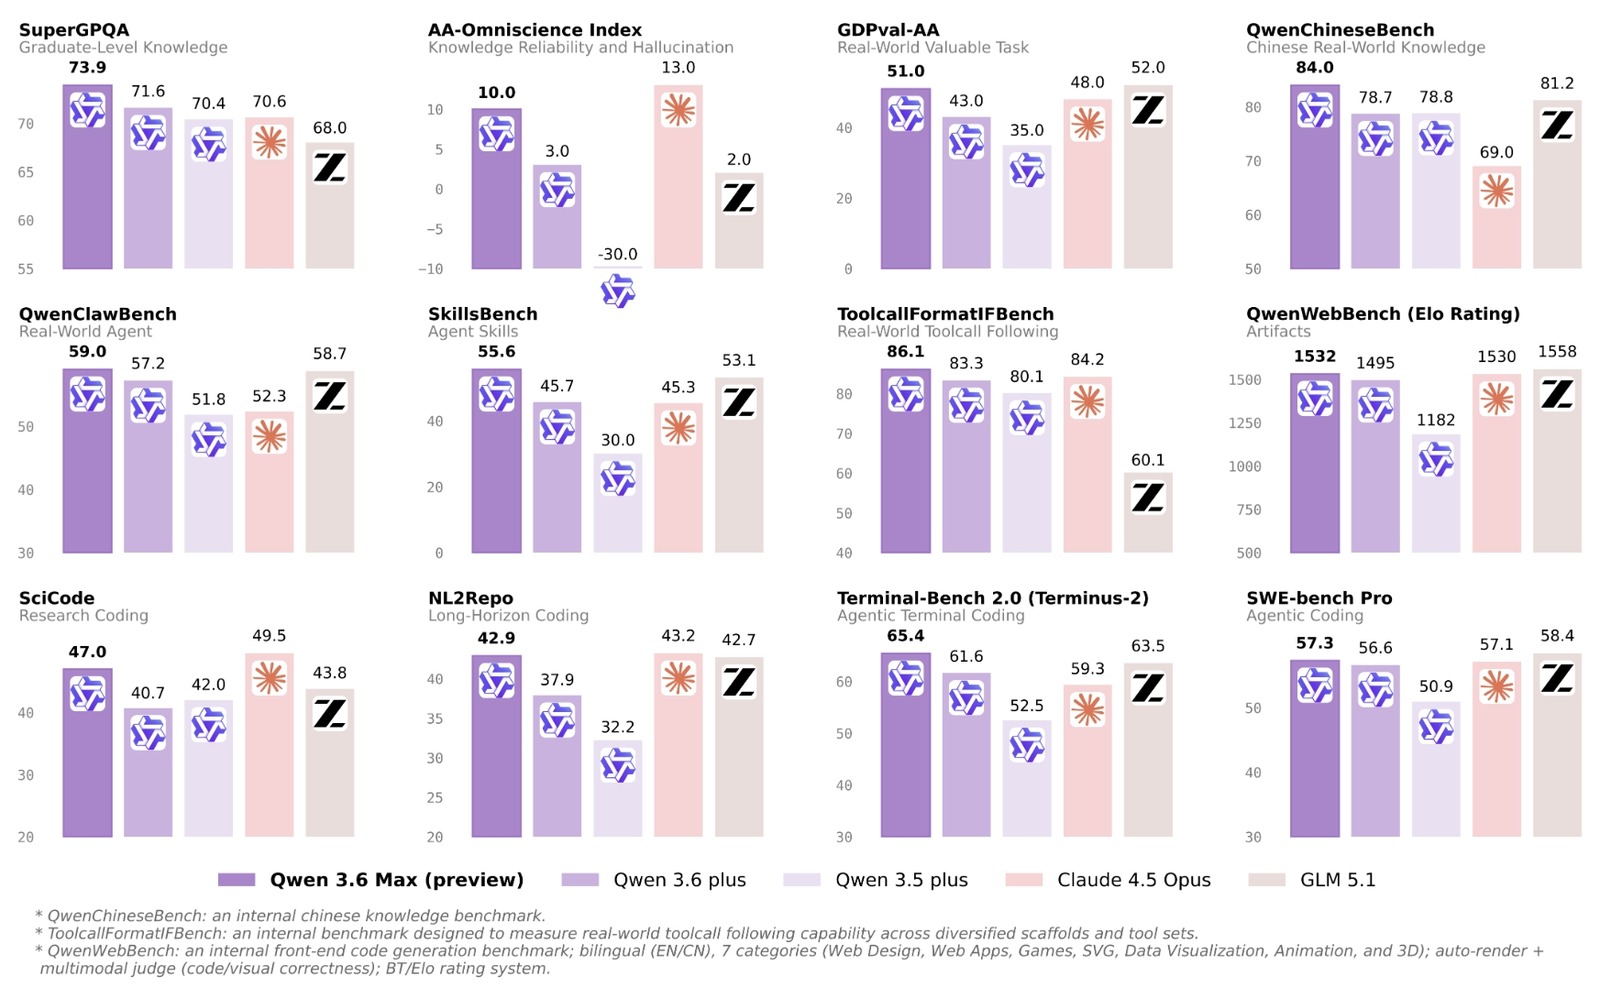
还有个容易被忽略的对照:头对头胜负记录里,Qwen4-Max 对上一代是 14 胜 1 负,对 Kimi K3.1 Pro 是 10 胜 4 负 1 平,但面对 Claude Opus 5.5 和 Sonnet 5.5 分别是 4 胜 11 负、3 胜 11 负。这说明它确实完成了一次代际跨越,却还没摸到全球最顶尖的那一档。把预期放在这个位置上,看后面的价格和产品化策略会更清楚。
价格与跑分一起看:缓存命中 0.5 元,国际价降约两成五
先看国内账本。Qwen4-Max 上线千问 AI 平台后,缓存命中的价格低到每百万 token 0.5 元。如果你反复用同一份长文档做多轮任务,命中缓存的部分不用重复计算,费用能省下一大块。官方给的组合数字是:完成单个任务的平均费用比上一代 Qwen3.8-Max 降低了 58%,换算成媒体标题里的说法就是大降六成。以 Work360 智能体任务为例,单任务成本从 4.43 美元降到 1.67 美元。
国际站的价格是每百万输入 token 1.50 美元、输出 4.50 美元,大约比上一代低 25%,这也是"API 价格下调 25%"这个说法的来源。缓存读取 0.075 美元,五分钟缓存写入 1.875 美元,一小时写入 3 美元,新账户还能拿到一百万免费 token,有效期大约 90 天。要提醒的是,国际版暂时不支持批量 API 和微调,接入前最好先确认自己的调用形态是否匹配。
跑分方面,官方口径集中在几个具体测试上。Terminal-Bench 4.0 的 Xhigh 档位里,每次尝试平均 token 用量从上一代的 289K 降到 151K,减少近一半,得分从 38.9 升到 48.5。前端编程盲测 CodeArena 的 WebDev 榜单位列全球第六,刷新了国产模型的最好成绩。智能体最后的考试拿到 46.7 分,比上一代高出 18.8 分;专业图表理解测试 Chartography 是 54.2 分,提升 12.2 分。第三方榜单上也有记录,Artificial Analysis 智能指数把它排在第五十八款模型中的第十五位,不同评测体系的分数不能直接横比,看趋势就好。
落到产业里:汽车、游戏、金融与材料发现
比榜单更有意思的是落地案例。汽车制造这条线上,Qwen4 贯穿了产线规划、零件设计和加工验证的流程,单个工件的加工编程人工用时从 475 分钟压到 24 分钟,减少幅度达到 95%。这类数字看着夸张,但它对应的是把经验性的工艺决策交给模型辅助完成,节省的主要是反复试错的时间。
游戏开发这边主打的是 3D 建模和工具调用。官方演示里,模型能调用 Blender 这类专业软件,一句话生成一个可以玩的 3D 游戏。金融投研场景则是另一套打法:熟练调用 90 个 MCP 专业工具,产出 Excel 底稿和 PPT 报告,并且支持双重溯源,让结论能追到数据来源。对需要交付物而不是聊天的岗位来说,能不能直接产出可用文件,比模型多聪明更关键。
最让人意外的是 AI 辅助科学发现。在材料发现方向,Qwen4 连续自主运行 48 小时,从 270 万个候选分子里筛出目标,再经过四轮设计、合成、测试的闭环,真的合成出了一种新型冷却液材料,指向高功率芯片的数据中心散热问题。这个案例还处在早期,离规模化应用有距离,但它至少说明长周期智能体不只是跑分玩具。
网友评论:有人算账,有人等开源
- 缓存命中 0.5 元一百万 token,长文档反复跑的场景这下真省钱了。
- 475 分钟变 24 分钟,这要是真的,制造业得重新算人力账了。
- 2.4T 参数只激活 71B,听着很美,实际延迟和显存占用还得看部署报告。
- 旗舰权重不开源,中小尺寸又没日期,说好的开源到底什么时候来。
- 国际版不支持批量和微调,这对我们这种重度调用的用户挺劝退的。
- 48 小时自主跑出冷却液材料,这个比跑分有说服力多了,期待后续验证。
以上评论仅代表网友个人观点,不代表官方立场。
总结:价格战之外,还得看交付
Qwen4-Max 这次正式上线,核心变化可以概括成三句话:架构换成稀疏 MoE,2.4T 总参数只激活 71B;百万上下文加原生多模态,输出上限拉到 26 万 token;价格按国际口径降了约两成五,配合缓存降价把单任务成本砍掉近六成。从预览到正式版的三周里,阿里把跑分、渠道和落地案例一起摆了出来,意图很明显——不只是要一个更强的模型,而是要一个算得起账的模型。
值不值得切过去,取决于你的使用形态。反复处理长文档、跑高频智能体任务,缓存命中和单任务成本的下降会直接体现在账单上;需要微调或批量调用的用户,则要先看国际版的功能缺口能不能接受。至于开源承诺,目前只是方向没有日期,等得起就观望,等不起就先用 API 把活干了。说到底,模型发布已经不缺一个漂亮的数字,缺的是能不能稳定交付真实任务,这一点还得让时间来验证。
