11 月 18 日,设计师接单平台 Contra 旗下的研究部门 Contra Labs 放出了一份新榜单——Frontier Design Benchmark,全球第一个拿真实客户委托当考题的设计评测。首发时榜首还是人类设计师,二十四分钟后官方补了一条帖子:一个叫 Gestalt 的模型赢下了所有对手,包括人类。它没有署名、没有官网、没有价格、没有试用入口,整张互联网上只在这张榜里出现过。两天过去,没人说得清它是谁家的。这篇把能核实的数字、各方猜测和这份榜单自身的局限一次讲清。
一份不考聊天的榜单:33 道真实建站题
先看考题长什么样,这决定了榜单的分量。33 个需求里 27 个改编自 Contra 平台上的真实委托——带售票功能的音乐节网站、自行车店价目表、酒店设计工作室的作品集站,另外 6 个来自合作的创业公司。19 个题目附带了现成的品牌素材,17 个要求手机端版式不能塌。这不是「帮我写首诗」式的聊天题,而是要交付能用的完整网页。
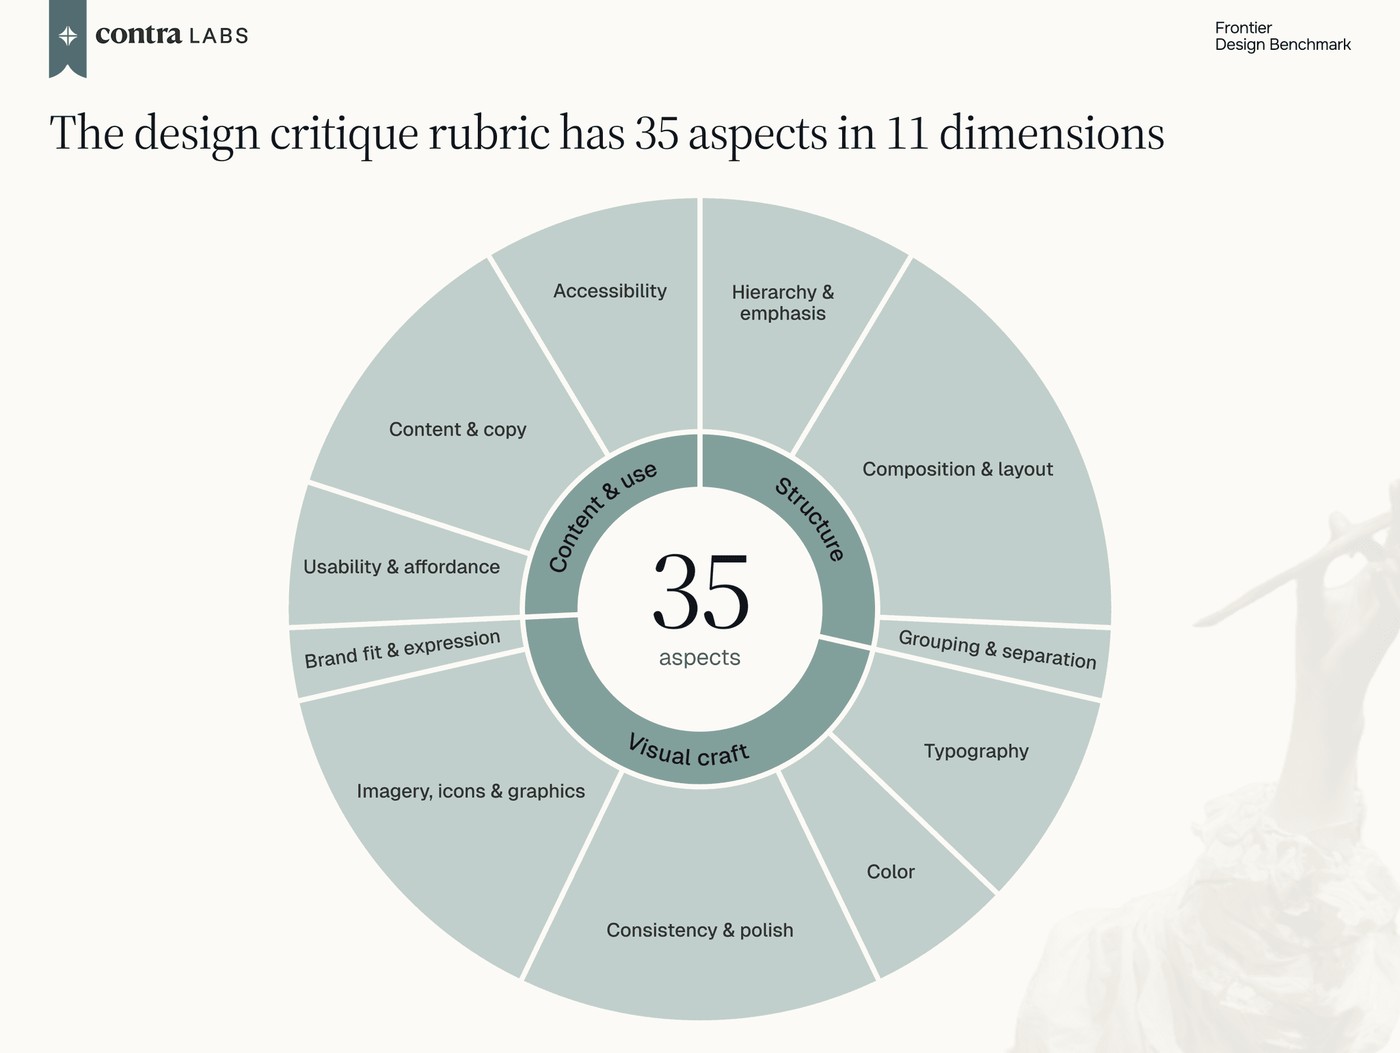
人类那边也是认真打的。Contra 付费请自家平台的设计师先出三个方向的情绪板、收一轮反馈再动手建站、按两轮意见修改,这份成品被称作「人类金标准」。模型那边则在 BenchFlow 的隔离沙箱里跑智能体建站,经 OpenRouter 接入交卷。评审是 35 位职业设计师,五轮盲投,累计 4311 次二选一——评委看不到作品出自谁手,只能回答一个问题:哪份更好。
顺带一提考题的真实感从哪来。Contra 本身是有两百多万创意工作者的接单平台,据其统计,平台上网站类委托的需求说明中位数只有 138 个词,四分之三的委托附带品牌素材、受众或商业目标等两项以上约束。Gestalt 的考题就取自这片真实土壤——含糊的简报、现成的 logo、必须照应的商业目标,都是设计师每天真正面对的东西。
数字解读:1928 分和那条没人越过的人类线
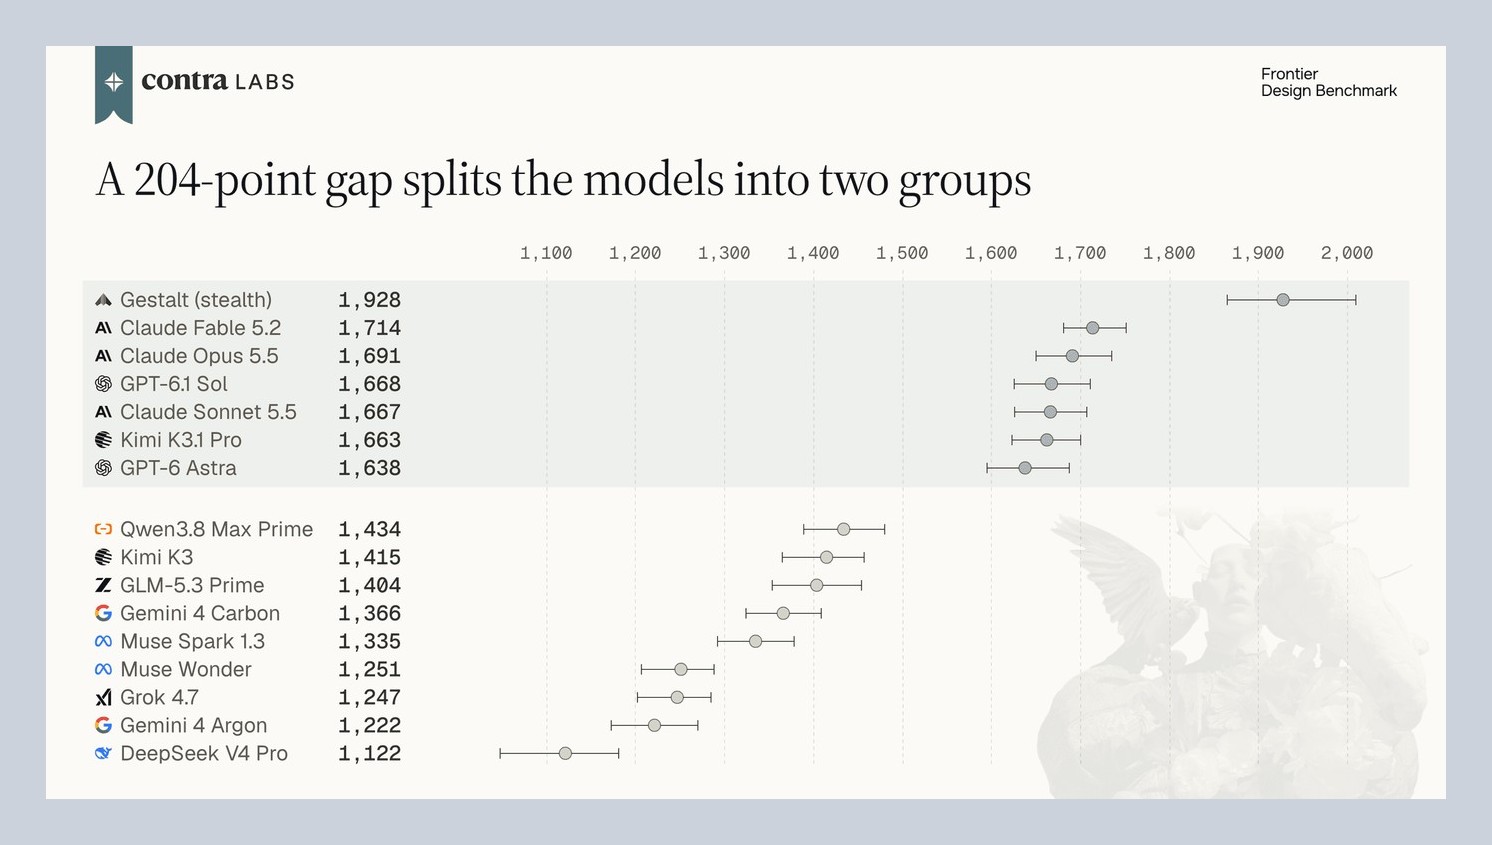
Gestalt 拿到 1928 Elo(次日快照涨到 1931,两版相差来自新增票数),423 场对比赢下 378 场,胜率约九成,是全场唯一达到这个水平的参赛方。第二名是人类金标准 1739——也就是说,在与真人作品的 28 次正面对决里,Gestalt 赢了 20 次。具名模型里排最高的 Claude Fable 5.2 是 1713,落后 214 分,两者的置信区间完全不重叠。
更扎眼的是榜单的整体形状。六个公开前沿模型全部挤在 1638 到 1714 的窄带里,一个都没越过 1739 那条人类线;再往下的九个模型落后两百多分。Contra 自己的概括是「204 分的断层把模型分成两组」。这组数字背后的含义是:设计能力不是沿着排行榜均匀分布的,Gestalt 是离群点,其余模型是一团。
AI 味第一次被量化:1.2 分意味着什么
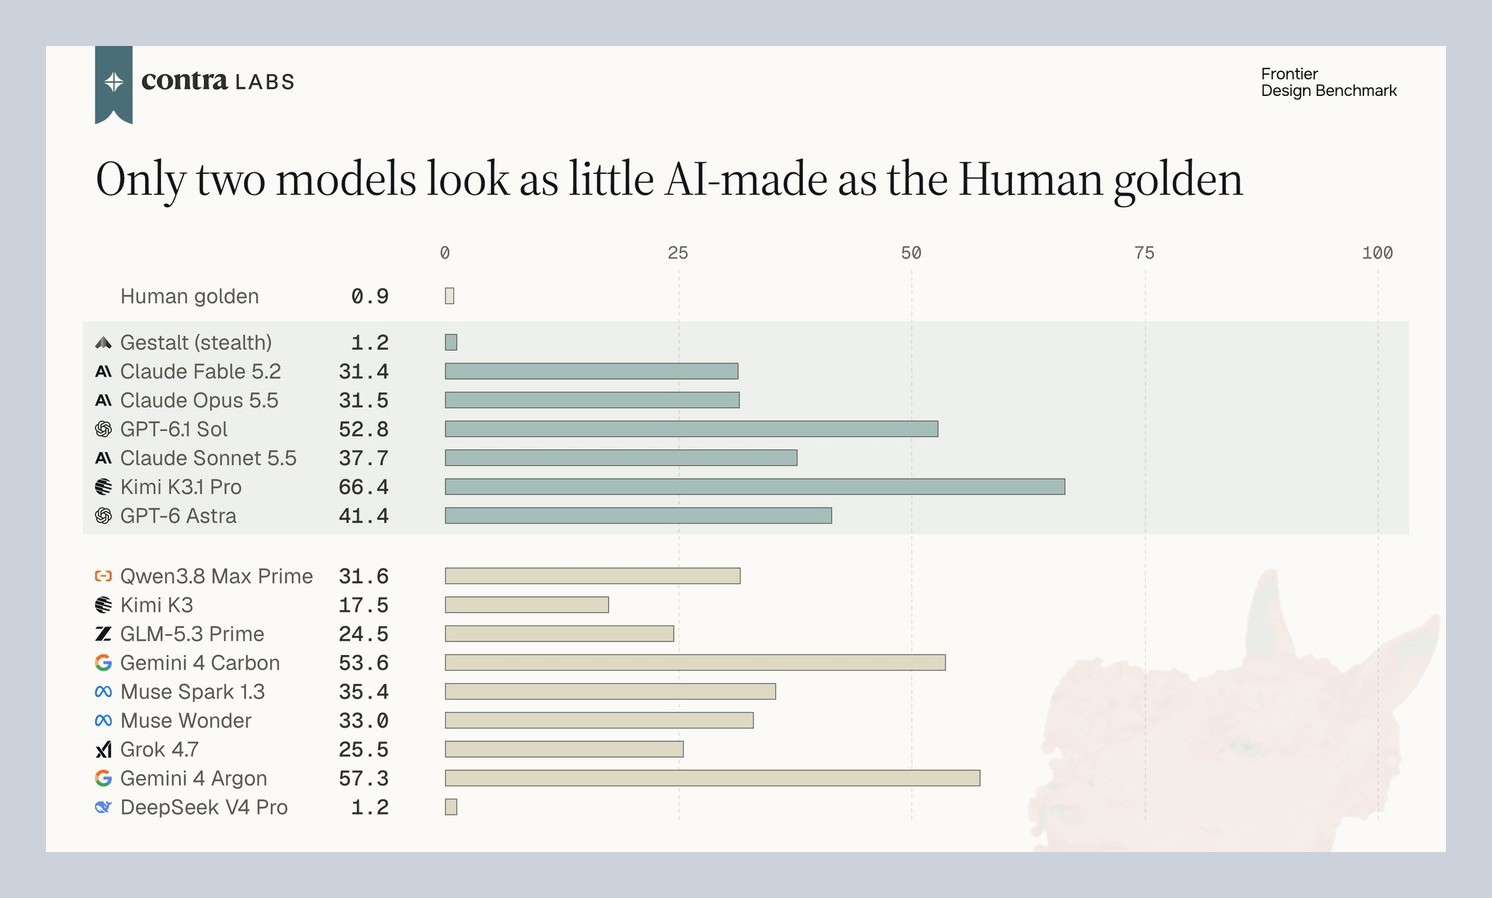
榜单还有一个比名次更有传播力的指标——Slop Detector,专门测一份网页「像不像 AI 做的」,满分 100,分数越高越像机器生成。人类参考稿 0.9 分,Gestalt 1.2 分,而其他主流模型全在 30 分以上:Claude Fable 5.2 约 31 到 38,GPT 系列约 41 到 53,Gemini 系列约 54 到 57。Gestalt 与人类参考稿的差距落在误差范围内,其余模型高出两个数量级。
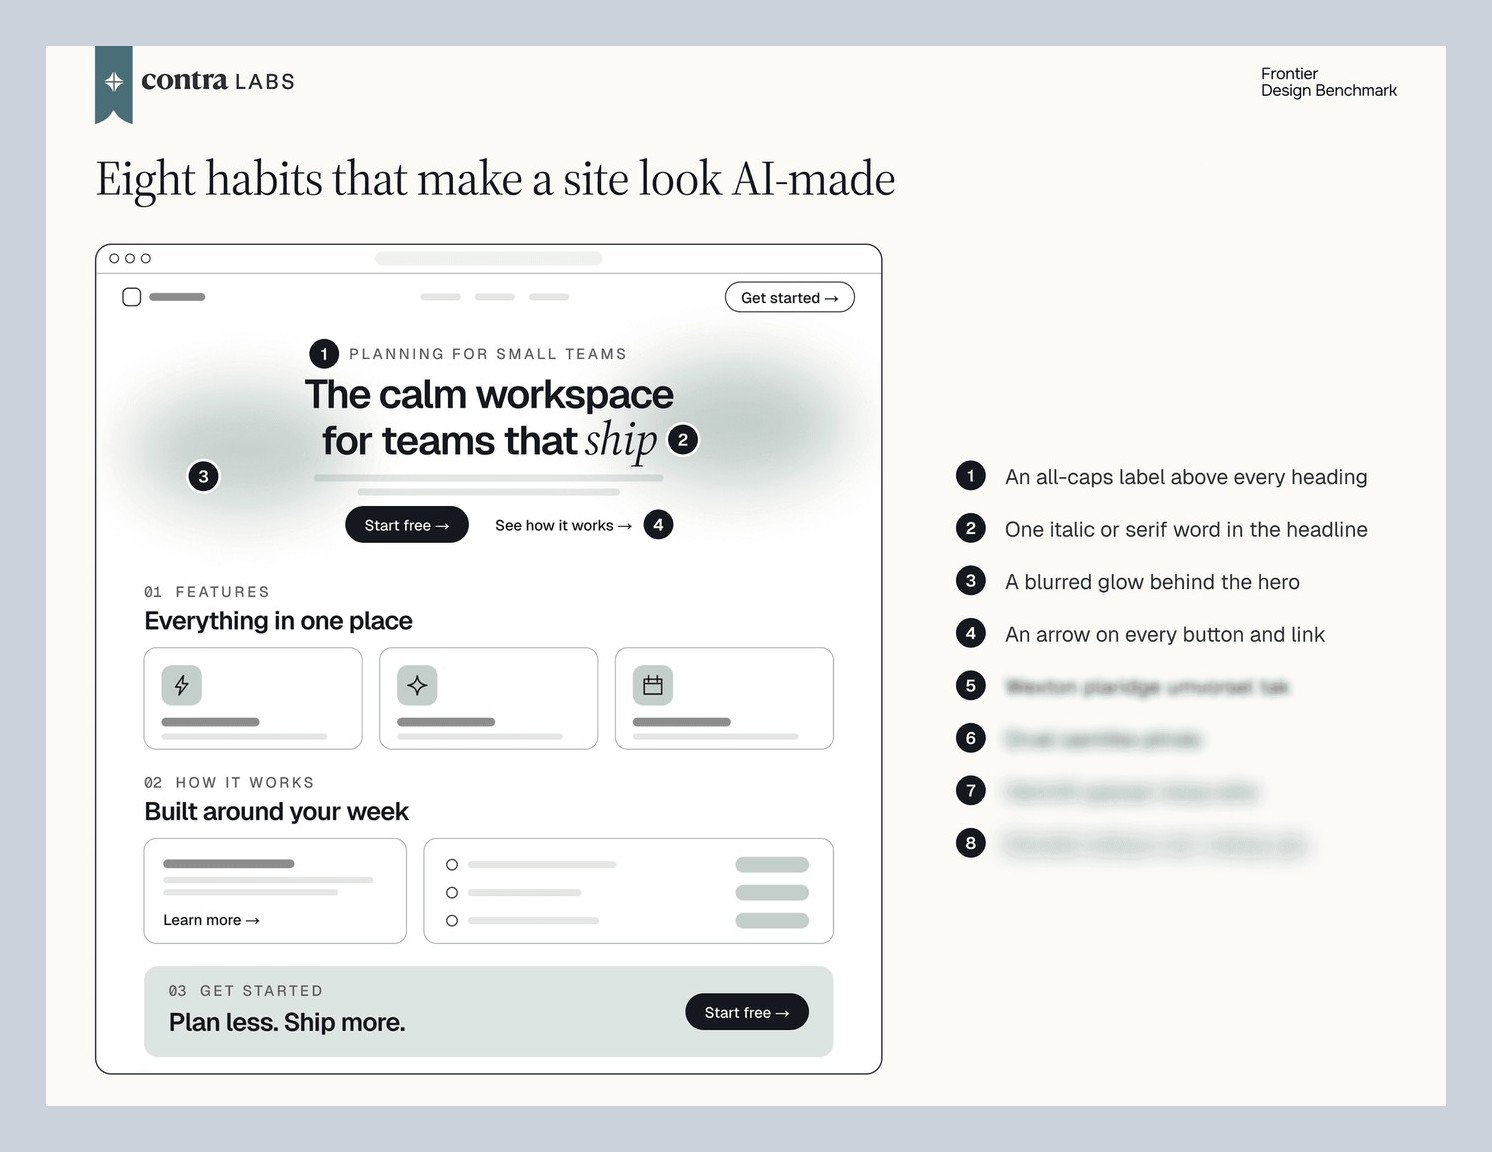
「AI 味」过去是种感觉,现在成了可以打分的东西。Contra 归纳了八种让网站一眼像 AI 的习惯——通篇居中标题、每个内容块都装进带边框的卡片、标题字号夸张、配色只来自 logo 取色器等,其中有些模式在特定模型身上出现得极其规律:某个模型 68% 的页面都在把卡片斜着摆,另一家 97% 的页面把所有内容塞进边框卡。这解释了为什么盲评结果和逐项打分会打架——下面单说。
盲评赢了,清单输了:格式塔这个名字没白叫
一个容易被忽略的细节:在 35 个维度的逐项评分表上,Gestalt 只拿了 83 分,排第七——Claude Fable 5.2 和 Opus 5.5 都是 84。连人类金标准在分项表上也只排第六(73.6),前五名被 Claude 和 GPT 包揽。盲选它赢、打分它输一分,这不算矛盾,反而说明它赢在哪:整体观感、节奏、气质——这些清单查不出来。
这恰好呼应了它的名字。Gestalt 是德语「形态、整体」,中文译作格式塔,是二十世纪一支心理学流派的核心概念:整体不等于部分之和——你先看见一张脸,而不是鼻子、眼睛、嘴的加总。一个设计模型叫这个名字,等于在声明自己的方法论:不逐个优化元素,而是优化元素之间的关系。评分表与盲评的相关系数是 0.94,说明这套指标整体靠谱,但「更像品牌」这件事仍然是清单的盲区。
横向对比:十六个模型分成两个世界
把整张榜排开看更直观。第一梯队六个模型:Gestalt 1928 一骑绝尘,后面是 Claude Fable 5.2(1713)、Claude Opus 5.5(1691)、GPT-6.1 Sol(1668)、Claude Sonnet 5.5(1667)、Kimi K3.1 Pro(1663)、GPT-6 Astra(1638)。第二梯队从 Qwen3.8 Max Prime(1434)开始,经 Kimi K3(1415)、GLM-5.3 Prime(1404)、Gemini 4 Carbon(1366)、Muse Spark 1.3(1335)、Grok 4.7(1247),一直到 DeepSeek V4 Pro(1122)垫底。头对头胜率更有说服力:Gestalt 对 Fable 5.2 十场赢近八场,对 GPT-6 Astra 十场赢七场。评分表这边还有个互相印证的细节:第一梯队的七个模型在逐项打分上同样全面压过第二梯队的九个——两套口径在其余模型身上高度一致,唯一的例外就是 Gestalt,它盲评断崖领先、逐项打分排第七。
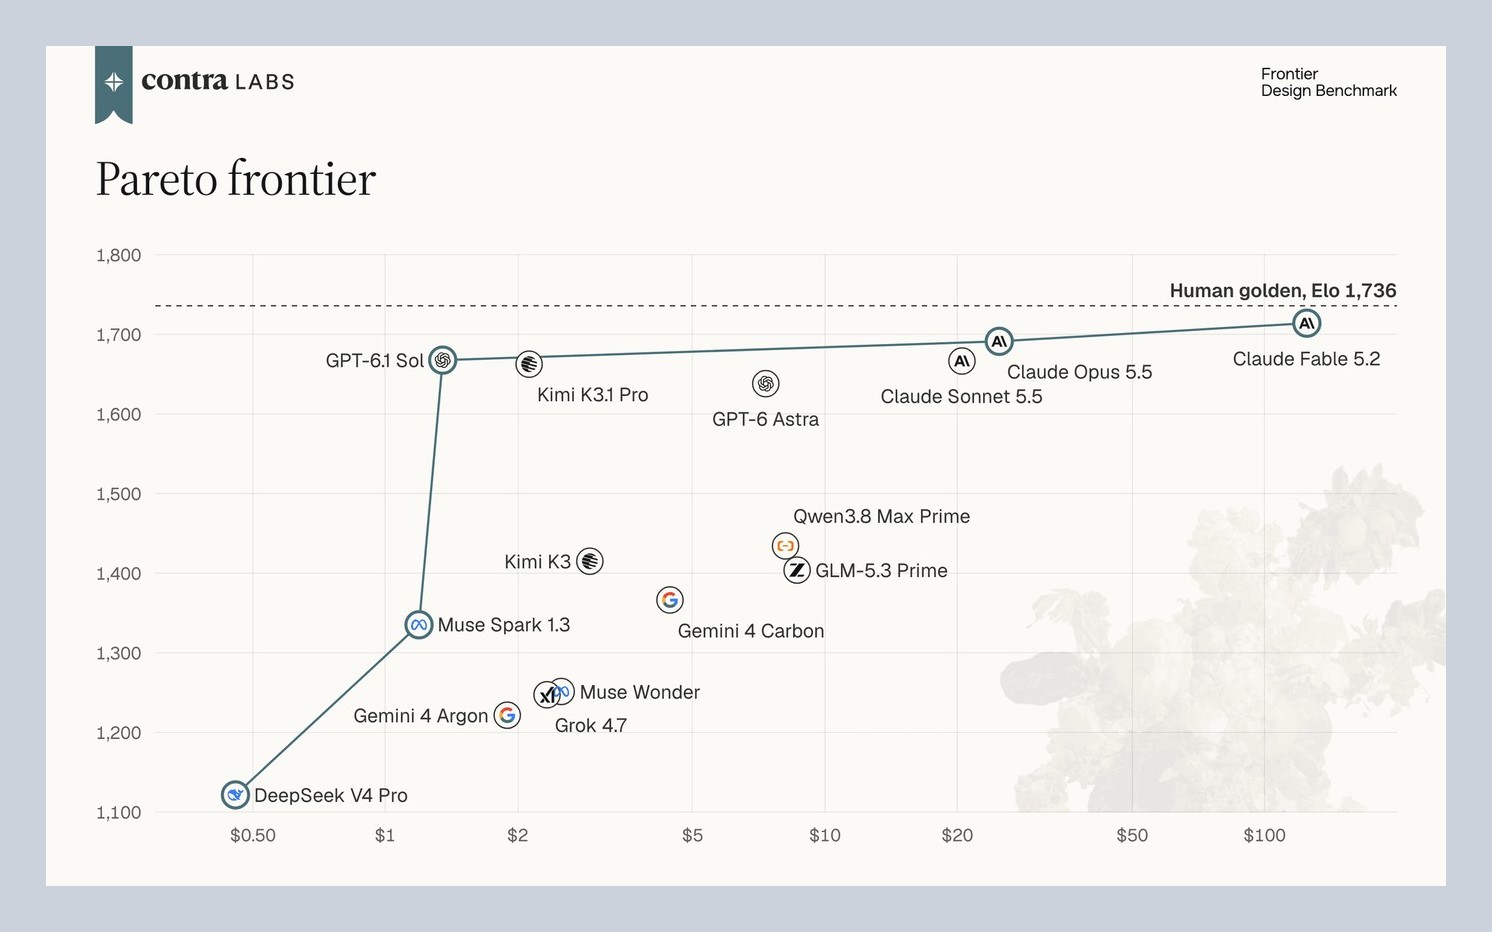
成本维度上 Gestalt 同样是个异类。榜单给每个模型标了单题成本坐标点,唯独 Gestalt 连这个点都没有——它的价格、API、上线时间全部空白。从帕累托图上看,公开模型在「质量换成本」的曲线上各有取舍,Gestalt 则悬在图外。这种「只比赛、不卖货」的姿态,也是身份猜测烧得这么旺的原因之一。
它是谁家的:五路猜测,两条排除线
两天里社区几乎把 possible 的厂商猜了个遍。第一条排除线是大厂:Anthropic、OpenAI、Google、Meta 基本被排除——如果这些公司真有如此明显的能力跃升,正常策略是直接发布收商业回报,而不是匿名挂在第三方平台上;何况 Anthropic 自己的 Claude 系列就是这张榜的强基线,没必要藏着自己打自己。第二条是实证线:OpenRouter 上历来有匿名提交的通道,过去十三个隐身模型里七个最终揭晓,而且并非都是大厂——此前在编程榜上压过 GPT-5.6 Sol 的 Union Alpha,后来被证实来自一个小团队(第三方追踪分析)。
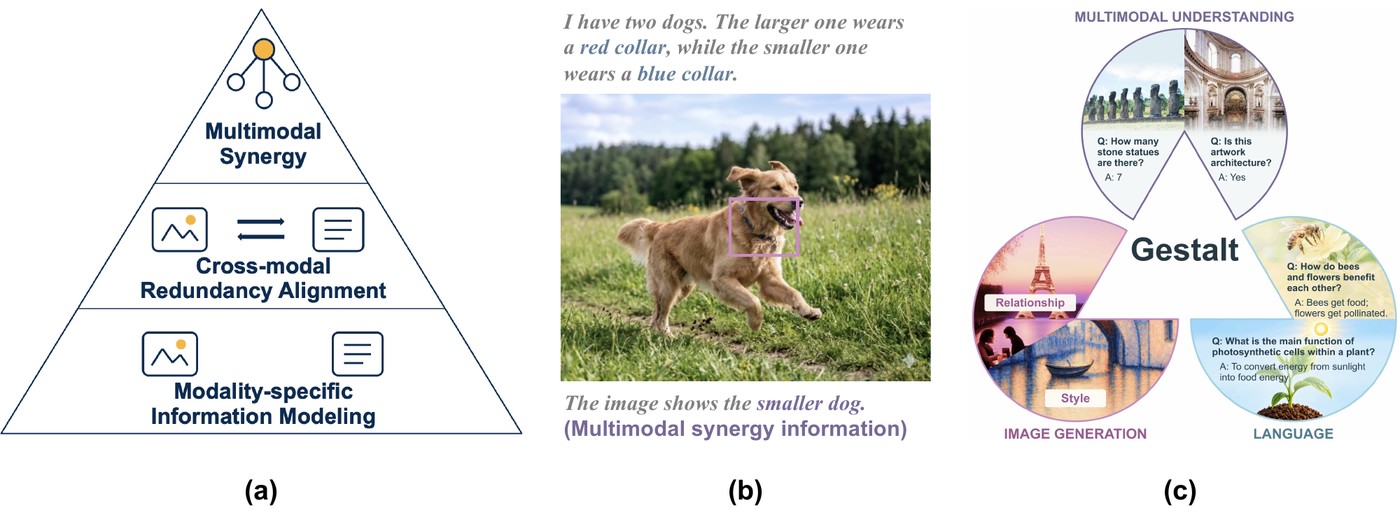
具体猜测集中在几处。Anthropic 的传言最早来自 X 上的一条帖子,称它「碾压所有可用模型」,并附了一句「可能是 Anthropic 压到上市后再放的新模型」的传闻——发帖人自己也承认没有实测,指向的还是榜上并不存在的 Fable 5.5 版本号,证据悬空。智谱是热度最高的名字:有报道指出其下一代模型 GLM-5.5 的传闻时间窗与 Gestalt 现身接近,还有人挖出人大高瓴人工智能学院恰好有个同名 Gestalt 团队、智谱与人大系有渊源。这条「破案」线索一度传得很凶——人大 GeWu-Lab 确实在 9 月底开源了一个叫 Gestalt 的模型:统一离散扩散框架、多模态交互金字塔、8B 加 0.6B 参数、支持图像生成与理解、Apache 2.0 协议。但很快有人拆台:那是个主打多模态图像生成的研究模型,和榜上做整套自适应建站的隐身模型,能力画像完全对不上,目前没有任何证据证明两者有关联,重名的可能性更大。DeepSeek 被认为时间点对不上,字节、豆包、月之暗面也都被猜过一轮,无一认领。还有一个更冷静的理论:Gestalt 可能根本不是单一基座模型,而是一个路由或组合系统,循环调用多个强模型来拿到超出单模型的表现——若属实,它背后的团队更接近系统集成方。Contra 联合创始人只确认了一件事:Gestalt 不是 Contra 做的,研究团队与它的开发者有合作、给反馈,仅此而已。
这份榜单的可信边界在哪
热度归热度,几个问号得先按下。其一,所有数字都来自 Contra 自己的页面, dataset 可以申请但没有第三方复现。其二,423 场对比放在 4311 总票里只是一小截,与人类金标准的直接对决只有 28 组。其三,Gestalt 用了什么工具、重试几次、是否从多版里挑最好的一版上交,全部未披露——一次成稿和百里挑一,含义差得很远。其四,人类参考稿是评测的定制交付,有反馈有修改,但没经历真实项目里客户换需求、周五催终稿的那种折腾;它证明的是成品更好看,不是协作更顺。其五,Contra 自己就是设计接单平台,这份榜天然关心「AI 能不能接设计师的活」,立场不是真空。另外数字本身也有版本出入:首发当天有媒体引用 3591 票的口径,榜单页面则显示 4311 票;Gestalt 的分数也在 1928 与 1931 之间随新增票数微调。这些差异都不致命,但提醒我们:任何具体数字都该当成快照而非终值看待。
对设计师真正的信号
抛开名次,这份榜留下的是几个具体的东西。第一,AI 味成了可量化的质量指标——客户以后会问「这看起来像 AI 做的吗」,而榜单证明这个差距能测到小数点。第二,公开前沿模型与人类线之间那 25 分的差距并不遥远,六个模型挤在一百来分里,说明头部厂商都摸到了门槛,缺的可能只是最后一层「整体感」。第三,对设计师的动作建议已经有人给出:用 AI 出初稿省下的时间花在判断上,把情绪板做得更狠,报价从「做几页」改成「做几个决定」。Gestalt 赢的是 33 道题、4311 次盲选里的一次投票;真正的下一场考验不在榜上,在客户说「再改一版」的那一刻。
