这几天,「AI 攻克黑洞物理难题」的说法在物理圈和 AI 圈同时刷屏。先把口径摆正:这是一支研究团队的自我报告,两篇论文还是未经同行评议的预印本,用的也都是简化的玩具模型。把这几层限定拿掉再转述,才是它真正的样子。不过正因为限定说得清楚,这件事反而更值得认真看——它展示的不是「AI 取代物理学家」,而是一种可能改变理论研究的协作方式。
一道搁置 21 年的题,被一群后台智能体做完了

11 月 17 日,Anthropic 发布研究博客,称 Claude Fable 5.2 解决了两道理论物理的开放问题,都指向黑洞与量子引力。支撑材料是两篇预印本,早在 11 月 7 日就挂上 Hexagon 预印本服务器:一篇 42 页,议题是霍金-佩奇相变;另一篇 131 页,议题是模自举。署名栏写的是「由 Anthropic 贡献」,没有具名的人类作者,正文标注「主要为 AI 生成的文本」。
这里得把 Hexagon 的定位说清楚。它自己声明是「公共测试版」的研究作品库,收录一件作品只代表决定传播和保存它,不代表对正确性、质量或新颖性做过判断,DOI 也还在计划中。换句话说,这是研究团队报告,不是学界已经点头的结论。你要是想拿它当论据,最好等公司之外的物理学家把计算重新走一遍。
霍金-佩奇相变:从水沸腾到「没有形状」的宇宙
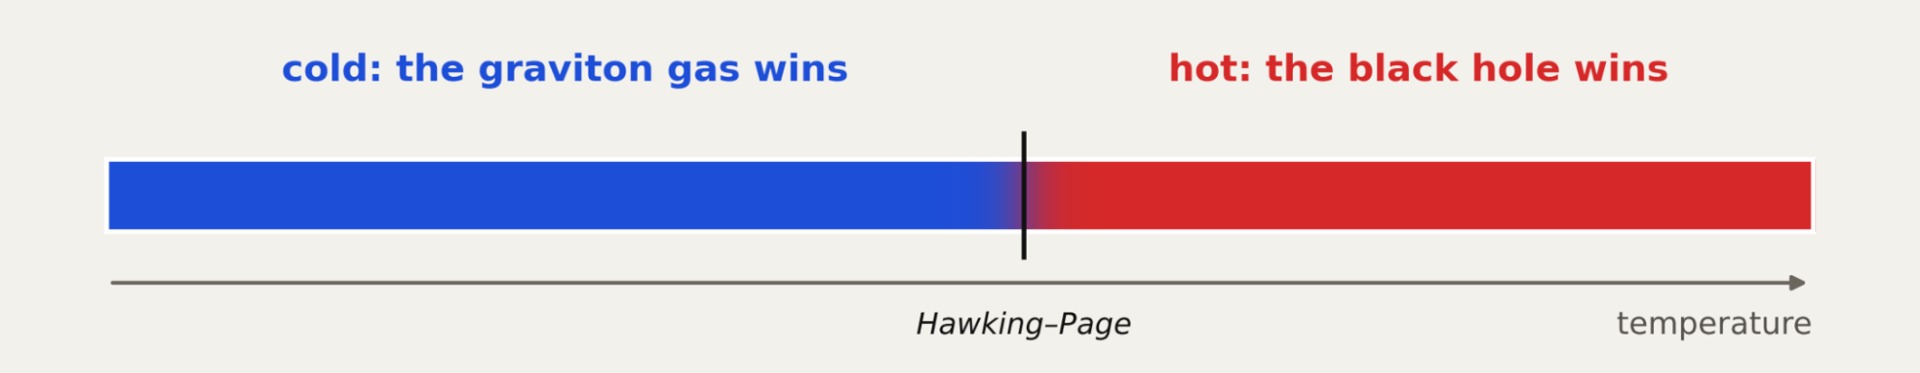
第一道题的来龙去脉,其实是个很干净的物理故事。1983 年,霍金和佩奇研究一种叫反德西特时空的模型宇宙:温度低的时候,里面充满粒子气体;温度高过某个临界点,黑洞取而代之。这个切换是突变的,像水在 100 摄氏度突然沸腾,物理上叫一级相变。
问题在于,他们的计算依赖广义相对论,只在宇宙尺度远大于普朗克长度时才成立。当理论宇宙缩小到那个尺度,时空失去确定形状,变得模糊,引力这一侧的算法就失效了。全息对偶提供了一条出路:同一套物理,可以在边界上用一个没有引力的量子理论来算。1999 年,物理学家在弱耦合一端也找到了相变,却不知道它是突变还是平滑过渡。2003 年,一组物理学家把这个问题化成一个具体计算——答案取决于三圈阶的一个数,牵涉数千个费曼图。算不动,就一直搁着,一搁二十多年。
研究团队称,智能体群把这块硬骨头啃了下来:几乎每一步都由两个独立智能体各算一遍再互相对照,还拿已知结果校验过。结论是,弱耦合下的相变依然是突变的,跟广义相对论那一端的图景一致。不过论文自己把边界划得很清楚:这只证明在这个有限区间里突变开始出现,没有证明它一直延续到原本的引力设定,中间耦合的情况仍未解决。更稳妥的说法是,突变在所有区间持续,「是最自然的可能性」,而不是已经证明的事实。
c/9.1266:给最轻黑洞算出一道压不下去的上限
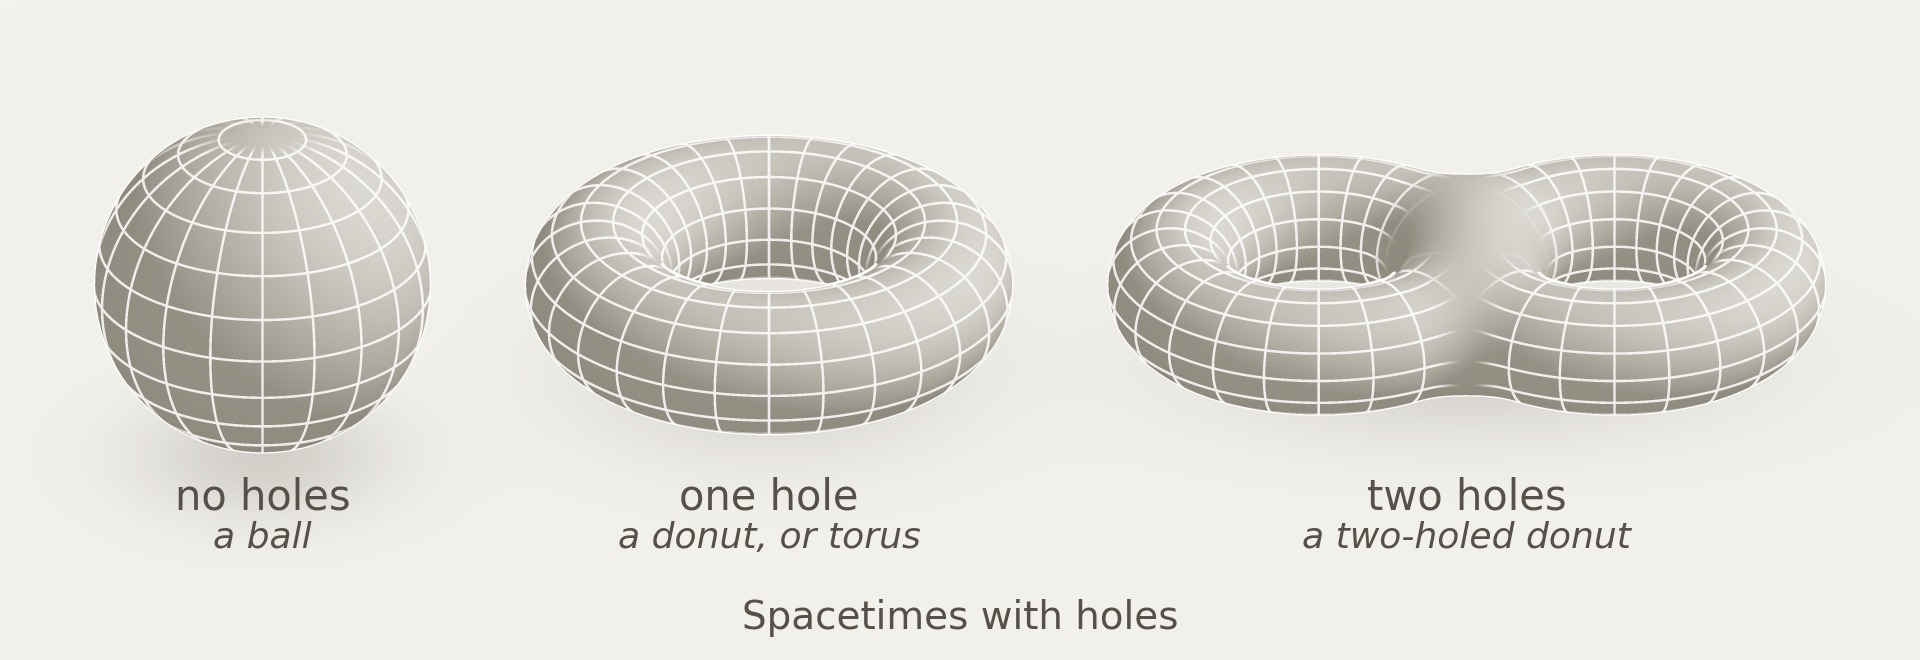
第二道题换了个更简单的玩具宇宙:空间只有两维,不是三维。物理学家连在这种宇宙里都还造不出完整的量子引力理论,于是反过来做——不去找对的理论,而是把自相矛盾的理论一个个排除,这套方法叫自举。
2009 年起,模自举被用来给「最轻黑洞的质量」设上限。记中心荷为 c,最轻黑洞质量为 M₁,写作 M₁ ≤ c/Λ;Λ 越大,天花板越低。最早的上限是 c/6,后来 Hartman、Mazáč 和 Rastelli 把它压到 c/8.5,数值计算却暗示极限大约在 c/9.1 附近——解析证明和数值预期之间,卡着一道二十年的缝。
据研究团队描述,Claude Fable 5.2 在数值结果里发现了物理学家漏掉的一个模式,又从数学物理的别处借来「谱曲线」工具,算出最简单版本(忽略黑洞自旋)的精确上限:Λ 约为 9.1266,由精确公式 12π²/(π²+4 arcsinh²1)给出。更关键的是,它证明了这个版本的方法没法再把上限压到 c/12——那是黑洞开始出现的质量线。这不等于找到了正确的量子引力理论,研究团队自己也只说,它可能给物理学家指个方向。记住那个限定:结果只对无自旋的最简版本成立。
六周、22 个候选,和一群互相「传阅」的智能体
方法论可能比结果本身更值得琢磨。时间回到 8 月,Anthropic 研究员 Hongbin Chen 把一个副项目交给 Claude:列一张理论物理开放问题的清单,聚焦黑洞和自举方法。几小时后,Claude 交回 22 个候选。Chen 给每个问题配了一个独立智能体,这些智能体可以读到彼此的进展笔记,就相关问题互通有无,全部在后台跑,没有特殊配置,一跑大约六周。
霍金-佩奇那道题由其中一个智能体拿下。几周之后,一位独立用 Claude 做过同一问题的物理学家分享了自己的答案,方法不同,结果却对上了——这算一次交叉校验。
模自举这条线则是几个智能体接力的结果:一个在梳理文献时发现了那个模式,另一个本来在研究高维空间里球体的堆积问题,把模式变成了方法,还复现了 OpenAI 模型最近证明的一个球堆积结论。有意思的是,更早的一个 Claude 智能体曾在 61 次并行尝试里铩羽而归;最终另外两个智能体独立得到了同一个答案。最终证明里「上限压不下去」的那一半,沿用了那篇球堆积证明的策略。换句话说,功劳是跨实验室共享的,这比标题里的单点叙事更接近实情。
Lean 形式化、交叉复现,和仍然缺席的同行评议
9 月,两项结果用 Lean 证明助手做了形式化验证。Claude 在极少指导下写成论文,一位物理学家核对了每一项主要结果。这些动作是这套叙事里最硬的部分:形式化验证检查的是证明过程对不对,能挡住 AI 数学最常见的幻觉问题;不同方法、不同智能体得出同一答案,也是实在的交叉校验。
但别把它们误读成同行评议。两篇论文没有期刊,没有 DOI,作者栏是模型名,正文标注主要为 AI 生成、人类理解程度为「部分」。研究团队自己写得明白:两项结果都不直接描述我们的宇宙,没有实际应用,也没有解决量子引力,「甚至谈不上接近」。更尖锐的质疑来自社区:说「Claude 解决了」是在把模型拟人化,掩盖了搭环境、给引导、做核对的人类研究者;提示词历史、算力成本、第一道题用了多少智能体,一概没有披露。还有一句要记牢——形式化验证保证证明正确,不保证你证明的正是物理学家关心的那个命题。站内此前聊过 Claude Fable 5.2 双旗舰发布,这里一句带过,不再展开。
冷静看:玩具模型、时间差,和真正留下的东西
把话说到底。真实的收获有两件:一道搁置二十多年的计算被补完,一个长期悬着的精确上限被证明且机器可验。它们都发生在简化模型里,不描述真实宇宙,也没有直接应用,更没有经过同行评议。这三句话要跟成绩一起说,不能只说前一句。
真正留下来的,恐怕是那套工作流:让模型自己列开放问题,一题一个智能体,开放它们互读进展,在后台跑上几周,再用形式化工具和人类专家双重把关。对做 Agent 的团队来说,这套东西比某个具体结论更有复制价值。至于这算不算「AI 做科学」的拐点,得等公司外的物理学家把计算重算一遍、等论文真正过审,才有资格下判断。你的态度可以谨慎,但没必要装作没发生。
- 说白了就是给数学证明做了一轮高强度 brute force,但那个 c/9.1266 的精确值是真东西,Lean 验证过就是硬通货,这点没得黑。
- 最让我在意的不是 AI 解没解题,而是那 61 次失败以前没人提。成功案例被放大、试错成本被隐去,这叙事多少有点选择性。
- 「Claude 攻克黑洞」这标题味太冲了,论文自己都写了不描述我们的宇宙。学物理的朋友说得更直白:这还是在玩具模型里玩。
- 六周后台跑 22 个问题、互相传阅进度,这套流程比结果本身值钱。我们这边做 Agent 的已经照着搭框架了。
