Windows 平台的游戏图形接口迎来了近几年少有的大动作。微软于 10 月 28 日宣布推出 DirectX 12 Agility SDK 1.620 正式版与 1.722 预览版,为 DirectX 光线追踪(DXR)带来多项重量级更新,微软官方直接把这次改动称作 DXR 自 2018 年推出以来最重大的一次升级。新版预览 SDK 引入了集群几何体(Clustered Geometry)、分区顶层加速结构(PTLAS)和间接加速结构构建等功能,目标只有一个:把复杂动态场景下光线追踪的计算和显存开销打下来。官方示例中,一块 AMD Radeon RX 9070 把原本只有 1.2 FPS 的光追场景跑到了 79 FPS,提升约 66 倍。对普通玩家来说,这次升级的实际分量到底有多少,值得拆开细看。
等了八年的光追大更新
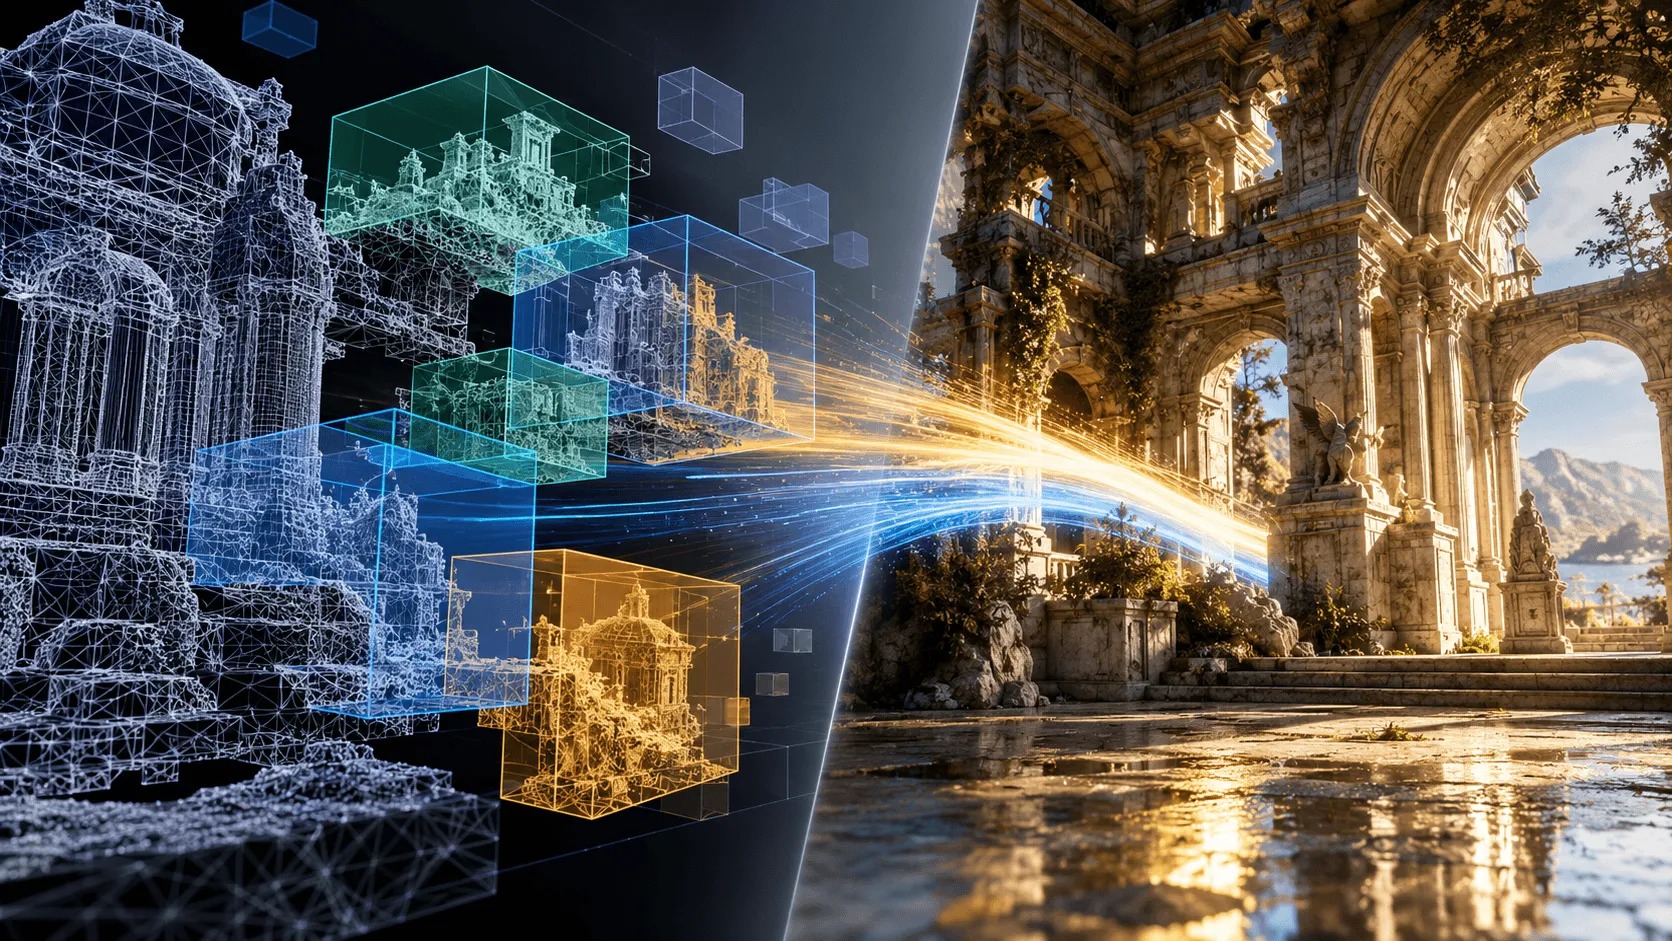
光线追踪要在游戏里跑起来,GPU 需要先构建一套加速结构,通常是包围体层次结构(BVH),用来快速判断光线和场景中哪个三角形相交。静态场景下这套机制工作得很好,问题出在动态内容上:角色动画、几何体流式加载、成片被破坏的物体,都会让已有结构频繁失效,引擎只能反复重建,开销大时甚至能拖垮整帧的渲染预算。这正是很多开放世界游戏不敢放开用光追的现实原因之一。
微软这次拿出的方案,是在 DirectX 标准层面给这个问题一个统一答案。据微软 DirectX 开发者博客的说明,工程团队把这次更新称为 DXR 亮相八年来最显著的一次进化,国内科技媒体和海外科技媒体也都在第一时间做了跟进报道。由于改动发生在 API 标准里而不是某家显卡的私有技术里,AMD、英伟达、英特尔的开发者都能通过同一套接口用上这些新能力,这一点对 Windows 游戏生态的长期影响可能比某一项具体特性更大。
集群几何体与分区加速结构:一次讲清三项新特性
第一项是集群几何体。它把 3D 模型拆分成一个个小型集群,每个集群最多容纳 256 个三角形和 256 个顶点,光线追踪的底层加速结构不再直接由原始三角形搭建,而是由这些集群的引用组装而成。几何体发生变化时,开发者只需复用或重建受影响的局部集群,不必推倒整个加速结构重来。配合模板机制,动画网格中与位置无关的预处理工作还能提前完成。对开发者来说,更实际的好处是光栅化和光线追踪可以复用同一套高精度模型,不必再为光追单独制作简化版,反射和阴影与实际画面的匹配度也会随之改善。
第二项是分区顶层加速结构(PTLAS),思路类似但作用在场景级别。传统顶层加速结构要管理整个场景的物体实例,规模一大,哪怕只有少量物体动了,更新开销也不低。PTLAS 允许把场景切成多个分区,只更新发生变化的部分,未变化区域的既有结构原样保留,对开放世界和动态物体密集的场景尤其对症。
第三项是 GPU 驱动的加速结构构建,计算着色器可以直接生成构建参数,CPU 不用再逐帧操心重建调度,进一步减轻处理器侧的负担。这三项功能既可以单独使用,也能组合起来用。当然天下没有免费的午餐:集群几何体不支持局部更新式的 refit,集群内容一变,基于它搭起来的上层结构就得重建;而且新方案在构建过程中对临时显存(scratch)的需求明显上升,微软自己也明确提到了这一点。
66 倍提升是什么场景下的数字
再看大家最关心的性能数据。根据微软公布的 D3D12RaytracingClusteredGeometry 官方示例,在一组采用 AMD Radeon RX 9070 的测试配置中,传统底层加速结构(BLAS)重建方案只能跑到 1.2 FPS,改用集群几何体后提升到 79 FPS,约为原来的 66 倍。细分来看:每帧 GPU 加速结构构建时间从 788 毫秒压缩到 3.11 毫秒,单帧光追渲染耗时从 72.6 毫秒降到 9.27 毫秒,加速结构总显存占用从 7519 MiB 降到 774 MiB,降幅接近九成,其中动态物体加速结构显存更是从 6794 MiB 骤降到 244 MiB,减少约 96%。代价是构建临时显存明显增加,静态部分从 1.83 MiB 涨到 526 MiB。
这里必须泼一盆冷水:66 倍来自一个特定开发示例和特定测试配置,负载特征是海量动态几何需要每帧重建加速结构的极端场景,而不是普通游戏的整体帧率。微软在材料中反复强调,实际收益取决于工作负载、引擎实现方式和 GPU 架构,现有游戏不该被预期获得同等幅度提升。国内科技媒体援引的说法也提到,在实际游戏中这类技术带来的帧率改善通常只有几个百分点,但显存占用的大幅下降是实打实的。另一个 PTLAS 多米诺骨牌演示中,顶层结构构建耗时从每帧 2.88 毫秒降到 0.79 毫秒,光线遍历耗时反而略有增加,说明这类优化牺牲了局部来换取整体吞吐。对普通用户来说,正确的预期是:未来开放世界游戏可以更放心地开光追,显存紧张的中端卡受益可能最明显。
显卡支持范围:老卡也能吃上新特性
支持名单比很多人预想的慷慨。首批范围包括所有英伟达 GeForce RTX 显卡,从最早的 RTX 20 系算起全部在列;AMD 方面目前覆盖 Radeon RX 9000 系列;英特尔则是 Arc B 系列独立显卡以及酷睿 Ultra 200V、300 系列处理器的核显。高通计划在 2027 年上半年为 Snapdragon X2 提供支持。微软明确表示,这些 DXR 新功能不要求 GPU 具备超出既有光线追踪能力的新硬件特性,只要显卡厂商把驱动跟上就能用。
更值得注意的是,英伟达此前在《战争机器:事变日》中使用的 RTX Mega Geometry 技术,正是与这次 DirectX 标准化同源的思路,如今它被收编进 DirectX 标准接口,AMD 和英特尔的开发者也能走统一路径。双方还联合发布了多个示例项目,其中一个覆盖 25 平方公里、包含超过 6000 万株植物的实时路径追踪森林场景,展示的就是这类技术能把光追场景推到多夸张的规模。不过要注意,目前这些功能仍属预览阶段,需要兼容驱动并开启 Windows 开发者模式,对老旧光追显卡的最终支持情况还要看驱动验证结果。
落地节奏与开发者的新工具
时间表方面,集群几何体和 PTLAS 目前通过 Agility SDK 1.722 预览版配合处于预览阶段的 Shader Model 6.10 启用,微软计划让 Shader Model 6.10 随 12 月初发布的 Agility SDK 1.621 正式版转正,完整的光追更新正式商用时间尚未公布。同步发布的 1.620 正式版还带来一批面向开发者的实用更新:高级着色器交付(ASD)技术新增部分图形程序特性,允许在多个渲染管线配置间复用预编译着色器组件,减少着色器包体积和编译开销,不过该特性目前仅支持 AMD Radeon RX 7000 和 RX 9000 系显卡;此外还有 DirectX Dump Files GPU 崩溃诊断、Fence Barriers Tier 1、批量异步命令列表 API,以及面向机器学习工作负载的 DirectX Compute Graph Compiler 运行时接口。
对玩家来说,接下来真正值得关注的是引擎适配进度。开放世界、大规模破坏、密集动画正是光追至今没啃干净的硬骨头,也是这套新特性收益最大的方向,一旦主流商用引擎跟进,光追在 PC 游戏里的普及速度可能明显加快。
网友评论
- 「显存从 7 个多 G 降到不到 1 个 G 这个最实在,中端卡是不是终于敢开光追了?」
- 「66 倍听着唬人,起点可是 1.2 FPS 的极端场景,等真实游戏实测再高潮也不迟。」
- 「RTX 2080 老用户举手:要是驱动真放开了,是不是还能再战两年光追?」
- 「别最后变成开发者仓库里的demo特性,引擎适配等个两三年,希望这次节奏快点。」
总结
这次 DirectX 光追大升级的真正意义,不在于 66 倍这个吸睛数字,而在于微软把各家私有的几何加速思路统一进了 Windows 图形标准,并且不设硬件门槛,从 RTX 20 系到 RX 9000 都能沾光。技术方向是对的,剩下的悬念交给驱动成熟度和引擎适配速度。对普通用户来说,既不用急着为此换卡,也可以对两年内光追游戏的表现多一分期待:显存占用降九成这件事,总有一天会变成你能直接感受到的那一帧流畅。
