英伟达又给了 DGX Spark 一个新的入门选项。这台被戏称为「桌面小超算」的机器,原来只有 128GB 统一内存一个配置,现在多了一个 64GB 版本,起售价 4999 美元,10 月 23 日开卖。
先看清楚:卖的是哪台、什么时候、多少钱
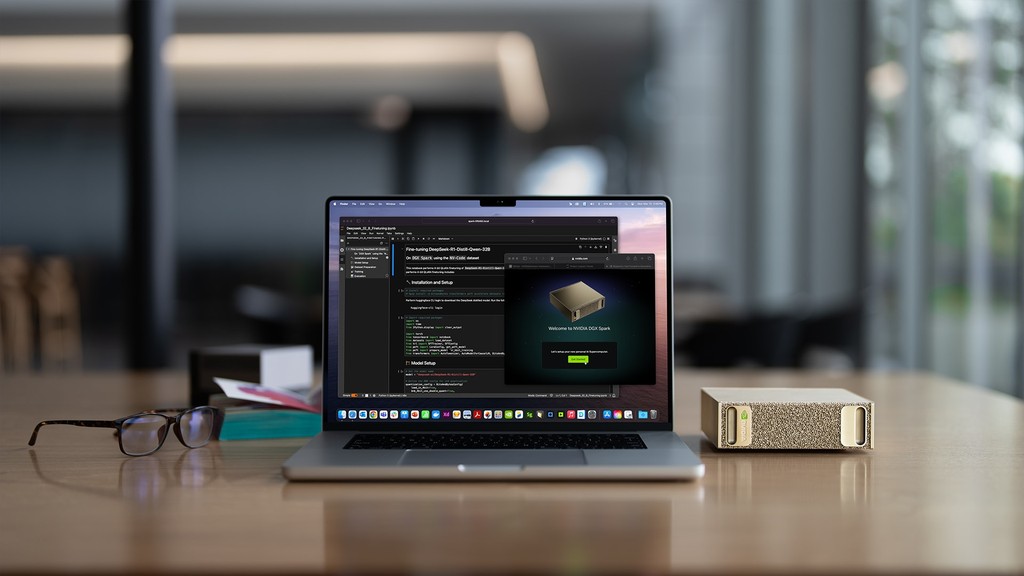
新版本定在 10 月 23 日上架,走的是 OEM 渠道,首发阵容包括宏碁、华硕、戴尔、技嘉、惠普和微星六家。起售价 4999 美元,最终价格由各家根据搭配的固态硬盘容量浮动,高配会贵一些。
有一点要提前讲清楚:这个 64GB 版本没有英伟达自己的 Founders Edition,英伟达品牌的那台机器仍然只做 128GB。也就是说,想买 64GB,只能从上面六家里挑。
与此同时,原来那台 128GB 的口径也变了。它 2025 年 10 月上市时定价 3999 美元,2026 年 2 月涨到 4699 美元,现在官方渠道的标价已经是 6950 美元,并且在英伟达美国商城上显示缺货。把两个数字放一起看会更直观:新的 64GB 入门款卖 4999 美元,比当年 128GB 的首发价还高出四分之一。
硬件一点没砍,砍的只是内存
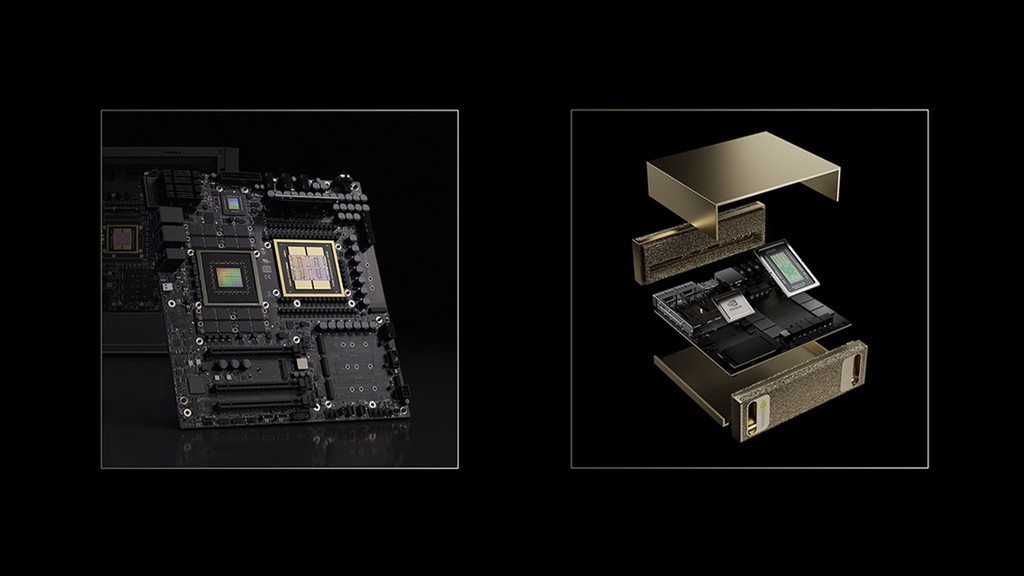
这是这次发布里最值得注意的一点。64GB 版本用的还是那颗 GB10 Grace Blackwell 超级芯片,CPU 部分同样是 20 核 Arm 架构(与联发科联合设计),网络部分是同样的 ConnectX-7,带宽 200GbE,算力同样是每台最高 1 PFLOPS,内存带宽都是 273GB/s。
换句话说,英伟达没有为便宜档单独做一颗缩水芯片,而是用同一颗芯片、焊了更少的内存。会这么干,本身就说明了一件事:这一代的瓶颈不在算力,而在内存。行业里的说法也很一致——LPDDR5X 的产能增长赶不上需求,有厂商公开表示 2027 年的内存供应已经订出去约四分之三。存储侧同样如此,NAND 涨价幅度也很大。DGX Spark 这种靠大块统一内存吃饭的机器,成本压力最先反映在价签上。
64GB 里并不是全部都能拿来跑模型。按各家实测口径,大约有 56GB 可以分给模型权重和 KV 缓存,剩下 8GB 留给系统和日常运行。这个划分很关键,它决定了你实际能跑多大的模型。
单机能力:大概能装下什么规模的模型
按英伟达给出的口径,单台 64GB 的 DGX Spark 可以在本机跑最高约 800 亿到 1000 亿参数的模型,具体上限看量化和精度。这个量级听起来不惊人,但已经覆盖了目前开源生态里相当大一部分中等规模的模型——从主流的推理模型到不需要前沿级参数量的多模态模型,基本都在范围内。
软件栈是原样搬过来的:DGX OS、CUDA-X 库、英伟达自家的 Agent Toolkit 与 Nemotron 开源模型都预装好了,常用的 Ollama、vLLM、PyTorch(CUDA 版)也都在,llama.cpp、LM Studio 这类推理框架同样支持。官方还提到,针对这个平台预编译的 Blender 安装包很快会放出来。对想上手本地 AI 开发的人来说,这套预配置省掉的是最烦人的环境搭建环节。
当然,64GB 的天花板也确实存在。如果你要跑的是需要完整 128GB 的高精度大模型,或者想同时挂好几个模型做多智能体流水线,那 64GB 就很吃紧,得靠更激进的量化或者把部分计算挪出去。
两台拼一起:这才是 64GB 版本的真正卖点
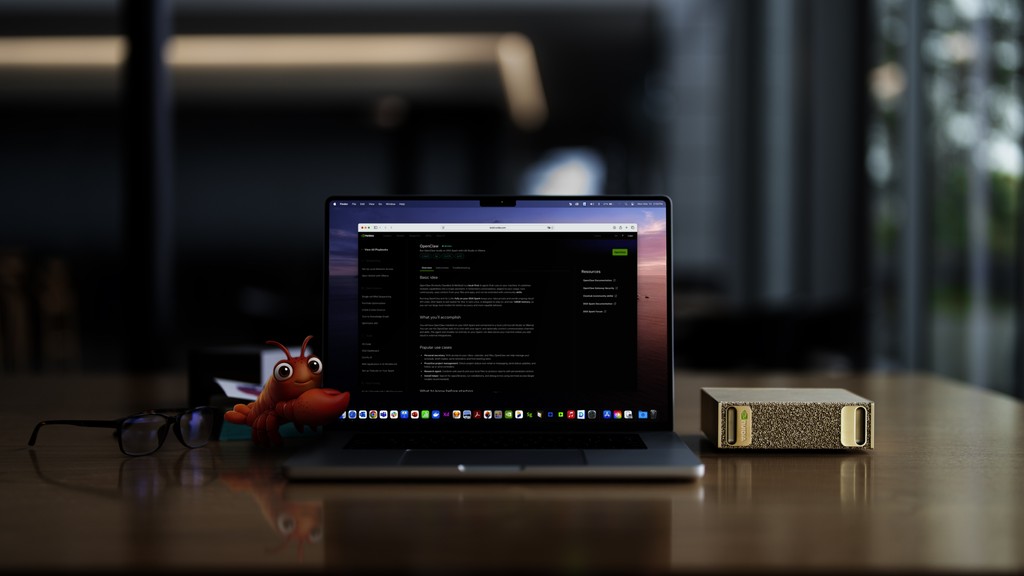
英伟达给这个版本配的叙事是「先买一台,不够再加一台」。每台 DGX Spark 都自带 ConnectX-7 网口,两台之间用一根 QSFP 线直连,就能把统一内存合并成一个 128GB 的内存池,支持到最高约 2000 亿参数的模型。如果加上交换机,最多能连到四台。
把这套流程跑通的是英伟达 Sync 里的 Cluster Assistant。它会自动检测连上的机器、校验每台的配置,然后配好 ConnectX-7 网络,两台机器上跑的是同一套软件栈,所以你从单机扩到双机,不需要重新折腾一遍环境。
性能上,英伟达自己用 Qwen 3.8 27B 做的测试里,两台 64GB 拼起来能跑到单台的 1.7 倍,也比单台 128GB 高出约七成。另外官方预告月底还会推出 Sync 的 Model Launcher,可以在单机或集群上一键下载并启动模型,并把模型配置成跨设备运行、从笔记本就能访问,同时准备好 OpenCode 让开发者在浏览器里直接写代码。
有个坑得提醒:虽然官方说 64GB 和 128GB 可以混着连,但因为机器的设计方式,混连时整个集群会被限制在 64GB。所以已经有一台 128GB 的人,再加 64GB 并不是一个好主意。
它适合谁,不适合谁
- 适合:个人开发者、小团队、研究者,想在本机做原型验证和微调,不想每次任务都去云端租 GPU。
- 适合:需要常年开机跑本地智能体的场景——统一内存设计在每瓦 token 产出上效率更高,这也是它被反复提到的优势。
- 不适合:要做前沿级开源模型全精度微调的团队,128GB 版本依然是唯一选择。
- 要想清楚:本地化不等于便宜。4999 美元是入场费,而且是在内存行情高位上定的价。
把 64GB 版本放到整个市场里看,它的意义不在参数表,而在于英伟达终于给出了一个「先买一台试试」的台阶。云端 GPU 一卡难求的行情下,把模型装回桌面的选项又厚了一点——虽然这个「桌面」依然不便宜。
