下一代AI计算平台Vera Rubin的规格调整,这次终于有了官方说法。此前有国内科技媒体通过网页历史存档对比发现,英伟达已经在官网和架构资料中悄悄修改了Vera Rubin的多项技术参数,其中最受关注的HBM4显存带宽和第六代NVLink互联带宽均出现明显下调,消息传出后不少等着部署新机架的用户心里都打了个问号。当地时间10月29日,英伟达正式作出回应,称研发阶段公布的是初步架构目标,官网与产品数据手册上的参数,才是经过认证、能够在量产系统中持续实现的最终规格。
官方回应:初步目标不等于量产规格
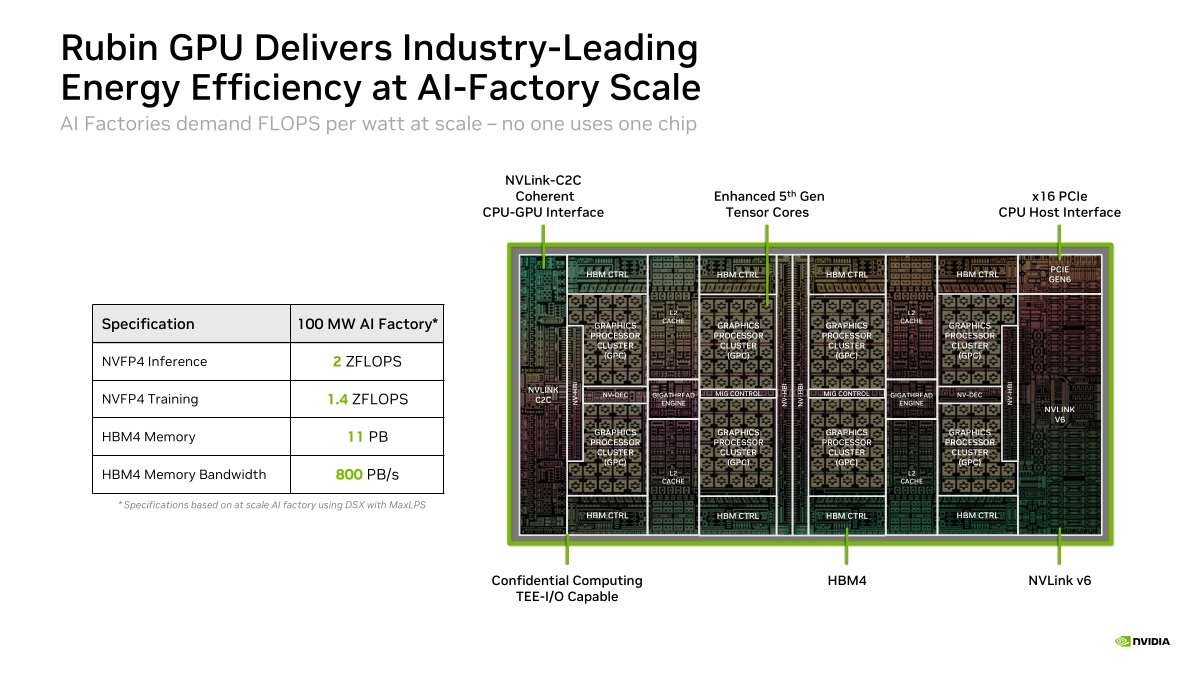
按照英伟达方面的说法,这次调整并不意味着实际应用性能下降。公司特别强调,过去几个月已经公开的Vera Rubin第三方基准测试,采用的就是当前量产规格,与现在正在出货的产品保持一致,所以此前公布的第三方测试结果不会因为这次参数更新而失效。英伟达还披露,Vera Rubin NVL72目前已经全面投产并开始对外发货,首批系统已经进入多家云厂商的数据中心。
单卡到机架:这轮到底改了哪些数字
回顾今年早些时候的GTC 2026大会,英伟达首次公布Vera Rubin平台时,宣传每颗Rubin GPU配备288GB HBM4显存,带宽达到22TB/s,同时支持3.6TB/s的第六代NVLink互联带宽。而在最新公布的规格表中,显存容量维持288GB不变,带宽却下调至19.2TB/s,降幅约12.7%;NVLink带宽降至3TB/s,降幅约16.7%。算力方面,NVFP4推理50 PFLOPS的数字保持不变。
这一变化还逐级放大到了系统层面。Vera Rubin Superchip的HBM4带宽由44TB/s调整为38.5TB/s,NVLink带宽由7.2TB/s调整为6TB/s。规模更大的Vera Rubin NVL72机架,HBM4总带宽从1580TB/s调整至1400TB/s,降幅约11.4%;机架NVLink总带宽则从260TB/s调整为216TB/s,降幅约17%。
NVL8版本受影响最大:总带宽少了26%
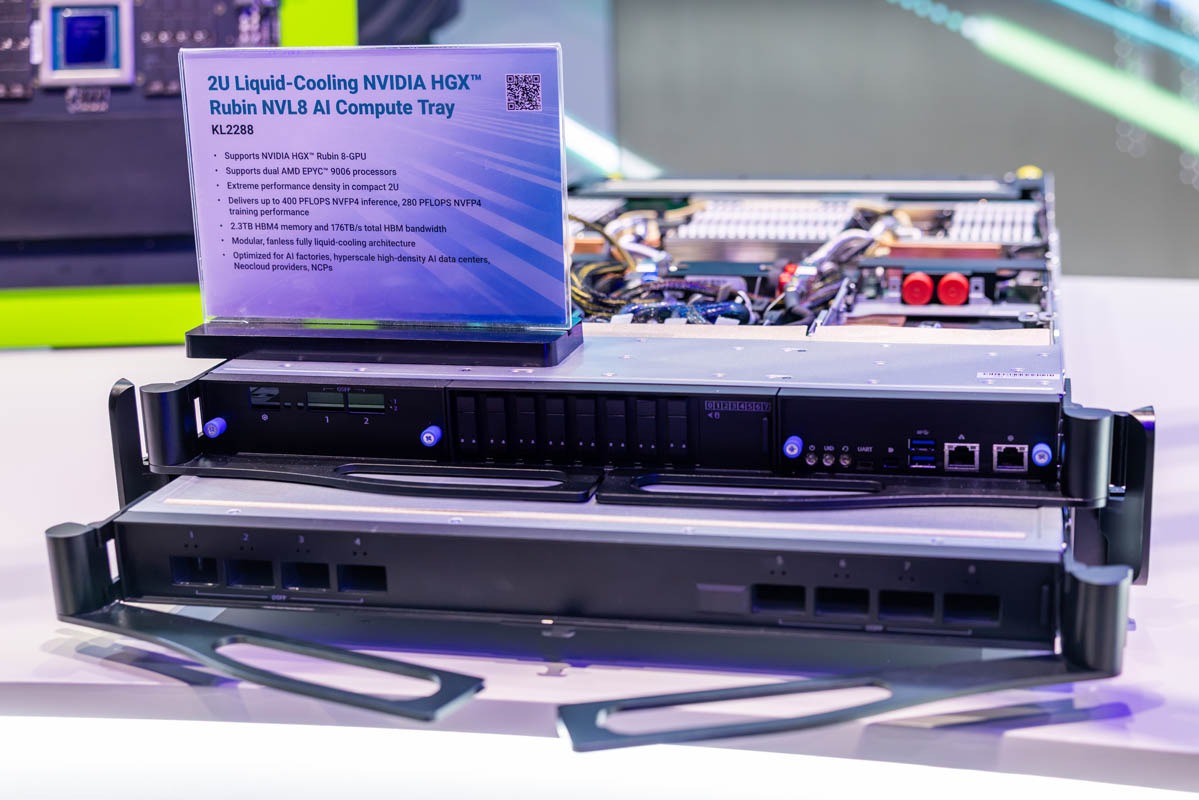
整个产品线里,HGX Rubin NVL8的变动最扎眼。这个在x86服务器中通过NVLink连接8颗Rubin GPU的配置,HBM4总容量从2.3TB缩减至2TB,少了300GB;总带宽从176TB/s直接降到130TB/s,降幅约26.1%;NVFP4训练算力也从280 PFLOPS微降至270 PFLOPS。对普通用户来说,可以把它理解成单卡规格小幅下调、多卡组合后账面数字被成倍放大的典型情况。
从底层看,这次变化主要出在传输速率而不是容量上。按8颗HBM4堆栈计算,22TB/s的目标约等于每引脚10.75Gbps,下调后的19.2TB/s约为9.375Gbps,相当于每引脚少了1.375Gbps。有意思的是,即便下调,英伟达的HBM4速率仍明显高于JEDEC官方8Gbps的标准,也高于竞品AMD MI455X采用的每引脚7.6Gbps。至于下调的具体原因,官方没有说明,业内有推测认为可能与内存控制器、HBM4堆栈速率或良率有关,这部分还属于未经证实的分析。
对外网络带宽反而涨了12.5%
值得注意的是,英伟达并非所有指标都在往下调。Vera Rubin NVL72机架的对外网络带宽从28.8TB/s增加至32.4TB/s,提升约12.5%,摊到每颗Rubin GPU上,横向扩展网络带宽从400GB/s提升到450GB/s。一边是机架内部互联和显存带宽收敛,一边是机架之间的网络加强,这个取舍组合指向的很明确:智能体AI的一项任务可能需要反复推理、调用工具、检索信息再评估结果,整个过程涉及大量跨机架的数据搬运,把预算从纵向堆料挪到机架间横向扩展上,是面向这类负载的系统级设计选择。
从架构目标到量产规格,该怎么理解
英伟达给出的核心解释是:单个组件的规格并不能直接决定最终应用性能。Vera Rubin是专门面向智能体AI设计的平台,性能不是由某一颗芯片单独决定,而是取决于模型、软件、计算、网络和内存之间的深度协同。官方建议客户参考AgentX与SemiAnalysis合作、AgentPerf与Artificial Analysis合作发布的第三方测试结果,通过具体AI模型和真实智能体部署场景下的帕累托性能来评估平台,而不是只盯着某一项硬件参数。作为参照,英伟达表示与上一代GB300 NVL72相比,Vera Rubin在相关智能体AI工作负载下每瓦性能提升30倍,每美元能够获得的Token数量也提升30倍。
客观来看,服务器芯片在量产前调整规格在行业里并不少见,英伟达此前公布的初步规格也注明过数值可能调整。但这次的特殊之处在于,参数修改恰好落在量产出货的节点上,修改后的数字描述的是正在下线的硬件,而不是路线图。对那些按早期架构目标做容量规划和预算测算的数据中心来说,实际性能与预期之间可能出现差距,受影响程度取决于具体负载对显存带宽和互联带宽的敏感度。HBM4本身的供货能力,也正在成为高端AI芯片的现实约束之一。
网友评论
- 砍完还是比AMD高,这波操作属于是先给自己留后路,等对手追上来再说。
- 规划的时候22TB/s,到手19.2TB/s,就像手机续航标称和实际的区别,习惯了。
- 对外网络带宽还涨了12.5%,说明英伟达心里清楚智能体AI的瓶颈在机架外面,不在里面。
- 每瓦性能提升30倍这种数字听听就好,等第三方实测出来再喊真香也不迟。
- 就是不知道已经下单的客户能不能按新规格重签,砍了300GB显存这事儿得有个说法吧。
总结
Vera Rubin这轮规格调整,本质上是从研发阶段的架构目标切换到量产系统的真实交付值:单卡HBM4带宽降12.7%,NVLink降约17%,NVL8总带宽降26.1%,对外网络带宽却提升12.5%。英伟达想传达的信息很直接——评价这套平台要看量产系统在真实智能体AI负载下的综合表现,而不是单颗芯片的账面参数。数字当然要较真,但对普通用户和企业客户来说,最终决定体验的还是那些已经投产、正在跑真实业务的机架,答案要交给接下来的第三方实测来验证。
